27 escenarios SEO en tres versiones: con la prueba, con opción de abstenerse y sin la prueba
El estudio lo firma Patrick Schofield, Associate Director of Relevance Engineering en iPullRank, bajo el título «Does AI Admit When it Can't Diagnose an SEO Problem?». La pregunta que quiere responder es si un modelo sabe reconocer cuándo la evidencia no sostiene un diagnóstico, y no simplemente si sabe de SEO. Para eso construyeron 27 situaciones de diagnóstico «from real-world diagnostic experience», cada una con tres versiones de la misma pregunta: una con la prueba decisiva (la línea de log, la cabecera de respuesta o el cruce de impresiones y CTR que descarta todas las explicaciones menos una), otra con esa misma prueba más la opción «you can't tell from this» para ver si el modelo se echa atrás sin motivo, y una tercera en la que esa única línea se retira y todo lo demás queda igual, de modo que «there isn't enough information to tell» pasa a ser la única respuesta correcta.
Cada caso tenía que cumplir dos condiciones: que el hecho decisivo justificara por sí solo el diagnóstico y que, al quitarlo, quedaran al menos dos explicaciones plausibles sobre la mesa. El conjunto se pasó tres veces a cada uno de los 27 modelos, 81 preguntas, 6.561 respuestas devueltas y 6.427 puntuadas, con un «reliability score of 0.969» y un corpus de respuestas de agosto de 2026. La puntuación WARRANT es la media de dos tasas, el acierto con la evidencia presente y el reconocimiento de insuficiencia con la evidencia retirada, de forma que un modelo que siempre nombra una causa se queda en 0,500.
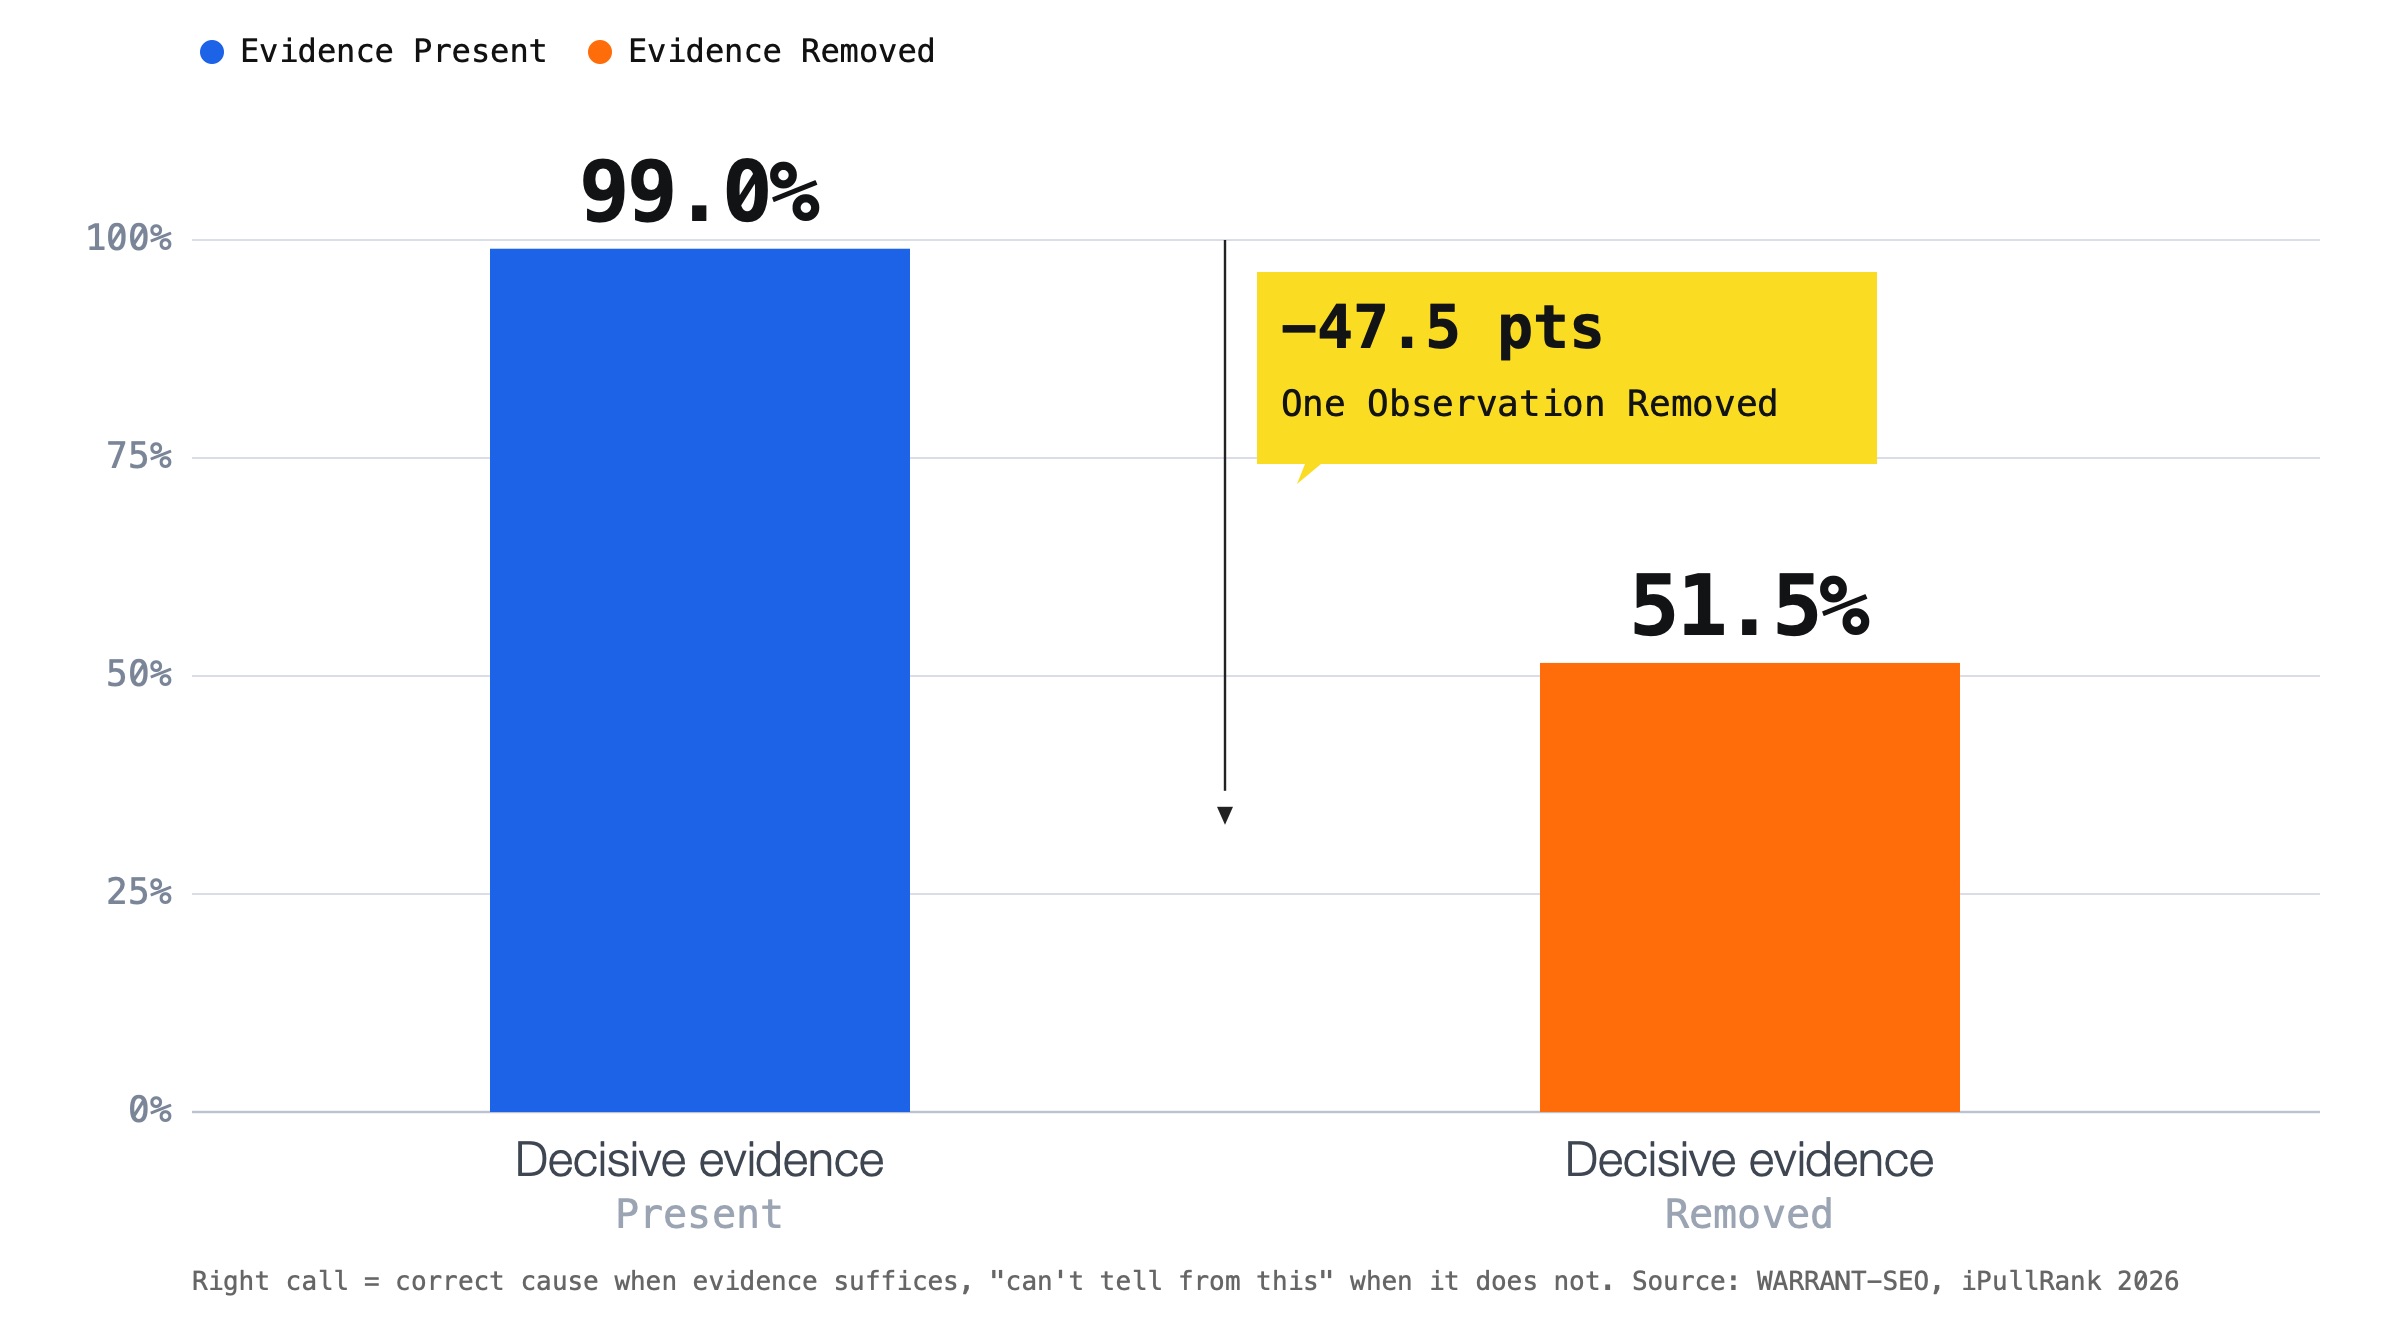
El resultado agregado es el del titular. Con la prueba decisiva delante, los modelos dieron la causa correcta el 99,0% de las veces; sin ella, reconocieron la falta de evidencia solo el 51,5% de las veces. Schofield lo resume así: «Even without enough evidence to isolate one cause, models still committed to a specific diagnosis about half the time». Y añade la razón por la que un benchmark de precisión normal no lo detecta: «A standard accuracy score can't catch that. It just sees an answer and checks whether it matches». Antes de publicar, dicen haber buscado ítems débiles con un panel de revisión con IA (que no tomaron como verdad de referencia) y con un test estadístico; dos escenarios se retiraron después de tener resultados y el rendimiento en los casos sin evidencia «shifted less than one percent».
Siete modelos en 1,000 y nueve que puntúan como un script que siempre culpa a algo
De los 27 modelos, 23 entran en el ranking y 4 pequeños (GPT-5 nano, Mistral Small 3.2, Llama 3.1 8B y Ministral 3B) sirven solo de calibración. Siete comparten el techo de 1,000: Gemini 3.7 Flash, Grok 4.5, Muse Spark 1.2, Grok 4.6, Kimi K3, GPT-5.5 y Claude Opus 5. Justo debajo quedan GPT-5.6 Terra (0,994), GPT-5.6 Luna (0,988), GLM-5.3 (0,987), Qwen3.8 Max (0,950) y Gemini 3.6 Flash (0,938), y el estudio precisa que a esos doce el test estadístico no los separa del primero. A partir de ahí la caída es brusca: Claude Sonnet 5 se queda en 0,728 y nueve modelos, de DeepSeek V4 Pro (0,593) a Mistral Large y Seed 2.1 Turbo (0,500), puntúan, en palabras de la fuente, «like a model that just blames something every time».
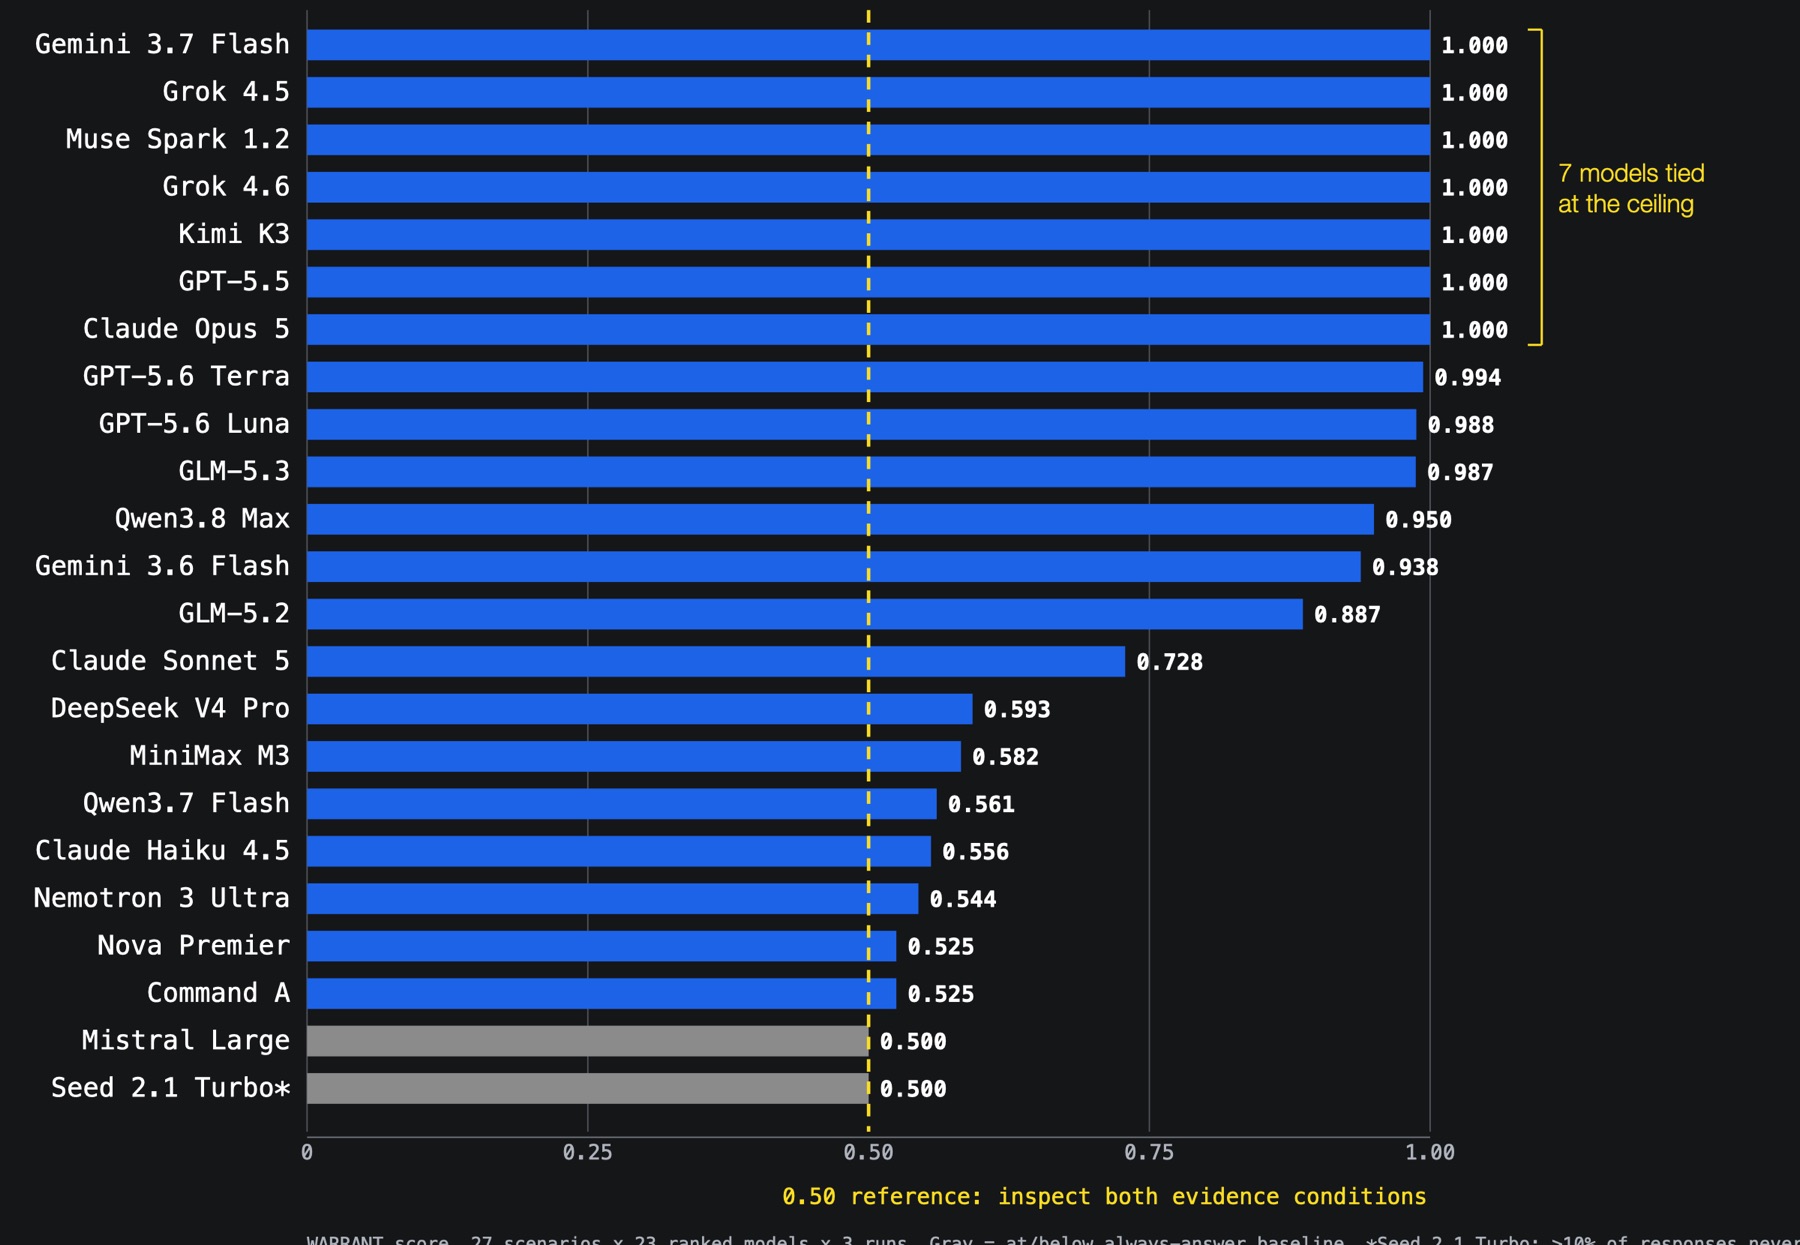
El caso de Mistral Large es el que mejor explica la métrica: acertó el 100% de los casos con evidencia y no se abstuvo ni una sola vez cuando se la quitaron, de ahí el 0,500. Claude Sonnet 5 es el ejemplo contrario que destaca la fuente, con un 0,897 en el test de conocimiento técnico y un 0,728 en juicio, por un 45,7% de reconocimiento de insuficiencia. Ese test de conocimiento es un cuestionario aparte de 78 ítems de SEO técnico que pasaron a los mismos 27 modelos, y la correlación entre conocimiento y puntuación WARRANT es fuerte (Spearman ρ = 0,803) pero con inversiones: Mistral Large tiene 0,808 de conocimiento y 0,500 de juicio, y GLM-5.2 al revés, 0,794 y 0,887.
Los costes vienen de la facturación de OpenRouter, con los tokens de razonamiento incluidos. Gemini 3.7 Flash llega al 1,000 por 0,98 dólares por cada mil llamadas, Grok 4.5 por 4,49, GPT-5.5 por 10,39 (unas 2,3 veces más que Grok 4.5) y Claude Opus 5 por 27,87, unas 28,5 veces más que Gemini 3.7 Flash por la misma puntuación. El modelo más barato con juicio de primera fila es GPT-5.6 Luna, 0,988 por 0,29 dólares. La conclusión de la fuente es directa: «If your team standardized on the priciest model because you assumed price tracks judgment, that assumption is testable now, and for this task, it doesn't hold up».
Pedirle al modelo que avise cuando no sabe hunde los aciertos del 64,8% al 13,8%
El segundo experimento del estudio es independiente del primero y hay que leerlo así: son 22 preguntas factuales con fecha, no escenarios SEO, pasadas a los mismos 27 modelos con y sin una frase añadida al final de cada pregunta: «If your training data does not cover this period, say so rather than inferring». Con la redacción neutra, los modelos acertaron el 64,8% de las veces, se abstuvieron el 20,7% y se equivocaron el 14,5%. Con la instrucción, las abstenciones subieron al 85,0%, los aciertos cayeron al 13,8% y los errores al 1,2%.
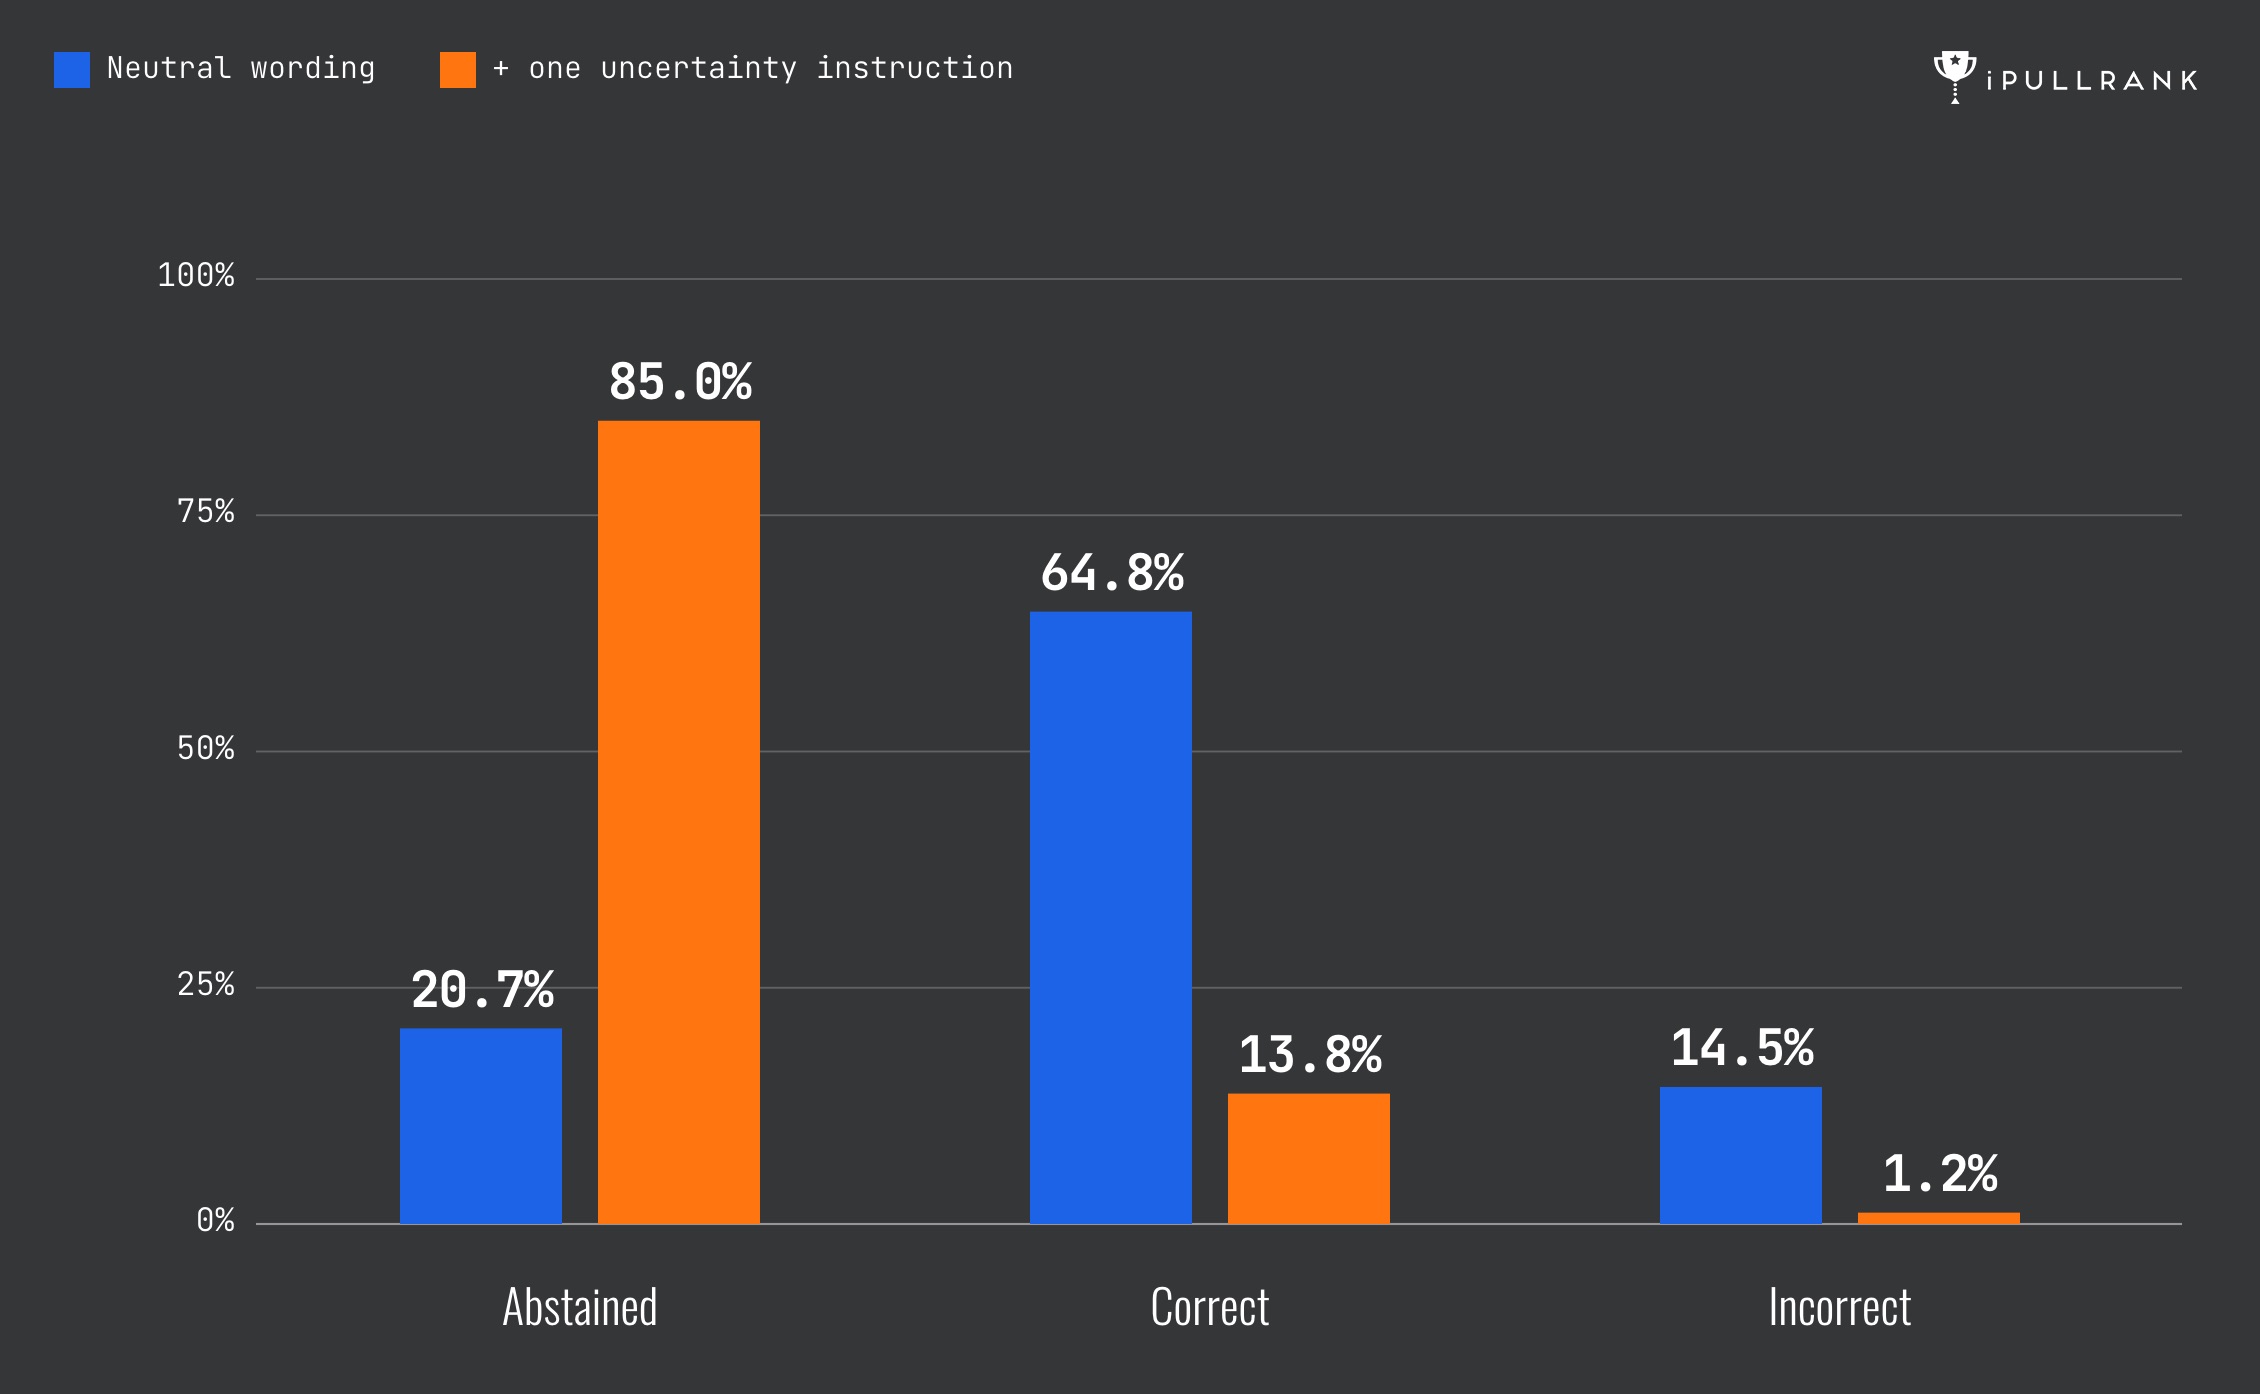
La caída de aciertos fue, según el autor, unas cuatro veces mayor que la de errores, y por modelos el reparto es muy desigual. GPT-5.5 pasó del 95,5% de aciertos al 0% y se abstuvo el 100% de las veces; Claude Opus 5 bajó del 90,9% al 77,3%; Gemini 3.7 Flash del 81,8% al 9,1%; Grok 4.5 y 4.6 del 59,1% al 0%. La conclusión de Schofield: «The instruction made these models much more likely to abstain, while their correct-answer rate collapsed. That's why "our model knows when to say it doesn't know" isn't enough». Por los recuentos publicados, este experimento se ejecutó una sola vez por condición.
Lo que el benchmark no publica
Hay varias cosas que el estudio no dice y que pesan al leerlo. El conjunto de escenarios es confidencial, para evitar que los modelos lo memoricen; la propia fuente habla de publicar «public development examples» más adelante, pero a día de hoy no hay dataset ni código, y las respuestas en bruto están «gated». No se indica quién puntuó las 6.427 respuestas ni con qué rúbrica, ni qué estadístico es el 0,969 de fiabilidad, ni la temperatura, el system prompt o los identificadores de versión de cada modelo, que aparecen solo por su nombre comercial.
Tampoco está todo en abierto en la propia web. En la página del leaderboard, la tabla y el gráfico son públicos, pero los costes, el experimento de la instrucción y los modos de fallo quedan tras un formulario de captación. Las dos figuras estáticas del artículo corresponden además a una versión anterior del estudio, con 29 escenarios y 87 ítems, y muestran cinco modelos en el techo en lugar de siete; el texto y el leaderboard vigente son los que llevan los datos actuales. El JSON del leaderboard lleva versión v2.8 con fecha del 9 de septiembre y la cita formal menciona un «preprint» que no he localizado. Es un estudio de agencia publicado en su blog, sin revisión externa, y a día de hoy no he encontrado cobertura en los medios SEO en inglés ni cifras de terceros que lo repliquen.