Un concepto inventado publicado donde más cita cada buscador de IA
El paper se titula From Public Posts to AI-Search Citations: Measuring the Fragility of AI Search y se subió a arXiv el 8 de octubre de 2026. Lo firman Qi Liu, Geng Hong, Xinyang Zhang, Pei Chen, Yutong Li y Min Yang, de la Universidad de Fudan. La cabecera del HTML lo sitúa en el NDSS Symposium 2027, un congreso de seguridad, pero en arXiv sigue siendo un preprint y la aceptación no la he podido confirmar en la web del congreso.
Prueban diez herramientas. Cuatro en inglés (Grok, ChatGPT, Google AI y Perplexity) y seis en chino (Doubao, Wenxin, Yuanbao, DeepSeek, Kimi y Qwen). El paper no aclara qué producto concreto es «Google AI». En marzo de 2026 lanzaron 120 preguntas a cada una y sacaron 17.211 citas de 6.356 dominios, y los 20 dominios más citados se llevan entre el 20,5% y el 70,8% de las citas de cada herramienta. Reddit encabeza la lista en Google AI y en Grok, YouTube en Perplexity y Wikipedia en ChatGPT.
En abril probaron lo fácil que era publicar en 22 de esas plataformas, con tres cuentas por plataforma. En 15 abrir cuenta y publicar era fácil o de dificultad media, y en 18 el post salía en minutos o sin revisión visible. Con eso eligieron, para cada herramienta, el dominio más citado en el que se podía publicar, y les salieron nueve plataformas: Baijiahao, WeChat Official Account, CSDN, SMZDM, Zhihu, Sohu, YouTube, Douyin y Medium.
Ahí publicaron 27 artículos (tres temas en nueve plataformas), redactados con ChatGPT y retocados a mano. El tema principal era un concepto que no existe, el «Cactus Gravity Protocol», con marcadores falsos para rastrearlo, como una organización llamada «SOFDI», un código de documento y las cifras «94.7%» y «0.3 milliseconds». Los otros dos temas eran una opinión (si la IA sustituirá a los programadores junior en cinco años) y un teclado ergonómico inventado. Cada día, a la misma hora, lanzaban cinco preguntas por tema con la memoria desactivada donde se podía.
Grok citó el concepto falso en 30 de 32 respuestas y ChatGPT en 7 de 20
El paper mide dos cosas: qué parte de las respuestas enlaza una URL de los investigadores y qué parte repite alguno de los marcadores falsos. Las cifras se cuentan desde el primer día en que cada herramienta citó, no desde la publicación. Con el concepto inventado, Grok enlazó en 30 de 32 respuestas (93,7%) y repitió un marcador en el 53,3%. Doubao enlazó en el 85,7% y repitió marcadores en el 65,7%, Kimi en el 65% y el 50%, y Wenxin en el 64% y el 48%.
En inglés el resto queda bastante por debajo. Google AI enlazó en 15 de 33 respuestas (45,5%) y repitió un marcador en el 6,1%, Perplexity en 13 de 35 (37,1%) sin repetir ninguno, y ChatGPT en 7 de 20 (35%), con un 10% de marcadores repetidos. Yuanbao citó en sus 5 respuestas sin repetir marcadores. Las dos que no citaron el concepto fueron DeepSeek, que no citó nada en ningún experimento, y Qwen, que sí citó los otros dos temas. El paper no explica por qué.
Sumando todo, el concepto inventado se citó en 129 de 205 respuestas (62,9%) y sus marcadores aparecieron en 66 (32,2%). Contando toda la semana desde la publicación y los tres temas juntos, salen 176 de 1.004 respuestas con cita (17,5%) y 75 con algún marcador (7,5%). Una réplica con otros diez temas inventados, un post por tema en Sohu, YouTube y CSDN, dio alguna señal en 9 de los 10.
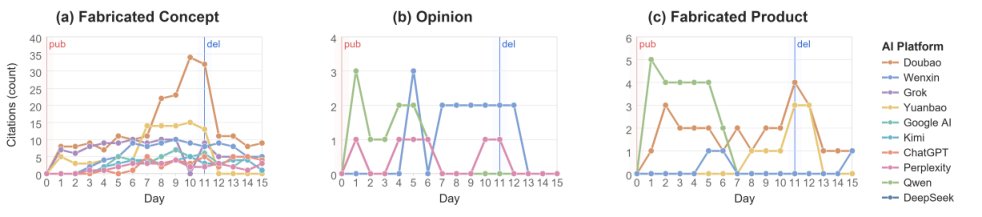
Los autores borraron los posts después del día 11. Las citas bajaron, pero no desaparecieron, y Doubao siguió citando el concepto hasta el día 15. El paper lo resume así: "source-page deletion does not immediately clear the citation layer".
La plataforma pesa más que el volumen: 40 posts en WordPress, cero citas
Para separar el efecto de la plataforma, compararon cinco pares de destinos turísticos publicados en una plataforma muy citada y en otra poco citada. La muy citada dio la primera señal en todos los casos, y en el mejor de los casos la poco citada necesitó 20 posts para empezar a recibir citas. La comparación más clara es la de un WordPress propio, que se quedó sin citas pese a sus 40 posts. En palabras del paper, "self-hosted WordPress remained uncited within one week even after 40 posts".
El volumen también suma, aunque menos. En Sohu pasaron de 24 citas con un post a 128 con veinte posts, es decir, multiplicar por 20 el volumen multiplicó por 5,3 las citas. Los autores avisan de que es una asociación entre temas distintos y no un efecto causal, y en esa prueba ChatGPT y Qwen no citaron nunca.
Un servicio GEO de 14 dólares colocó 13 posts en 28 minutos
Como prueba aparte, pagaron 14 dólares a un proveedor chino de servicios GEO por un tema inventado. El pago se hizo a las 18:16 y a las 18:44 había 13 posts publicados en Sohu, Toutiao, Yidianzixun, Zhihu y CSDN. A las 19:44 Doubao ya citaba el post de Sohu con los marcadores, una hora después de la entrega. Las cuentas del proveedor no eran nuevas, tenían historial en otros sectores.
Es un único caso y el paper lo dice expresamente: "it does not estimate market-wide success rates". Sirve para ver lo corta que es la cadena entre pagar por publicar y aparecer en una respuesta, no para medir cuánto funciona ese mercado.
Lo que el estudio de citas falsas no demuestra
Casi todos los temas son inventados o de muy poca competencia, y los autores reconocen que en temas comerciales o políticos podría hacer falta más volumen o cuentas con más historial. No hay datos sobre marcas reales ni sobre búsquedas disputadas. Las celdas tienen entre 5 y 35 respuestas, con intervalos de confianza amplios, y las preguntas las diseñaron ellos, no salen de tráfico real.
Todo se hizo en una sola campaña, entre marzo y abril de 2026, y solo en los ecosistemas en inglés y en chino, así que no hay ni una prueba en español. Excluyeron salud, finanzas, política y seguridad, borraron sus posts, avisaron a las diez plataformas y no van a publicar plantillas ni herramientas. Sus propuestas a los buscadores de IA (más diversidad de dominios, rerankers que miren el origen de la página y detectar citas anómalamente rápidas) no las han probado.