SDF, el filtro de obsolescencia de Google Discover, descrito por sus autores
El paper se titula «Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay» y lo firman Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang y Jialu Liu, los seis con afiliación Google LLC. Está en arXiv desde el 16 de agosto de 2026 (2608.15780, única versión hasta hoy) y figura como aceptado en el Applied Research Track de CIKM 2026, que se celebra en Roma del 7 al 11 de noviembre, con licencia CC BY 4.0. Roger Montti lo sacó en Search Engine Journal el 21 de octubre, dos meses después de su publicación, y de ahí viene esta pieza.
El paper describe Discover como «a personalized recommendation feed with hundreds of millions of daily and billions of monthly active users» dentro de la app de Google, y el problema que ataca como «a pervasive challenge and a leading source of user complaints». Distingue dos mecanismos por los que un artículo deja de valer: supersession, cuando una actualización posterior deja obsoleta la cobertura anterior, y relevance decay, cuando el valor informativo se agota solo con el tiempo. A los métodos clásicos los despacha en una frase, «age cutoffs poorly reflect actual relevance loss, while engagement heuristics rely on lagging signals». SDF actúa antes del ranking y elimina, no demota: «The downstream ranker consumes only A, so removed items are never served», donde A es el conjunto de candidatos que el sistema mantiene al día añadiendo lo que llega y quitando lo que caduca.
Otro detalle del diseño es que el filtro no es personalizado. Según el texto, «neither f nor g depends on the requesting user or any context other than time»: las dos puntuaciones se calculan por artículo, fuera de la ruta de la petición, y en el momento de servir el feed solo hay una consulta contra la hora actual, sin inferencia de modelos. El sistema evalúa «millions of new items per day». La consecuencia práctica es que un artículo filtrado desaparece para todos los usuarios a la vez, no para un segmento.
Supersession: cuando una noticia posterior deja obsoleta a la anterior
El primer filtro es un clasificador por pares. Dado un artículo d que ya está en el sistema y uno nuevo d′ del mismo tema, decide si d′ deja obsoleto a d, y basta con un d′ para retirar d. El «mismo tema» lo define el paper como «items sharing the major topic with d (e.g., the same event or entity)», sin aclarar si incluye artículos de otros medios, aunque la definición no lo limita al mismo dominio. Los ejemplos son de manual: «Queen Elizabeth II is under medical supervision» sustituido horas después por la noticia de su fallecimiento, o «Ohtani is weighing offers from multiple teams» superado por su fichaje con los Dodgers. Las previas, los rumores y los «podría» son el objetivo de este filtro.
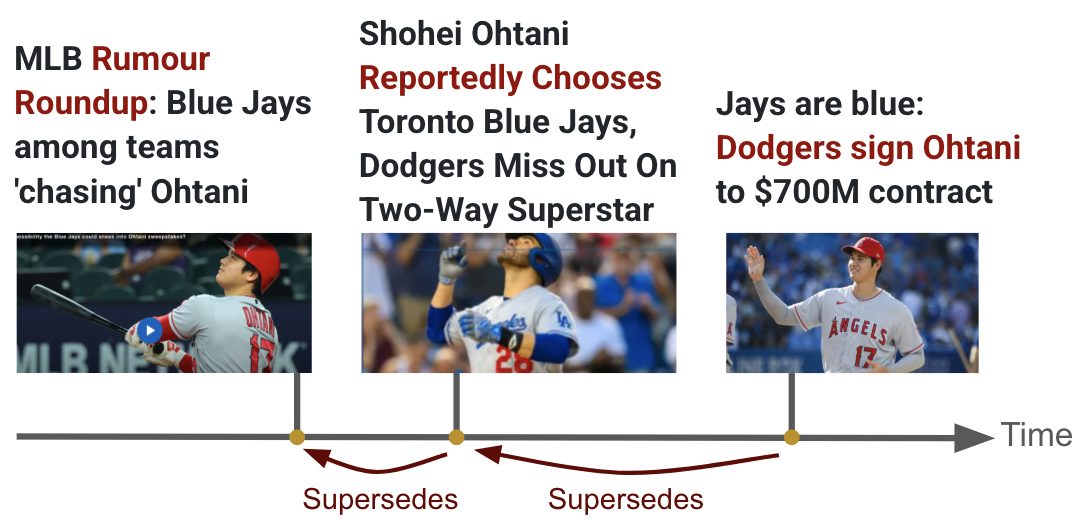
Para entrenarlo no etiquetaron a mano. Usaron PaLM 2-L como modelo profesor con un prompt que el paper reproduce («Given two articles, A and R, while A was published after R, do you think A makes R stale?»), siete respuestas por par con voto mayoritario y un ajuste previo hasta superar el 90% de precisión y de recall en 300 pares anotados por personas. Así salieron 1.100.133 pares etiquetados, con los que destilaron un modelo T5 de 11.000 millones de parámetros entrenado para dar la clase y el razonamiento. En un conjunto de 550 pares reales de Discover revisados por humanos, la configuración desplegada tiene un 83,5% de precisión y un 95% de recall. Dicho de otro modo, se le escapan pocos artículos superados, y de cada seis que marca como superados, uno no lo era según los evaluadores.
El filtro corre en dos modos. Uno en casi tiempo real para los artículos sensibles al tiempo y otro por lotes para la cola larga, que además propaga la etiqueta: «extending a stale label to other items in the same cluster for broader coverage». Es decir, si un artículo del clúster se declara superado, la marca puede extenderse a sus vecinos. Los propios autores reconocen que el juicio por pares es ambiguo en el comentario político, «where content tends to mix opinion and fact and no single item cleanly supersedes another».
Relevance decay: el modelo que predice cuándo se agota el tráfico de un artículo
El segundo filtro no compara con nadie. Un modelo llamado PTR (predicted traffic ratio) estima, solo a partir del contenido, qué fracción del tráfico de toda la vida del artículo se habrá acumulado a las 12 horas, 1, 3, 5, 7, 10 y 14 días de publicarse. La vida completa se mide sobre una ventana fija de 30 días, «which covers the lifespan of most content in Discover», y el artículo sale del conjunto de candidatos cuando la fracción prevista llega al 90%. El umbral de 0,9 lo eligieron entre 0,85, 0,9, 0,95 y 0,98 «to keep precision high with adequate coverage». Los horizontes están alineados, según el paper, con las noticias de última hora a escala de horas, la cobertura diaria a uno o tres días, el contenido semanal a cinco o siete y las piezas de decaimiento lento hasta las dos semanas.
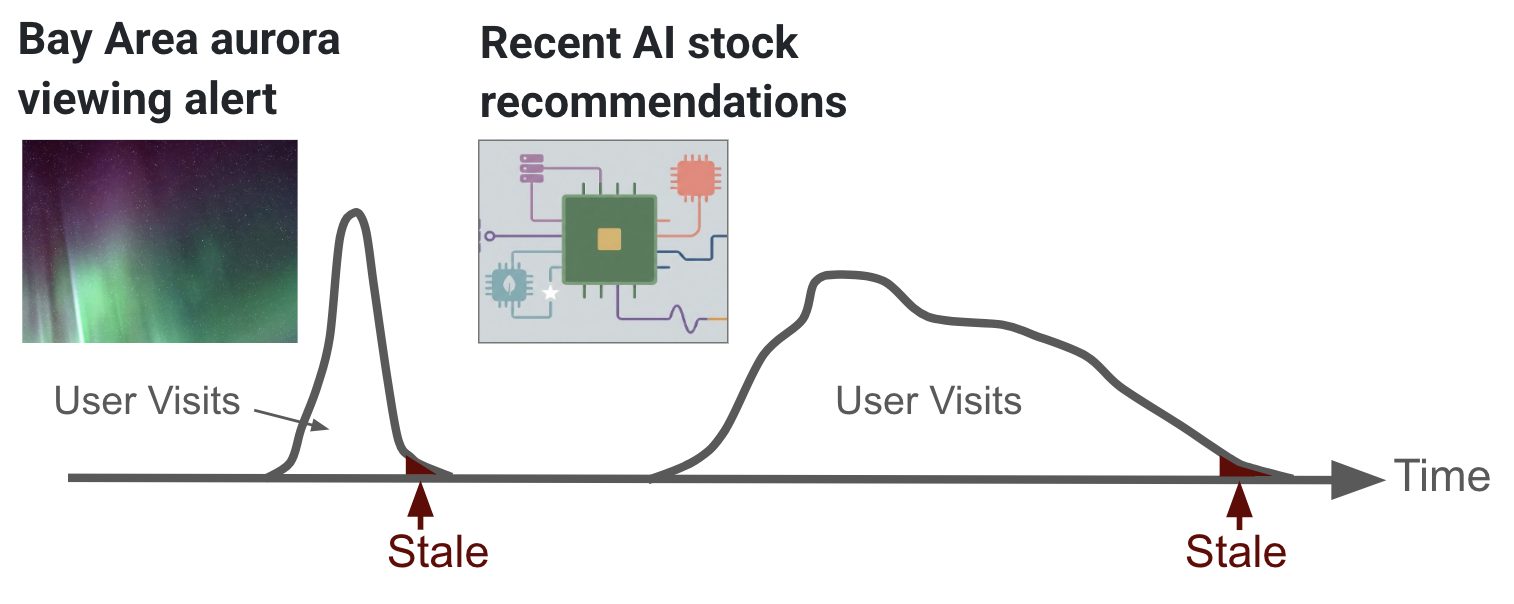
La señal de entrenamiento tiene su miga. El modelo aprende las curvas de vida de los clics en Búsqueda, no de las páginas vistas: «We use search-click logs rather than raw page-view logs. Although the latter are higher-volume, they are biased by publisher promotion». El conjunto de datos abarca varios idiomas y formatos, y la arquitectura es una red multimodal que fusiona texto, imagen y vídeo sobre un backbone interno, con una cabeza por horizonte. Como momento de publicación toma la hora en que el pipeline de indexación anotó el artículo, «closely approximating its publication time». En una clasificación de artículos obsoletos con cinco evaluadores humanos, el F1 va del 78,07% cuando bastan tres de cinco votos al 87,50% con unanimidad.
Los ejemplos de qué cae y qué se queda son concretos. Según el paper, PTR «correctly drops single-day items (Geminid meteor-shower guide) after their event window», «retains multi-day items (Phuket food-festival guide) during their relevance period» y «leaves evergreen items (NYT health-coach explainer) unfiltered». En el apartado de pérdidas admiten que se les escapa una cola larga de contenido que decae despacio, cuya fracción prevista nunca llega al umbral, y que una parte sustancial de los reportes restantes es de contenido que el usuario ya había visto en Discover o en otro sitio, algo que queda fuera de lo que SDF mide.
Lo que mide el 54,9% y lo que el paper no dice
La cifra del titular sale de los reportes que los usuarios envían desde el propio feed eligiendo «stale» en el menú de problemas de calidad, medidos como media móvil de 28 días a lo largo de dos años de despliegue. Comparado con la línea base previa, el total de reportes bajó un 54,9%, los de supersession un 64,0% y los de decay un 34,4%, «each primarily driven by its corresponding filter». Conviene leerlo con su naturaleza: es una comparación antes y después en producción, no un experimento controlado, y el paper dice que esa ventana incluye «successive model upgrades and locale expansion». La gráfica de los reportes (figura 4) no tiene valores en los ejes ni fechas.
Lo que sí es un experimento controlado es más modesto. En un test A/B de cuatro semanas en el primer país donde se desplegó, con cinco evaluadores humanos por artículo y configuraciones ajustadas para no mover el engagement, la prevalencia de contenido obsoleto bajó 6,91 puntos (±2,23) con SDF completo, frente a 0,10 con el método clásico de corte por antigüedad más caída de engagement. En un holdback de dos meses, la tasa de descartes bajó un 0,16%, la diversidad del feed subió un 0,13% y el engagement positivo un 0,26%, todos con intervalos de confianza del 95% que casi tocan el cero. El otro motivo declarado es el coste: el filtro relacional ahorra un 4,76% de horas de CPU y TPU de servicio y el de decay un 3,98% más, medidos en el primer trimestre de 2026.
Y luego está lo que no cuenta. El paper no da las fechas de inicio y fin del despliegue ni qué países e idiomas lo tienen, aunque la mención a la expansión por «locales» indica que no arrancó en todos a la vez; los ejemplos van de septiembre de 2022 a diciembre de 2023 y el ahorro se midió en 2026. No dice qué pasa cuando un medio actualiza un artículo ya marcado como obsoleto, ni trata republicaciones ni fechas de modificación. Tampoco afirma que SDF opere en Búsqueda o en Google News: la única relación con Search es que sus clics alimentan el modelo de decay. La documentación de Discover para editores, actualizada el 9 de marzo de 2026, no usa las palabras «freshness» ni «evergreen» y se limita a decir que «older content may appear if it's helpful and relevant to individuals based on their interests». El paper describe el mecanismo que decide cuándo deja de poder aparecer.
Mi lectura
Si vives de Discover, lo que cambia es cómo lees la caída de un artículo concreto. Un artículo que a los tres días deja de traer tráfico de Discover no ha perdido posiciones, ha dejado de ser candidato, y según el paper eso pasa cuando el modelo calcula que ya se ha llevado el 90% de lo que iba a traer o cuando alguien (tú u otro medio, el paper no lo aclara) ha publicado el desenlace. Las previas y los «podría» caducan solos en cuanto llega la confirmación. Ojo con el detalle de los clics de Búsqueda: la curva de vida que Google aprende para predecir Discover sale de cómo se comporta ese tipo de contenido en Search, así que un formato que en Search dura dos días se va a quedar en Discover dos días aunque lo empujes por redes.
Lo que no te recomiendo es tomar el paper como manual. No dice nada de actualizar artículos para que vuelvan a entrar, ni de porcentajes de evergreen, ni de enlazado interno, y lo que sí dice es que el contenido que decae despacio se le escapa y que lo evergreen pasa sin filtro. Donde sí apoya lo de siempre es en que a la pieza que aporta algo propio (un dato, una declaración, information gain) le cuesta más ser superada, porque el filtro pregunta si A deja obsoleto a R, y un desenlace no deja obsoleto un análisis. Lo que caduca es el contenido que solo valía mientras no se sabía el final.