El botón «Continue» que Google enseña antes de los resultados
Barry Schwartz publicó el 1 de septiembre en Search Engine Roundtable un test que había detectado Glenn Gabe: al hacer una búsqueda, Google intercala una pantalla en blanco antes de los resultados. El texto es escueto: "Verifying your request", y debajo "You'll be able to continue in a few seconds. Don't refresh this page.", con un botón azul de «Continue». En pocas palabras, que está verificando tu petición, que podrás seguir en unos segundos y que no recargues la página. No te pide iniciar sesión ni resolver un captcha: solo te hace esperar.
Gabe aporta un detalle sobre el botón: sale gris y se pone azul unos segundos después, cuando los sistemas de Google dan la petición por buena. Lo contó así: "The 'Continue' button was grayed out for a few seconds before turning blue... Yep, they aren't messing around with scraping... They want humans as much as possible". Su lectura es que Google va en serio contra el scraping y quiere humanos al otro lado. Esa última parte es interpretación suya, y conviene tenerlo presente porque nadie ha verificado qué pasa por dentro durante esos segundos.
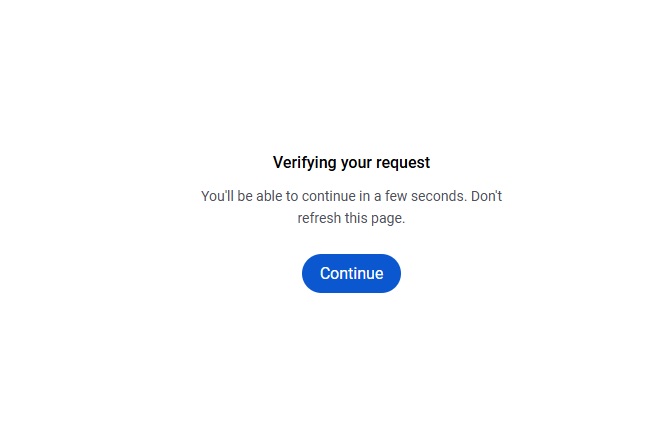
El mismo día, Alexis Rylko lo publicó en francés con dos datos que afinan dónde aparece: "3ème page de Google en navigation privée". Tercera página de resultados y navegación privada, que se parece bastante al patrón de uso de una herramienta y muy poco al de alguien buscando un restaurante.
Google no ha hecho ninguna declaración sobre este test, y el resto de huecos son igual de grandes. Nadie ha cronometrado la espera (Gabe dice "unos segundos" y la propia pantalla dice lo mismo), no hay dato de alcance, ni de países, ni de tipos de búsqueda, y no consta ningún avistamiento en España ni en google.es. Con Rylko en Francia y Gabe en Estados Unidos hay multiidioma, y poco más.
Del «Sign in to continue» de agosto a los redirects goto
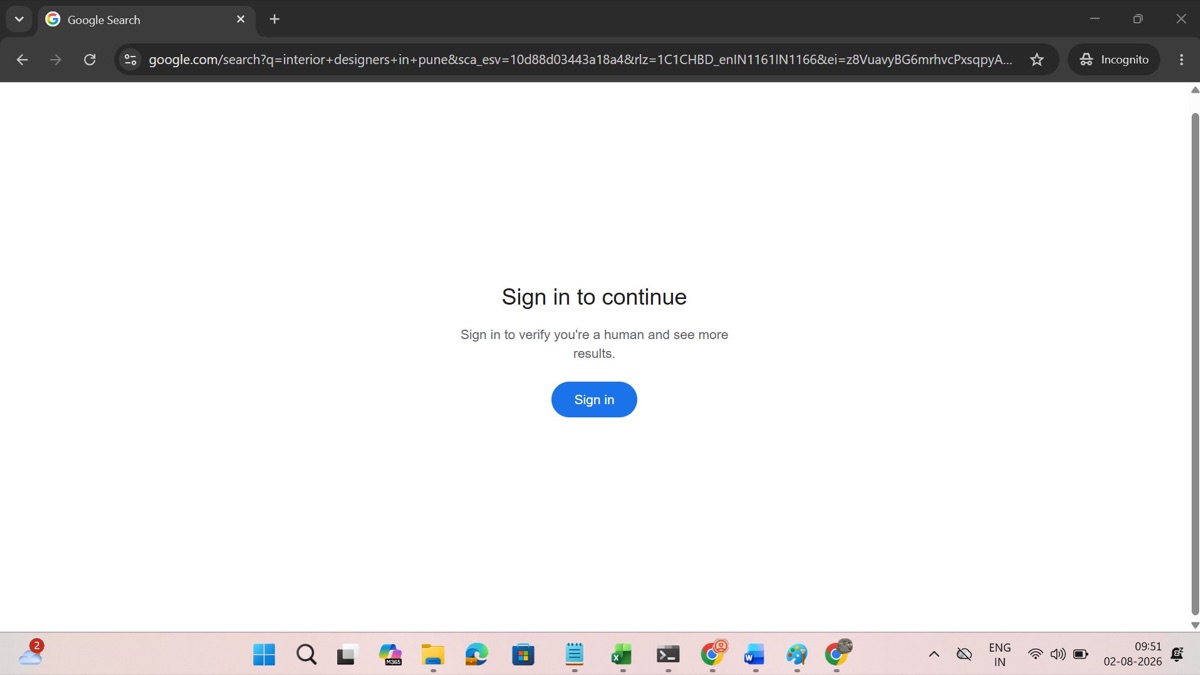
Este test llega detrás de otros. El 3 de agosto, Schwartz ya había publicado una pantalla parecida que había visto Kamlesh Shukla en India, en Chrome de incógnito y después de pasar varias páginas de resultados de la búsqueda [interior designers in pune]. Aquella decía "Sign in to continue" y "Sign in to verify you're a human and see more results.", o sea, inicia sesión para seguir y para demostrar que eres humano. La de agosto exigía cuenta de Google; la de ahora se conforma con que esperes. Schwartz, por cierto, tampoco pudo reproducir aquella pese a intentarlo con varios navegadores.
La pieza sólida de todo esto, y la única que Google ha reconocido, son los redirects google.com/goto. Alex Greenland los vio por primera vez el 23 de junio; Brodie Clark documentó el patrón el 2 de julio y comprobó que devuelven un 302 al destino real. Durante semanas fue casi imposible reproducirlos (el 8 de julio Schwartz solo consiguió identificar a tres personas que los veían), hasta que el 26 de agosto Derek Perkins, de Nozzle, reportó un despliegue cercano al 100% en varios proveedores de IP residenciales. En la práctica, Google sustituye la URL de destino por una dirección suya que hay que seguir para saber adónde lleva, la misma idea que llevamos años usando para ofuscar enlaces para SEO y aplicada aquí en sentido contrario: si el destino no está en el HTML, el que rastrea no lo ve.
Ese mismo día llegó la confirmación oficial, en una declaración de un portavoz a Search Engine Roundtable: "We have a long history of deploying technical measures against evolving forms of abuse, and we regularly take steps to protect our services and users." En pocas palabras, que llevan mucho tiempo desplegando medidas técnicas contra el abuso y que actúan con regularidad para proteger sus servicios y a sus usuarios. La frase habla de "abuso" y ahí se queda: ni una mención a los rank trackers ni a las empresas de IA, ningún calendario, ningún desglose por países, y tampoco hay post en el blog de Google ni documentación en Search Central sobre goto. Que el objetivo sean las herramientas de SEO es una conclusión del sector, y Google nunca lo ha dicho.
El fondo legal explica el momento. Google demandó a SerpApi en diciembre de 2025 por saltarse sus protecciones antibot, y el 20 de julio de 2026 la jueza Yvonne Gonzalez Rogers desestimó todas las reclamaciones: las URLs y los snippets del índice son hechos públicos y quedan fuera del copyright, así que la ley que Google invocaba no aplicaba. Un mes después llegó la medida técnica. La correlación es evidente; la causalidad la apunta Schwartz como valoración propia, y PPC Land subraya que es su opinión y no un comunicado de la empresa. La vista del caso está fijada para el 29 de septiembre.
Qué le cuesta esto a los rank trackers y a tus informes
Los enlaces goto no se pueden descifrar en local: para saber a qué web apunta cada resultado hay que seguir el redirect, una petición por enlace. Perkins dio la cifra en un hilo de X que recogió PPC Land: resolver todos los enlaces de un ranking de cinco páginas cuesta entre 500 y 1.000 peticiones. Ojo con el dato, que por ahí se está contando mal: hablamos de cinco páginas de resultados completas, y no de una sola SERP.
Y no hay atajo barato. A la pregunta de Mic King de si bastaría con peticiones HEAD (que recuperan solo las cabeceras y saldrían casi gratis), Perkins respondió que Google no las deja pasar. Un GET que se corta en el redirect sí funciona, pero entonces el límite lo marca el rate limiting y no el ancho de banda. Dominic Woodman planteó la única pregunta que cambiaría el panorama, si el redirect es estático por página y se puede cachear en una tabla, y se quedó sin respuesta en el hilo. De eso depende que esto sea un coste de ingeniería que se paga una vez o un impuesto permanente por consulta.
El precedente más cercano es de hace un año. Cuando Google eliminó el parámetro num=100 en septiembre de 2025, Semrush confirmó en menos de 24 horas que el coste operativo se multiplicaba por diez, y la reacción del sector fue recortar: AccuRanker limitó el seguimiento al top 20 y SISTRIX dejó de actualizar las SERPs de escritorio (Ahrefs recuperó el top 100 en octubre sin explicar cómo). Los dos efectos se acumulan: num=100 multiplicó las páginas que hay que descargar y goto multiplica las peticiones para interpretar una página ya descargada.
Para el trabajo del día a día, el problema gordo llega por la comparabilidad de las series. De momento el único proveedor que se ha pronunciado en público es DemandSphere, que el 27 de agosto dijo que "Ranking data for organic is unaffected", que los datos de ranking orgánico no se ven afectados, y que estaba desplegando contramedidas para las URLs de features. Nozzle, mientras duró el test, descartaba directamente las SERPs afectadas, algo viable cuando son minoría e imposible al 100% de despliegue. Traducido a un informe mensual: la volatilidad que veas entre julio y septiembre de 2026 puede venir de las herramientas y no de Google, como avisó Joe Kizlauskas, y comparar en serie continua a través de esa frontera es pedir un disgusto. Lo sensato es anotar un corte metodológico en agosto de 2026 en los informes que se lo tengan que comer.