Qué midió Profound en 71.147 respuestas de ChatGPT, Claude y Gemini
Profound, una herramienta de monitorización de marca en motores de respuesta, publicó el 9 de septiembre de 2026 un análisis firmado por Allison Huang sobre 71.147 respuestas de ChatGPT, Claude y Gemini, recogidas a lo largo de catorce días, entre el 11 y el 24 de agosto de 2026. Los prompts de partida salen de tres categorías de su propio índice: tarjetas de crédito, ropa y muebles.
El método conviene entenderlo bien antes de mirar las cifras. A cada prompt base se le antepone un único rasgo declarado en primera persona, con la fórmula "I am [valor]. [prompt]". El ejemplo que publica el estudio es "I am in my 30s. best affordable furniture companies.", en pocas palabras, "tengo treinta y tantos. mejores empresas de muebles asequibles". Los rasgos son cuatro (género, edad, renta y ocupación) con catorce valores en total, y no se cruzan entre sí, así que no hay perfiles compuestos del tipo mujer de setenta años con renta alta.
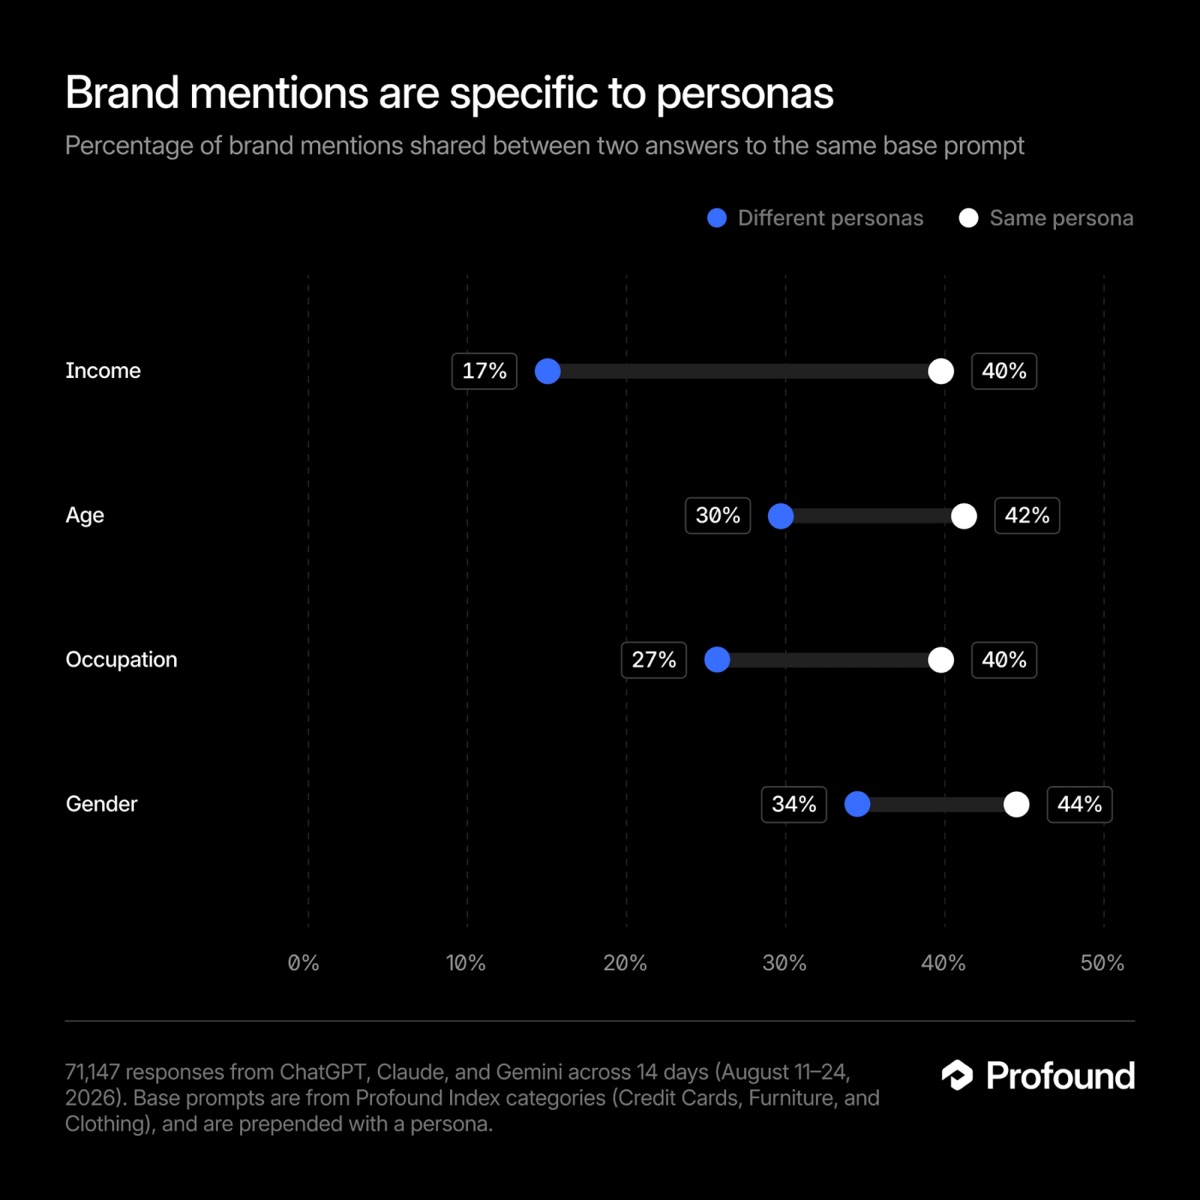
El resultado de cabecera compara dos respuestas al mismo prompt base. Con el mismo rasgo delante, las dos respuestas comparten alrededor de dos de cada cinco marcas mencionadas. Al cambiar el rasgo, bajan a una de cada cuatro. La frase del informe es "changing the persona reduced brand overlap by 15 percentage points", es decir, que cambiar el perfil recorta el solapamiento en quince puntos porcentuales. Con las fuentes citadas ocurre lo mismo: un 34% de dominios compartidos cuando el rasgo se repite y un 20% cuando cambia.
El desglose por rasgo está en la gráfica y no en el texto. La renta es la que más separa las recomendaciones, con un 17% de solapamiento entre rentas distintas frente al 40% al repetir la misma. Le siguen la ocupación (27% frente a 40%), la edad (30% frente a 42%) y el género (34% frente a 44%).
De los tres modelos, solo dos dejan ver lo que buscan. ChatGPT y Claude registran las consultas que lanzan hacia la web y Gemini no las expone, así que el bloque de análisis de búsquedas se apoya en 47.431 respuestas en lugar de en las 71.147 del total.
Las marcas de ropa que salen con renta baja y con renta alta
Sobre las 23.519 respuestas de la categoría de ropa, el estudio publica los diez nombres más mencionados en cada tramo de renta. En renta baja aparecen Poshmark, Depop, Target, ThredUp, Uniqlo, Goodwill, Pact, H&M, Quince y Old Navy. En renta alta, The Row, Brunello Cucinelli, Loro Piana, Hermès, Chanel, Prada, Bottega Veneta, Gucci, Tom Ford y Louis Vuitton. Las dos listas no comparten ni una sola marca.
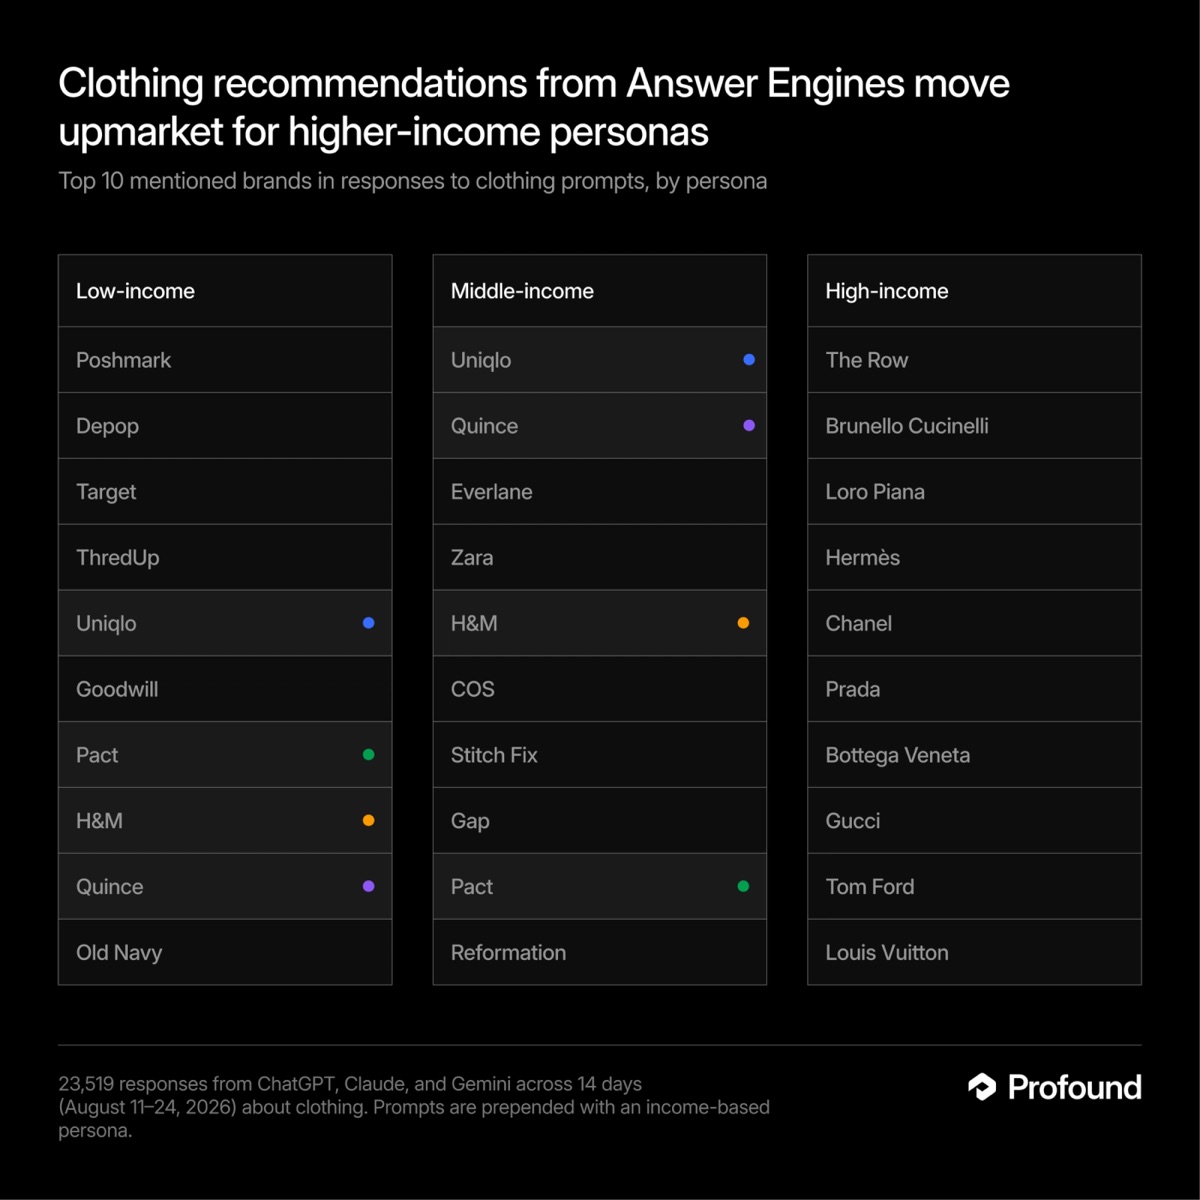
Para dimensionar la distancia, Profound tomó el precio de una camiseta representativa de cada marca recomendada. El rango va de 8 a 24 dólares en renta baja, de 10 a 58 en renta media y de 140 a 1.650 dólares en renta alta. El informe no dice qué producto eligió en cada marca, ni en qué fecha ni en qué tienda consultó el precio.
El volumen de respuesta también cambia con el tramo. Las respuestas a perfiles de renta alta traen de media 7,5 menciones de marca y 4,8 citaciones; las de renta media, 6,8 y 4,4; las de renta baja, 5,8 menciones y 4,1 citaciones.
Las búsquedas que lanzan los modelos explican parte de la divergencia. ChatGPT y Claude traducen la renta a términos de presupuesto por su cuenta: el 68,7% de las consultas de perfiles de renta alta incorpora un cualificador del tipo luxury, premium o high-end, frente al 51,9% de las de renta baja con affordable, budget o cheap, y el 46,9% de las de renta media.
Ahí aparecen también suposiciones que nadie pidió. El estudio dice que los modelos "sometimes translated personas into unjustified assumptions about work context, income, retirement, accessibility, and life stage", esto es, que a veces convierten el rasgo en suposiciones injustificadas sobre trabajo, renta, jubilación, accesibilidad y etapa vital. El caso que cuantifica: en ChatGPT y Claude, las consultas de ropa para la banda de los cincuenta tienen 39 puntos porcentuales más de probabilidad de incluir "women" que las del resto de bandas de edad.
Con el género pasa algo parecido en los nombres recomendados, y el estudio cita Patagonia y Ralph Lauren entre los más mencionados para hombre, frente a Reformation y Free People para mujer. Hay además un dato desglosado por modelo: en las respuestas de ropa de Gemini, los perfiles de renta alta reciben 24 puntos porcentuales más de citaciones de webs de marca, 17 menos de medios ganados y 8 menos de fuentes institucionales que los de renta baja.
Qué no mide el estudio de Profound
El informe no incluye apartado de limitaciones, así que toca enumerar lo que falta. No declara las versiones de los modelos que usó, y con una ventana de catorce días de agosto de 2026 eso deja el trabajo sin posibilidad de réplica exacta. Tampoco declara país ni idioma, aunque las marcas que salen (Target, Goodwill, Old Navy) y los precios en dólares apuntan al mercado estadounidense.
La distinción que más cambia la lectura está en el mecanismo. Lo que el estudio manipula es el texto del prompt, una frase antepuesta que el modelo lee y obedece. No hay cuentas con historial, ni memoria activada, ni señales de sesión, así que la personalización por cuenta queda fuera de lo que estas cifras pueden demostrar.
Del aparato estadístico tampoco hay mucho. El estudio publica tres tamaños de muestra agregados (71.147 en total, 23.519 en ropa y 47.431 en ChatGPT y Claude) y ningún dato de muestra por celda, ni intervalos de confianza, ni pruebas de significación, ni datos brutos descargables. Las diferencias de 15, 14 y 39 puntos se dan como cifras sueltas, sin margen de error asociado.
Falta también una condición de control sin ningún rasgo antepuesto, de modo que no se puede saber cuánto se desvía una respuesta con perfil respecto de la respuesta neutra al mismo prompt. Sobre el emisor, conviene tenerlo presente: Profound vende monitorización de visibilidad en motores de respuesta, incluida una función de perfiles, y el post cierra con una llamada a pedir demo.
La conclusión que el propio estudio dirige a los responsables de marketing es "Measure visibility by persona as well as platform", en pocas palabras, medir la visibilidad por perfil de cliente y no solo por plataforma. Y añade una segunda: publicar información concreta de precio, casos de uso, talla, requisitos y necesidades del cliente tanto en páginas propias como en fuentes de terceros.
Mi lectura
Para empezar, lo importante es que solo el 40% de las marcas se repiten entre dos respuestas con el mismo rasgo, es decir, que los modelos son consistentes solo en el 40% de los casos. De hecho esto es algo que ya vimos en mi Estudio de Clicandseo sobre visibilidad en LLMs.
Si vendes en un rango de precios determinado o high ticket, es importantísimo que tu herramienta de monitorización de LLMs y AI Overview te permita segmentar prompts, clusterizarlos y agruparlos incluso por estacionalidades. Así lo hacemos en Clicandseo, al menos. Debemos medir con mayor precisión y contemplar este tipo de búsquedas (aunque también es un caso extraño que alguien meta su renta o su capacidad económica en un prompt...).