textGrain: la marca de agua de OpenAI para el texto de ChatGPT y Codex en la UE
OpenAI publicó el 5 de octubre de 2026 una entrada en su sección de seguridad titulada «Our approach to EU text provenance rules», donde explica cómo va a cumplir con las normas europeas de procedencia del texto generado por IA. La pieza central es una tecnología propia llamada textGrain, que según la compañía «adds an invisible statistical signal to the model's word choices». Es decir, no añade ninguna etiqueta visible ni metadatos: altera de forma estadística la elección de palabras del modelo para que un detector pueda reconocerla después.
El despliegue tiene tres partes. En ChatGPT y Codex, la marca se aplicará al texto «elegible» de los usuarios de todos los planes solo en la Unión Europea y «over the coming weeks», así que a fecha de hoy no hay constancia de que ya esté activa. En la API, la opción existe desde el 5 de octubre para clientes de cualquier país, pero viene desactivada por defecto y solo funciona en «select models», sin que OpenAI diga cuáles. Y la compañía añade que trabaja con proveedores de nube para marcar también las salidas de sus modelos que se sirven a través de ellos, sin nombrar a ninguno. La frase que resume el alcance es suya: «We are not making text watermarking a global default at launch».
OpenAI dice que ha probado textGrain en Astra, su modelo más reciente, y que no ve diferencias de rendimiento apreciables con la marca activada. Publica una tabla con ocho benchmarks; en el Artificial Analysis Intelligence Index pasa de 49,57 sin marca a 49,76 con ella, y en GPQA Diamond de 94,44% a 93,94%. También afirma que textGrain iguala o supera a otros enfoques que ha probado, SynthID para texto incluido (el sistema de Google DeepMind), aunque no publica las cifras de esa comparación. Hay un informe técnico en PDF y la promesa de liberar el código, sin fecha.
Quién puede usar el detector de la marca de agua
El detector no será público. OpenAI abrió el 5 de octubre un formulario de solicitud, pero el acceso se dará caso por caso y solo a «approved researchers and expert organizations». La explicación que da es esta: «Given the risk of missed watermarks and false positives, we are not making it publicly available at launch». Según la entrada, el detector solo responde si un texto lleva o no la marca de OpenAI; no identifica al usuario ni muestra el prompt o la conversación.
El trato es distinto al de imagen y audio, donde la verificación de procedencia de OpenAI sigue abierta a cualquiera. Para el texto, la compañía se reserva ampliar el acceso más adelante, «when we believe results can be interpreted responsibly», sin plazo.
Cuánto aguanta la marca de agua cuando editas el texto
La parte más útil de la entrada son los datos de robustez que publica la propia OpenAI, con una tasa objetivo de falsos positivos del 1%. La longitud manda. En textos de psicología, la detección pasa del 94,3% a 400 tokens al 78,5% a 200, y en matemáticas, donde hay menos margen para elegir palabras, cae al 60,8% a 400 tokens y al 36,5% a 200.
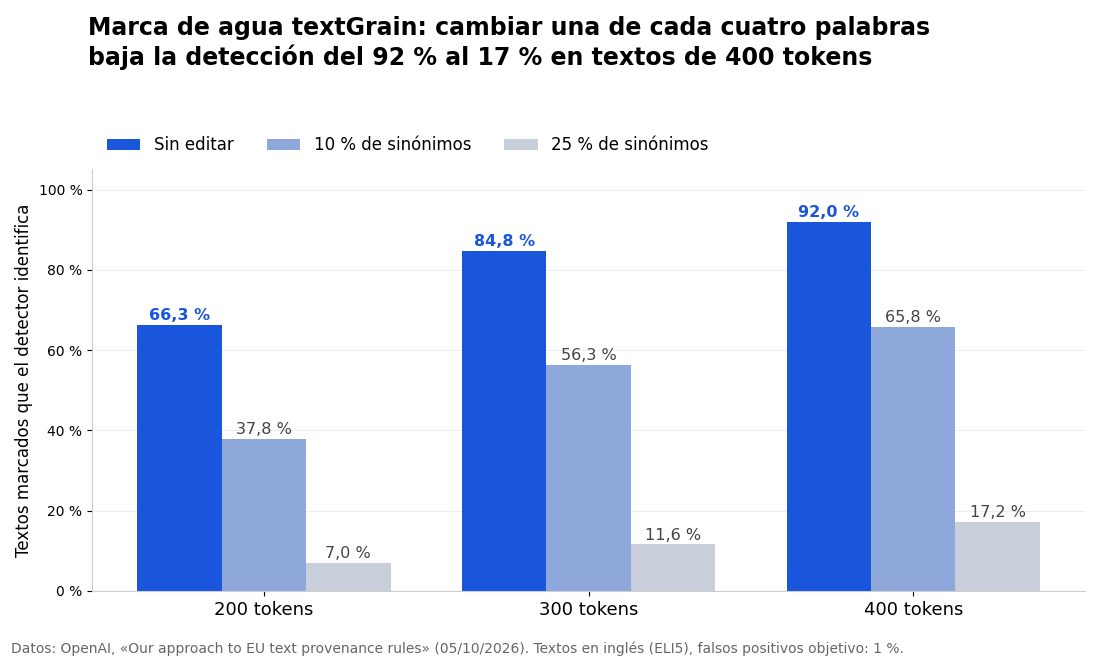
La edición pesa todavía más. Con respuestas en inglés a preguntas del conjunto ELI5, un texto de 400 tokens sin tocar se detecta en el 92% de los casos; si se cambia un 10% de las palabras por sinónimos, en el 65,8%; y con un 25% de sinónimos, solo en el 17,2%. En textos de 200 tokens el mismo 25% deja la detección en el 7%.
OpenAI enumera además lo que la marca no demuestra. No mide cuánto ha aportado una persona, no establece propiedad ni responsabilidad, no dice si el uso era lícito o había que declararlo y no verifica si el texto es exacto. Y su ausencia tampoco prueba que haya escrito un humano, porque el texto puede ser corto, estar editado o traducido, venir de otro modelo o de otra empresa, o ser anterior a la marca. La propia compañía lo resume así: «Text watermarking and detection remain early technologies with significant limitations».
El artículo 50 del Reglamento de IA y el código de buenas prácticas
El contexto legal es el artículo 50 del Reglamento europeo de IA, que obliga a los proveedores a marcar en un formato legible por máquina el contenido que generan sus sistemas. Según las preguntas frecuentes de la Comisión Europea, esas obligaciones se aplican desde el 2 de agosto de 2026, con una salvedad: los sistemas que ya estaban en el mercado antes de esa fecha tienen hasta el 2 de diciembre de 2026 para cumplir con el marcado y la detección.
Para concretar cómo cumplir, la Comisión publicó el 10 de junio de 2026 la versión final del código de buenas prácticas sobre transparencia del contenido generado por IA, que considera una herramienta voluntaria adecuada y que a finales de julio habían firmado unas 190 organizaciones. OpenAI anunció su apoyo al código el 11 de junio y en su entrada del 5 de octubre dice que el acceso caso por caso al detector sigue lo que marca ese código.
Mi lectura
Para quien produce contenido con ChatGPT desde España, el efecto práctico es más pequeño de lo que suena. La marca la llevará el texto que copies y pegues tal cual, y las cifras de OpenAI dicen que con reescribir una de cada cuatro palabras ya casi no se detecta. Tampoco hay nada que indique que Google pueda leerla: el detector va a investigadores aprobados y OpenAI no ha dicho quiénes son. Así que no lo veo como un riesgo SEO nuevo. Lo que sí hace es dejar un rastro en el texto que publicas sin tocar, y eso va en la misma dirección que lo que Google ya pide a la hora de valorar contenido: que haya alguien detrás que aporte algo, que es justo lo que explico al hablar de information gain.
Me chirría más la asimetría. Por defecto se marca a quien usa ChatGPT en la UE, mientras que en la API, donde se genera contenido a escala, es opcional. Y quien recibe un texto no tiene forma de comprobar nada. Si un cliente te pregunta si «se nota» que un texto es de IA, la respuesta honesta es que la marca existe, pero ni tú ni él podéis leerla.