Cómo se reordenan 113 pares de fuentes sin volver a buscar
El trabajo se llama «CiteChoice: A Causal Audit of How Document Presentation Redistributes Citation Credit in Agentic Search» y lo firman Sriram Selvam y Anneswa Ghosh. Se publicó en arXiv el 14 de septiembre de 2026, sin revisión por pares y sin afiliación institucional: en la portada solo aparecen dos correos personales.
El montaje es un agente de búsqueda construido sobre GPT-5.4, con Exa como proveedor de resultados. Cada llamada de búsqueda devuelve cinco resultados con hasta 10.000 caracteres de texto de página, el agente está obligado a buscar antes de responder y puede encadenar hasta cinco turnos. Las citas se hacen con identificadores opacos en vez de URLs, para que el modelo no reconozca el dominio.
La unidad de análisis es lo que los autores llaman par competidor: dos documentos devueltos en la misma llamada de búsqueda que sostienen por separado el mismo hecho. Los hechos que la respuesta tiene que cubrir se fijan antes de lanzar la búsqueda, y la selección de pares se hace a ciegas, sin ver posiciones ni resultados de citación. De 130 consultas salieron 129 conversaciones, 1.490 documentos únicos y 113 pares congelados para el experimento. Una revisión humana, también a ciegas, validó 103 de esos 113.
Después viene la parte que da nombre al estudio. Se reconstruye la conversación entera (consulta, llamadas a la herramienta y resultados) con la búsqueda en vivo desactivada, y se intercambian las posiciones de los dos documentos del par dentro de su propia llamada. Al modelo le llega únicamente como posición en una lista, porque los datos que recibe no llevan ni la puntuación del buscador ni ningún campo numérico de ranking. Antes de cada ejecución, una comprobación por hash aborta el ensayo si ha cambiado cualquier otro campo. El diseño cruza posición (arriba o abajo) con formato (prosa o estructurado), lo que da cuatro ensayos por par y 452 en total, todos completados.
La brecha de 42,3 puntos entre la posición 1 y la posición 5
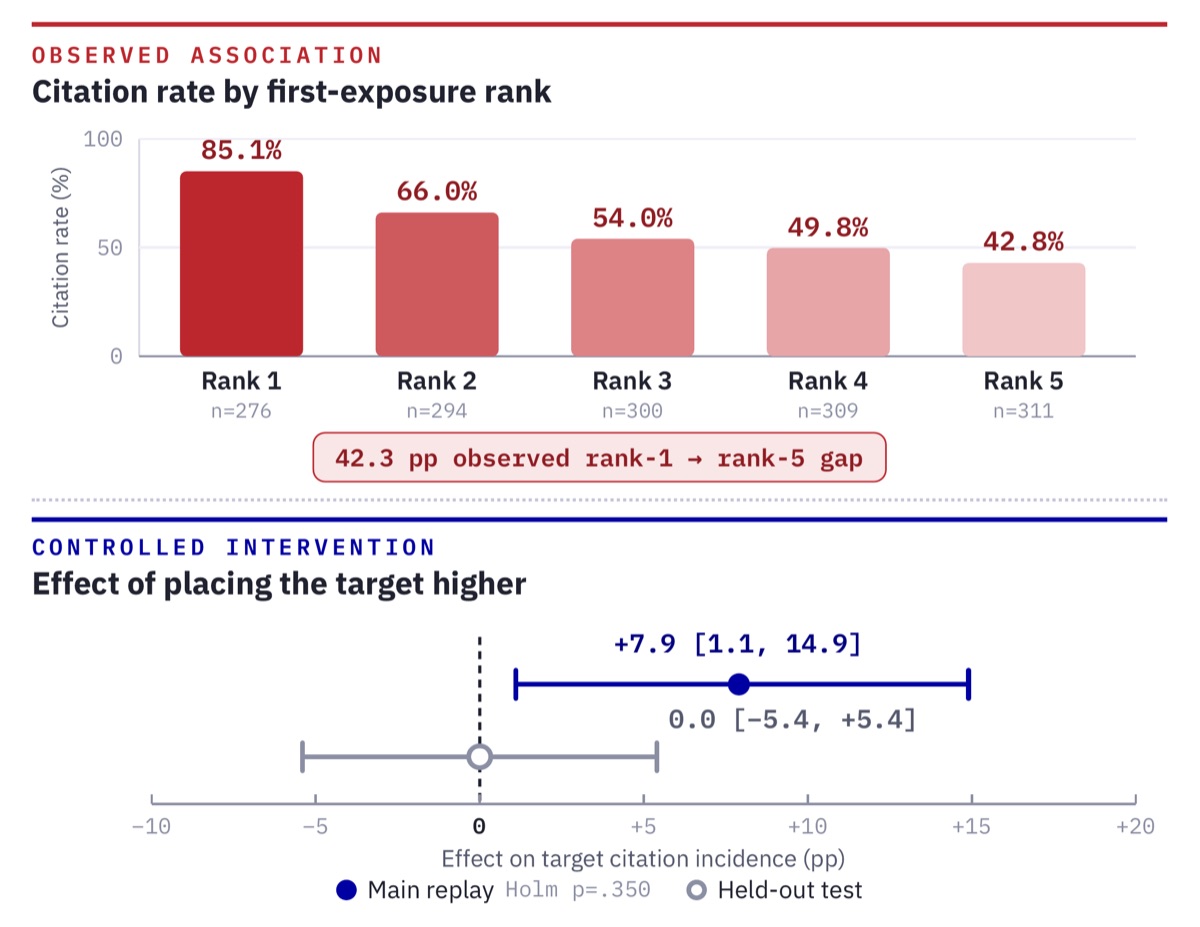
Lo primero que mide el estudio es la foto de siempre, la correlación. Contando cuántas veces se cita cada documento la primera vez que aparece, según el puesto que ocupaba:
- Posición 1: 85,1% de citación (276 documentos)
- Posición 2: 66,0% (294)
- Posición 3: 54,0% (300)
- Posición 4: 49,8% (309)
- Posición 5: 42,8% (311)
De la primera a la quinta hay 42,3 puntos porcentuales de diferencia. Es el dato que sostiene buena parte de lo que se cuenta sobre visibilidad en motores generativos. Los propios autores lo etiquetan en el paper: "These are descriptive; rank is confounded with relevance, quality, and the agent's query choices". En pocas palabras, es una descripción, y el puesto va mezclado con la relevancia, la calidad y las consultas que el agente decidió lanzar.
Qué pasa al intercambiar de verdad las dos fuentes
Con las mismas páginas, el mismo hecho y la misma conversación, subir el documento objetivo por encima de su competidor mueve la citación 7,9 puntos porcentuales, con un intervalo de confianza del 95% entre 1,1 y 14,9. El valor p sin corregir es 0,035, y ahí conviene ser precisos: el estudio declara una familia de 16 pruebas secundarias y aplica la corrección de Holm por comparaciones múltiples, que sube ese valor a 0,350. Es decir, el efecto deja de ser significativo cuando se corrige por el número de pruebas.
El segundo control es el que remata el asunto. Sobre 56 pares reservados aparte, intercambiados de forma aislada, el estimador sale exactamente 0,0 puntos, con intervalo entre -5,4 y +5,4 y un valor p de 1,00. Los autores lo resumen así: "the descriptive gradient is five times the scaled point estimate and has no counterpart in held-out confirmation". Traducido, la pendiente que se ve al describir es cinco veces mayor que el efecto medido con control, y en la confirmación aparte no queda nada de ella.
Hay un matiz de dosis que el estudio explora sin cerrarlo. Al mirar cuánto se desplaza cada documento, mover un solo puesto da -3,3 puntos, dos y tres puestos dan +13,4 y +13,0, y diez intercambios de ventana completa llegan a +30,0. Pero los pares reservados cubren saltos comparables de uno a cuatro puestos y siguen pegados a cero en todos los tramos, incluidos nueve casos de ventana completa. Los autores lo dejan como exploratorio.
El formato estructurado concentra citaciones sin ampliar el total
El otro brazo del experimento cambia cómo está escrito el documento objetivo, entre prosa y una versión estructurada con encabezados y listas. Las dos versiones se generan a la vez y pasan un control de fidelidad, y la estructurada tiene de media solo 1,5 palabras menos que la de prosa, así que no es un problema de longitud. El resultado: medio marcador de citación más por respuesta, con intervalo entre 0,20 y 0,84 y un valor p de 0,033 ya corregido por Holm. En bruto son 2,69 marcadores con prosa frente a 3,12 con estructura.
El detalle que cambia la interpretación es de dónde sale ese medio marcador. No aumenta el total de citaciones de la respuesta ni le quita crédito al competidor, que sigue igual de citado. Lo que se mueve es el reparto dentro de un presupuesto fijo. Los autores lo escriben con todas las letras para quien vaya a usar el paper como manual: "the supported effect is concentration, not admission", es decir, el formato concentra crédito entre fuentes que ya estaban dentro, y no consigue meter fuentes nuevas.
Sobre si el documento llega a ser citado o no, el efecto del formato es de 4,5 puntos con un intervalo que cruza el cero (de -1,4 a +10,4) y un valor p de 0,168, así que queda sin resolver. Y hay una prueba adicional que conviene conocer antes de sacar conclusiones de maquetación: al coger exactamente las mismas palabras y limitarse a montarlas como lista, una frase por fila, sale +6,7 puntos en los 113 pares, pero al repetir el experimento sobre 30 familias el signo se da la vuelta y queda en -5,0 de media, con un valor p de 0,22. Esa reversión descarta que exista un mecanismo estable de marcadores de lista.
Una de cada siete decisiones de citar cambia al repetir la consulta
La parte del estudio con más recorrido para el trabajo diario es la que mide el ruido del propio instrumento. Al regenerar 120 celdas de forma independiente, sin cambiar absolutamente nada, la decisión binaria de citar o no citar el documento objetivo coincide el 85,0% de las veces. Dicho al revés, el 15% de las decisiones cambia sola, una de cada siete.
Y eso es lo más benévolo que se puede medir. Si en vez de mirar un documento se mira el conjunto exacto de fuentes citadas, la coincidencia baja al 78,3%, y si se miran los recuentos exactos, al 61,7%. Descomponiendo la varianza, el ruido de generación explica el 45% de la variación del efecto por familia cuando se mide con una sola ejecución. El efecto del formato, en cambio, sí se repite: +0,54 en la primera generación y +0,55 en una nueva.
Los límites que declaran los autores
El primero es de alcance. Todo está medido con un proveedor de búsqueda (Exa, cinco resultados por llamada) y un modelo (GPT-5.4): "All estimates are conditional on one retrieval provider [...] one acquisition agent and primary answer deployment", y el propio texto añade que el replay congelado no puede medir si una edición del editor cambia la recuperación ni el ranking en la web real. El experimento toca texto ya recuperado, no el buscador.
El segundo es de potencia estadística. Con 89 familias independientes, el efecto mínimo detectable es de 8,5 puntos, así que los autores escriben que el +4,5 de incidencia es "unresolved rather than evidence of zero": está sin resolver, y no demostrado que sea cero. Es un matiz importante, porque el paper no dice que la posición no importe, dice que la evidencia que queda tras controlar es mucho más débil que la que se observa sin controlar.
Quedan otros tres avisos en el propio texto. Grok-4.3 genera las versiones reescritas y además valida su fidelidad en un pase ciego, algo que los autores describen como separación de procedimiento y no como familias de modelos independientes. El resultado que se mide es el crédito visible en la respuesta, no el tráfico ni la dependencia real de la evidencia. Y las respuestas del experimento llevan una mediana de 29 marcadores de citación, un contrato de citación muy denso que puede no trasladarse a sistemas que citan poco. El repositorio de código que declaran en el paper no estaba accesible el 18 de septiembre.
Conviene además ponerlo al lado de lo que hay publicado. «What Gets Cited: Competitive GEO in AI Answer Engines», de Vishwakarma, presentado en SIGIR 2026 y con revisión por pares, montó un banco de pruebas de dos documentos con 252.000 ensayos sobre seis modelos y concluyó lo contrario en los dos ejes: la posición en la lista sale como uno de los mayores impulsores de la citación y las ediciones de solo formato apenas mueven nada. Los dos estudios miden cosas distintas, uno con documentos sintéticos en parejas y otro con conversaciones auténticas de varios turnos, y de momento no hay forma de saber cuál describe mejor lo que hace un motor real. Sobre qué hace que una fuente aporte algo que las demás no tienen, está el information gain.