Actualización 28/09/2026
En el bloque del 22/09 escribí que ni Microsoft ni OpenAI habían dicho nada en público sobre las cifras de CTR, y no es exacto. Las versiones públicas de sus propias mociones de sentencia sumaria, registradas también el 17 de septiembre (documentos 1975 y 1980), contestan a ese argumento. Ninguna de las dos discute los porcentajes, lo que niegan es que cuenten como daño en el análisis de uso legítimo (fair use).
Microsoft, en la página 37 del PDF del documento 1975, describe el dato como "an expert's calculation" sobre el CTR de Copilot frente a la búsqueda de Bing, un cálculo pericial, sin entrar en de qué datos sale. Su argumento legal es que "News Plaintiffs are not entitled to lock in existing sources of referral traffic or historical click-through rates", o sea, que los editores no tienen derecho a blindar su tráfico de referencia ni su CTR histórico. Añade que la perito de los demandantes reconoció no tener opinión sobre si los chatbots están sustituyendo a los buscadores a escala, y que según sus datos ni el tráfico total ni las conversiones de esas webs han cambiado por Copilot.
OpenAI, en la página 24 del documento 1980, responde que la perito de los demandantes "did not calculate click through rates on ChatGPT", así que las cifras de CTR del expediente son de Copilot, no de ChatGPT. Sostiene que no hay pruebas de una caída de tráfico por ChatGPT y que perder clics porque la respuesta sintetizada ya le basta al usuario no es el tipo de sustitución que cuenta en el fair use. Este memorándum, que en la pieza original daba por no disponible en abierto, ya se puede leer en CourtListener.
Según la orden del juez Stein del 7 de agosto, las oposiciones a las mociones vencen el 9 de octubre y las réplicas el 6 de noviembre. Es en esos escritos donde cada parte contesta directamente a los argumentos de la otra.
Actualización 22/09/2026
El 17 de septiembre los demandantes de prensa registraron una nueva versión pública de su memorándum combinado (documento 1977-1, 92 páginas), con las tachaduras levantadas en todo lo que ninguna parte había pedido mantener sellado. Entre lo que ya se puede leer están las cifras de CTR de Microsoft que más abajo aparecen en negro. El pasaje está en la página 76 del PDF: "Microsoft's representative CTR data shows that the overall click-through rate reduction between Bing Chat and Bing Web Search was 87% to 93% for The Times's websites, 83% to 91% for DNP's websites, and 51% to 94% for ZD websites". Es decir, frente a la búsqueda web de Bing, el chat de Bing recibía entre un 87% y un 93% menos de CTR en las webs del Times, entre un 83% y un 91% en las de Daily News y entre un 51% y un 94% en las de Ziff Davis.
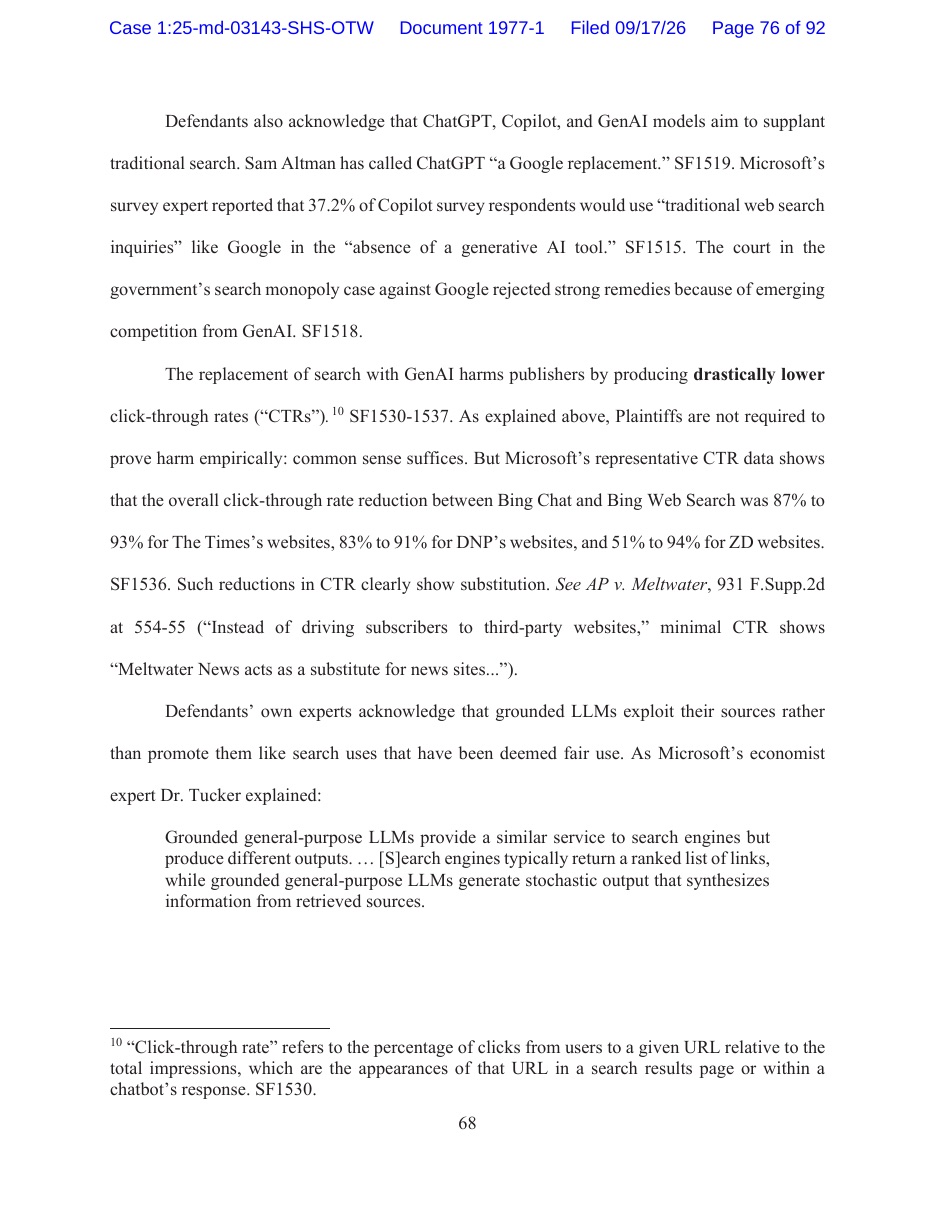
La nota 10 del escrito define la métrica como los clics a una URL entre sus impresiones, tanto en una página de resultados como dentro de la respuesta del chatbot. Son caídas relativas, no puntos porcentuales. En la introducción y en la página 22 el mismo escrito llama al producto Copilot, y en la 76 Bing Chat. Lo que la versión pública no dice es el periodo que cubre el análisis, el tamaño de la muestra, cuántos dominios entran por editor ni qué significa «representative», y los documentos de Microsoft en los que se apoya siguen sellados. Con un rango del 51% al 94% en Ziff Davis, sin ese detalle no se puede saber qué hay en cada extremo. Y sigue siendo la versión de una de las partes.
En la página 62 aparece otra cifra: "third party study reporting that 87.78% of ChatGPT users visit no external websites during their search, compared to only 26.91% of Google users". El escrito no identifica ese estudio (ni autor, ni fecha, ni método) y no he encontrado ninguna publicación independiente con esas cifras, así que por ahora es un dato sin fuente primaria pública.
Ni Microsoft ni OpenAI han dicho nada en público sobre las cifras de CTR. El portavoz de Microsoft Alex Haurek sí respondió al New York Times sobre los memorandos internos que cita el mismo escrito, y dijo que la posición de la empresa está en sus escritos, que explican "why Copilot is not a substitute for publishers' journalism". Puede salir más material. El 21 de septiembre la magistrada Ona T. Wang tomó nota de la moción de Bloomberg Industry Group para oponerse a los sellados y dio a las partes hasta el 25 de septiembre para proponer un calendario.
La ratio de rastreo por visita, dentro del expediente judicial
El 4 de septiembre de 2026 las tres partes del procedimiento consolidado In re: OpenAI, Inc. Copyright Infringement Litigation (caso 25-md-3143, Distrito Sur de Nueva York, juez Sidney H. Stein) presentaron sus mociones cruzadas de sentencia sumaria. Los demandantes de prensa registraron un memorándum combinado de 92 páginas, firmado por Ian Crosby (Susman Godfrey) en nombre del New York Times y del resto del grupo, más un anexo de hechos no controvertidos de 449 páginas. OpenAI y Microsoft presentaron las suyas el mismo día. El grupo demandante incluye al New York Times, a las cabeceras de Daily News (Chicago Tribune, Orlando Sentinel, Denver Post, Mercury News y más), a Ziff Davis, al Center for Investigative Reporting y a The Intercept.
En la página 78 de ese memorándum, dentro de la sección que argumenta que los productos de los demandados reducen la demanda del contenido de los demandantes, aparece el párrafo con la cifra: «Cloudflare's CEO cited data showing the ratio of webpages scraped to visitors sent: in 2015, Google scraped two pages for every visitor (2:1); by June 2025, that ratio was 18:1 for Google and 1,500:1 for OpenAI». En pocas palabras, que por cada visita que te manda OpenAI se lleva mil quinientas páginas tuyas, y que Google, que en 2015 se llevaba dos, ya va por dieciocho.
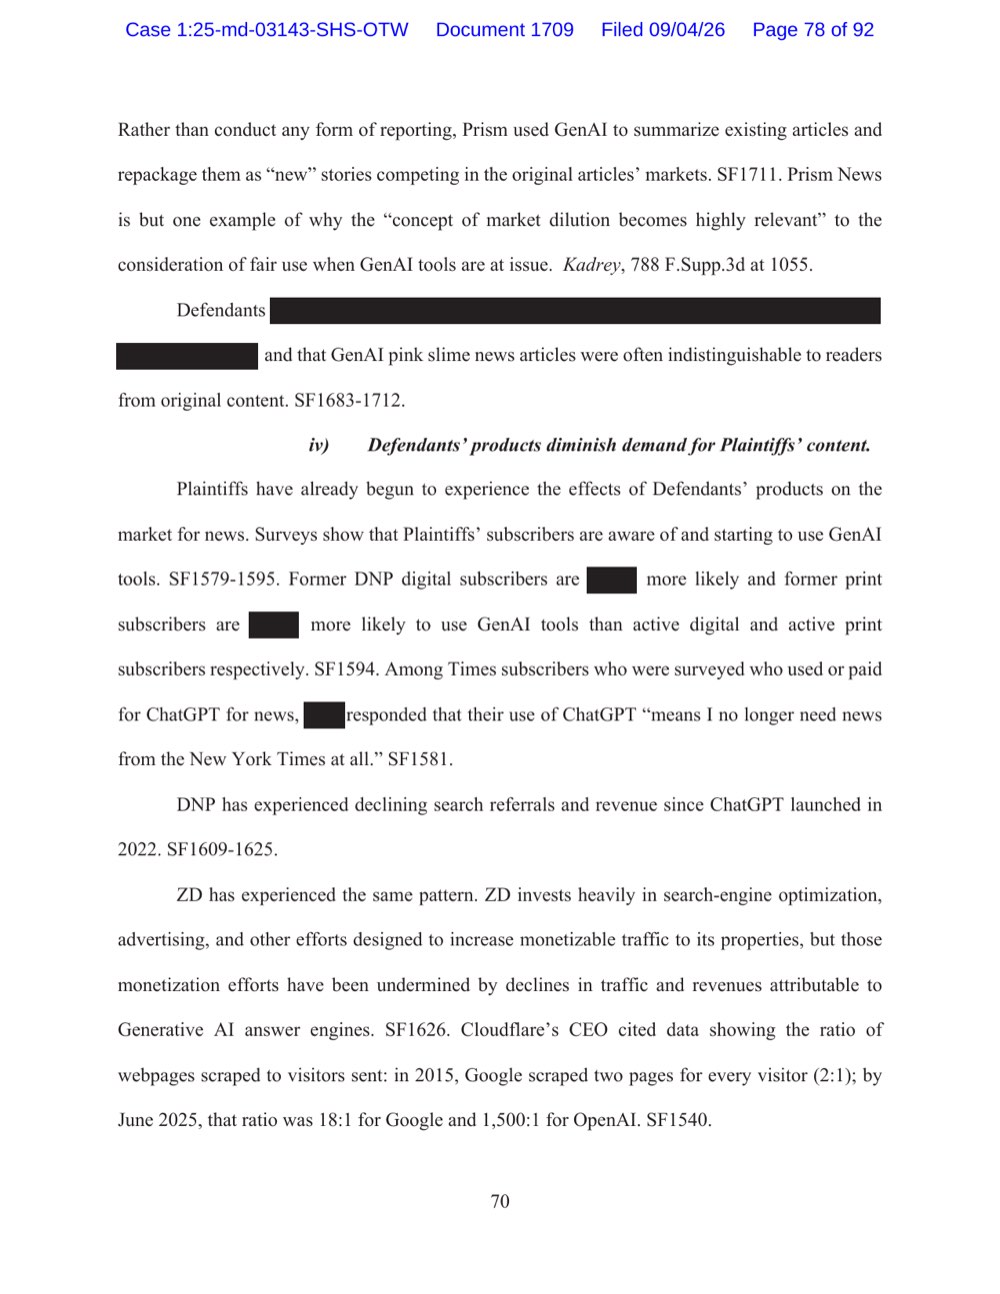
El anexo de hechos añade un tramo intermedio que no aparece en el memorándum: a finales de 2024 la ratio era de 6 a 1 en Google y de 250 a 1 en OpenAI. Es decir, de 250 a 1.500 en unos siete meses.
La cifra tiene un origen concreto. Lo que hay en el expediente es una alegación de los demandantes, no un peritaje ni una medición de un tercero independiente, y cita unas declaraciones de Matthew Prince, CEO de Cloudflare, en una entrevista con Sara Fischer (Axios) grabada en Cannes en junio de 2025. Las pruebas registradas son literalmente el vídeo de YouTube (con los minutos marcados) y el artículo de Axios del 19 de junio de 2025. Cloudflare no es parte en el pleito, la cifra no ha pasado por contradicción pericial y aparece en la sección de daño de mercado de Ziff Davis, no en el bloque principal del Times.
Qué mide el crawl-to-refer de Cloudflare y por qué sus cifras no coinciden
La métrica se llama crawl-to-refer ratio, mide el intercambio que está en el centro del debate sobre el SEO para IA (lo que un rastreador se lleva frente a lo que devuelve) y Cloudflare la define de forma estrecha: peticiones de los user agents de una plataforma que devuelven HTML, divididas entre las peticiones de HTML cuya cabecera Referer contiene un hostname de esa plataforma. Es una ratio de rastreo contra referencias medibles, no contra visitas totales.
Para el mismo mes, junio de 2025, el blog oficial de Cloudflare publicó números distintos de los que dijo su CEO: «As of June 2025, we find that Google crawls websites about 14 times for every referral... In June 2025, OpenAI's crawl-to-referral ratio was 1,700:1, Anthropic's 73,000:1». O sea, 14 a 1 en Google y 1.700 a 1 en OpenAI, frente a los 18 y 1.500 que fueron al expediente. La misma empresa, el mismo mes, dos pares de cifras que no coinciden. Los demandantes llevaron al expediente la versión en vídeo.
Para julio de 2025, con la serie por operador que Cloudflare publicó el 29 de agosto de ese año, el reparto quedaba así:
| Operador | Páginas rastreadas por referencia (julio 2025) |
|---|---|
| Anthropic | 38.000:1 |
| OpenAI | 1.091:1 |
| Perplexity | 195:1 |
| Microsoft | 38,5-45,1:1 |
| Yandex | 21,4:1 |
| 5,4:1 |
La propia Cloudflare avisa de un sesgo de la medición: las referencias que llegan desde la app nativa de Claude no llevan cabecera Referer, así que no se cuentan y la ratio de Anthropic sale inflada. Con esa salvedad, la tendencia de fondo se sostiene en todas las versiones del dato, y en julio de 2026 el panel público de Cloudflare seguía registrando ratios que van desde 118 a 1 hasta cerca de 50.000 a 1 según el rastreador. Entre unos rastreadores y otros la diferencia llega a dos órdenes de magnitud.
Qué contesta OpenAI: el 0,00012% y los denominadores
La moción de OpenAI va por otro lado. Según la lectura que ha hecho PPC Land (su memorándum no está disponible en abierto, así que esto no lo he podido contrastar contra el original), la compañía sostiene que la reproducción literal de artículos es residual: 24 casos de regurgitación textual en una muestra de 20 millones de conversaciones de ChatGPT, un 0,00012%. Añade que los pasajes literales más largos que se han encontrado son de 29 y 43 palabras, y que 710 obras elegidas al azar produjeron más de 68.000 respuestas sin una sola regurgitación.
Las cifras de una parte y de la otra no son directamente comparables, porque los denominadores son distintos. El 0,00012% está calculado sobre conversaciones muestreadas; cuando los peritos de la parte contraria fuerzan la máquina con más de 250 millones de prompts, modelos GPT no públicos y configuraciones accesibles solo por API, el resultado es regurgitación parcial en menos del 2,6% de las obras reclamadas, con una extracción media inferior al 4,4%. OpenAI lo compara con el 16% de Google Books, donde el Segundo Circuito sí apreció uso legítimo. Son porcentajes sobre poblaciones distintas y no se pueden restar entre sí.
Hay más discusión sobre el propio recuento de obras: los demandantes alegan 10,8 millones, OpenAI responde que los peritos contrarios solo sostienen el uso de 6,3 millones en entrenamiento, y el Times reclama en concreto 6.030.928 artículos publicados entre 1928 y 2024. En el escrito de los demandantes hay otro cálculo: con los precios de API publicados por OpenAI, generar un millón de artículos sintéticos de unas 500 palabras costaría en torno a 6.800 dólares, sin un solo redactor ni editor. Sobre lo que le cuesta al Times producir periodismo circula la cifra de unos 2.000 millones anuales, que no aparece en las mociones: la dijo su CEO, Meredith Kopit Levien, en agosto de 2026.
Un apunte sobre el material disponible. Las versiones públicas llegaron con tachaduras: los datos internos de Microsoft sobre la caída de CTR de Copilot frente a Bing en los dominios del Times, Daily News y Ziff Davis están en el expediente con las cifras en negro, igual que una categoría entera de copia alegada por los demandantes. Lo que se puede leer es una parte del argumento, no el argumento completo.
Seattle Times y Newsday demandan el mismo día
El 4 de septiembre, con sello de registro Filed 09/04/26, The Seattle Times Company y Newsday LLC presentaron su propia demanda contra OpenAI y Microsoft en el mismo distrito (caso 1:26-cv-07644). Buena parte de la cobertura la fecha el viernes 5, pero el 5 de septiembre de 2026 cayó en sábado y el expediente dice que se registró el día 4, así que mociones y demanda nueva ocurrieron la misma jornada.
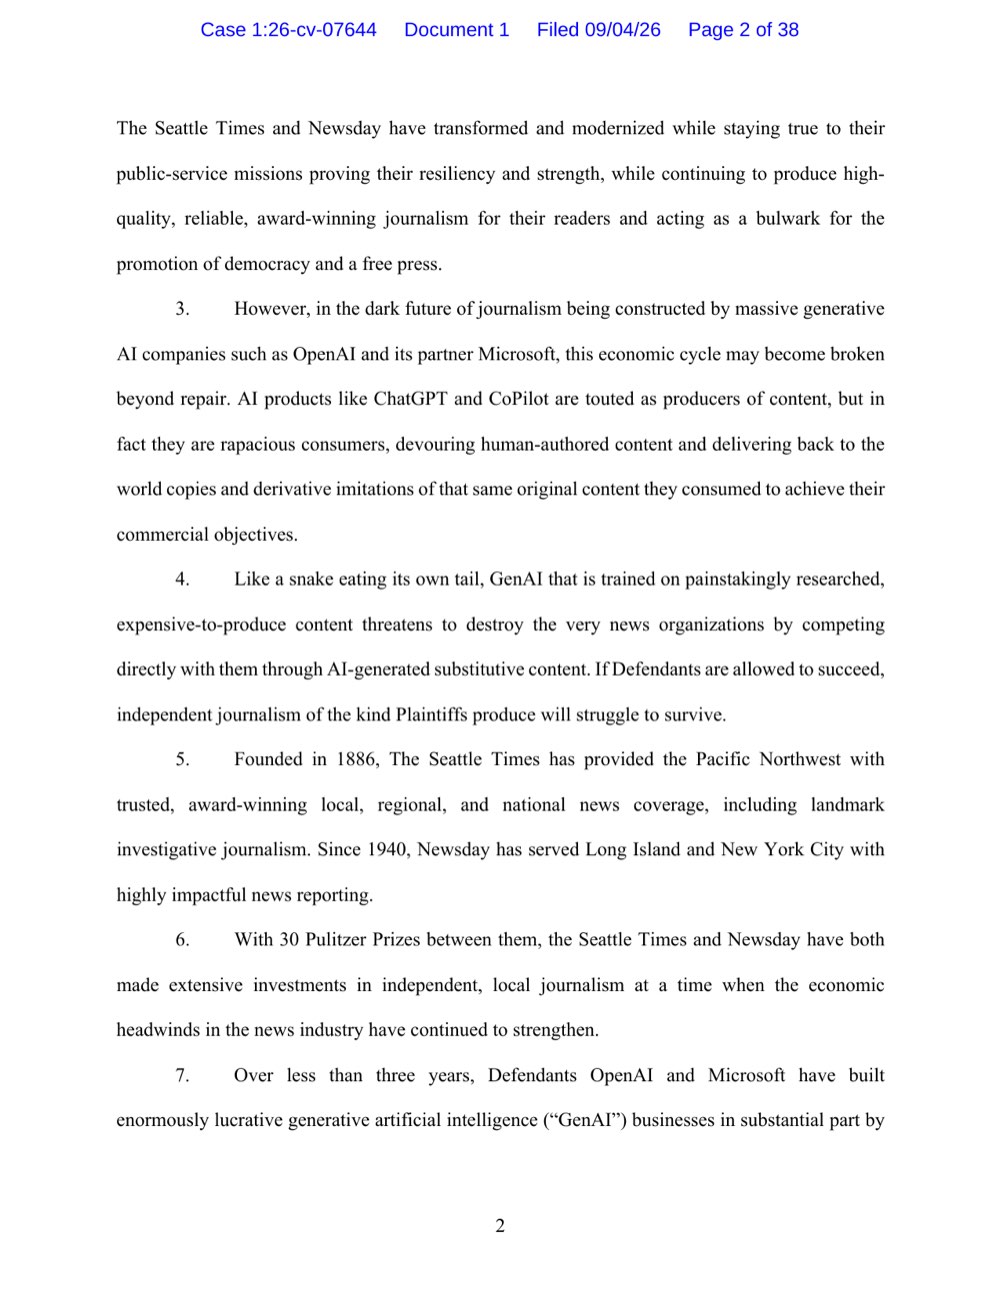
Los demandantes escriben que los productos de IA «are touted as producers of content, but in fact they are rapacious consumers, devouring human-authored content» (se venden como productores de contenido y en realidad son consumidores rapaces), y que, «like a snake eating its own tail», la IA generativa entrenada con contenido caro de producir amenaza con destruir a las propias redacciones que lo producen. La petición incluye algo más que los daños: piden al amparo del 17 U.S.C. § 503 la incautación o destrucción de las copias, de los datasets de entrenamiento y de los propios modelos que incorporen sus obras. Son siete causas de acción, incluidas dos por eliminación de información de gestión de derechos (DMCA § 1202(b)) y tres de dilución de marca.
Hay un detalle que añade TechCrunch y que no está en la demanda: Microsoft y OpenAI han financiado becas y proyectos periodísticos del propio Seattle Times, sin que se conozcan programas ni importes. Microsoft, por su parte, dijo a GeekWire que le sorprende la demanda y que siempre está dispuesta a sentarse a explorar soluciones. En el perfil de los demandantes, a las cabeceras nacionales se están sumando ahora medios regionales.