Cinco modelos y once benchmarks con las entidades sustituidas por etiquetas
El preprint se titula On the Impact of Anonymization on the Performance of Large Language Models y lo firman Tobias Deußer, Max Hahnbück, Lorenz Sparrenberg, Tobias Uelwer, Christian Bauckhage y Rafet Sifa, entre la Universidad de Bonn, el Fraunhofer IAIS y el Instituto Lamarr, con Uelwer desde Microsoft Germany. La primera versión es del 10 de septiembre de 2026 y la segunda del 15. No está revisado por pares: no tiene congreso, revista ni DOI propio.
La pregunta que se hacen es de cumplimiento, no de marketing: si una empresa tiene que quitar los datos personales de un texto antes de mandárselo a un modelo, cuánta calidad de respuesta cuesta esa limpieza. Para medirlo pasan cinco modelos (GPT-4o mini, Teuken-7B, Llama-3.1-8B, Gemma-2-27b y Qwen2.5-72B) por once benchmarks en dos condiciones, el texto original y el texto anonimizado, con temperatura 0 y semilla fija.
Los once benchmarks son ARC, BIG-Bench Hard, EQ-Bench, HellaSwag, IFEval, MedQA, MMLU-PRO, MuSR, RGB, TruthfulQA y la traducción inglés-alemán de WMT 2014. Dejaron fuera a propósito los de código y matemáticas, porque no suelen contener datos personales. De las 38.967 muestras originales recortaron a un máximo por benchmark y se quedaron con 6.210 muestras únicas, de 417,62 tokens de media.
La anonimización no borra: sustituye cada entidad por una etiqueta de categoría más un identificador consistente. El paper lo describe así: "entities are substituted with a category label and a unique, consistent identifier; for example, every occurrence of 'London' within a document is replaced by '<LOC>-1', while 'Berlin' would become '<LOC>-2'". El mapeo se deshace antes de puntuar, de modo que la respuesta se compara con la referencia original. Se anonimiza el prompt entero, ejemplos incluidos.
Un detalle sobre quién mide qué. La herramienta que hace la detección y la sustitución es del propio grupo de investigación, publicada por ellos en 2025, y declara un F1 por encima del 88% y un recall por encima del 91%. El paper no lo señala como conflicto de interés.
El benchmark de recuperación cae de 0,80 a 0,32 y el resto aguanta
El resultado general es que quitar los nombres propios sale barato en casi todo. En ARC, HellaSwag e IFEval las caídas se quedan, en palabras del paper, "typically under 5 percentage points". La excepción es RGB, el único de los once que mide generación aumentada por recuperación, es decir, responder integrando varios documentos que se le pasan al modelo. Ahí se hunden los cinco modelos.
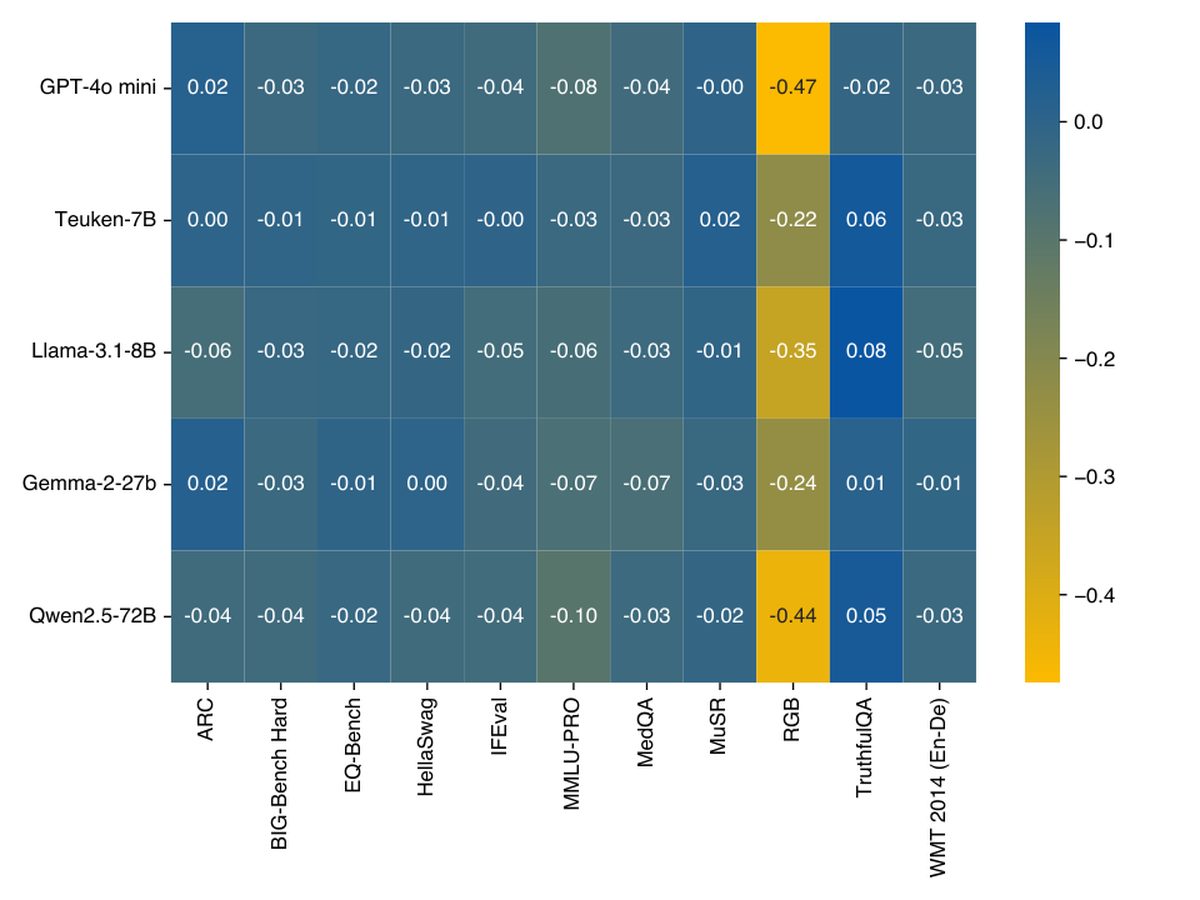
Las cifras de RGB, modelo a modelo: GPT-4o mini pasa de 0,80 a 0,32, Qwen2.5-72B de 0,82 a 0,38, Llama-3.1-8B de 0,69 a 0,34, Gemma-2-27b de 0,63 a 0,39 y Teuken-7B de 0,53 a 0,31. El titular del 60% es una conversión, no una cita: el paper habla de unos 48 puntos porcentuales en GPT-4o mini y no escribe «60%» en ningún sitio. Los 0,48 sobre los 0,80 de partida son, efectivamente, un 60% de pérdida relativa.
La generalización de que «las tareas de razonamiento apenas se mueven» hay que matizarla mirando el mapa de calor. MMLU-PRO llega a perder 10 puntos en Qwen2.5-72B (de 0,71 a 0,61) y 8 en GPT-4o mini, y MedQA pierde 7 en Gemma-2-27b. El «por debajo de 5 puntos» vale para tres benchmarks concretos, no para todo lo que no sea RGB.
Sobre la idea de que los modelos más capaces sufren más, el dato es que Qwen2.5-72B pierde 6,9 puntos de media y Teuken-7B solo 2,3. Hay que cogerlo con pinzas: Teuken-7B saca 0,00 en ARC y en HellaSwag en las dos condiciones, y Gemma-2-27b saca 0,00 en HellaSwag también en las dos. Un modelo que no sabe hacer la tarea no tiene nada que perder, y eso le infla la robustez aparente.
Avisar al modelo tampoco arregla nada. Los autores prueban a anteponer al prompt un aviso, corto ("This prompt is anonymized. Some context may be missing; respond as accurately as possible") o largo, y en RGB el resultado empeora respecto a no avisar: 0,29 con aviso frente a 0,32 sin él, partiendo de 0,80. El modo de fallo que describen: preguntado por qué país europeo tiene más premios Nobel de ciencia, con «Europe» convertido en una etiqueta, el modelo se inventó un marcador propio, <COUNTRY NAME>. Lo resumen así: "the model does not adapt its reasoning to the anonymization scheme and may fabricate answers outside the tagging system".
Generalizar hunde el resultado y aleatorizar lo conserva
Los autores comparan además seis formas distintas de tratar el texto, medidas sobre GPT-4o mini en MedQA, MuSR y RGB. Partiendo de 0,80 en RGB sin tocar nada: generalizar deja el resultado en 0,09 («London» pasa a una categoría genérica sin identificador), tachar el dato lo deja en 0,12, enmascarar en 0,26, pseudonimizar en 0,34 y sustituir por una cadena aleatoria consistente en 0,37.
La regla que se dibuja es que lo reversible y consistente conserva más que lo irreversible, porque el modelo puede seguir distinguiendo una entidad de otra aunque no sepa cuál es. Pero no se cumple en todas las tareas: en MedQA, tachar (0,83) empata con pseudonimizar (0,83) y enmascarar (0,87) queda por encima de los dos. De ahí la conclusión de los autores, que es la frase que más se repite en el paper: "anonymization is not a one-size-fits-all solution and must be co-designed with the model and task in mind to balance privacy and utility effectively".
Lo que no consiguen es explicar el mecanismo. Buscaron correlación entre la caída de rendimiento y el número de entidades, el número de entidades únicas y la longitud de la entrada, y no encontraron ninguna estadísticamente significativa. Es decir, saben que RGB se desploma y MuSR no, pese a tener entradas largas y densidad de entidades parecida, pero no saben por qué.
Lo que el preprint no mide, y por qué no es un estudio de SEO
El paper no menciona ni una vez contenido web, buscadores, posicionamiento, recuperabilidad de páginas ni marcas. El sujeto implícito es una empresa que pseudonimiza sus propios documentos antes de mandarlos a una API de terceros, y el problema es de protección de datos. Cualquier salto de aquí a «escribe el nombre de tu marca en tus páginas para que te recuperen los motores generativos» es una analogía de quien la haga, no un hallazgo de Deußer y sus coautores. Sobre lo que sí hay trabajo publicado en cuanto a recuperabilidad de contenido, está Cómo aparecer en ChatGPT.
El preprint tampoco tiene sección de limitaciones, ni de amenazas a la validez. Lo más parecido es un párrafo de trabajo futuro donde proponen anonimizar de forma más granular según el tipo de entidad. Y arrastra descuidos de edición que se ven a simple vista: el pie de la Figura 1 describe un modelo de detección de contradicciones de otro trabajo del mismo grupo, la Tabla 4 repite el contenido de la Tabla 1, y en la versión anterior la cabecera de cada página llevaba el título de un paper distinto sobre clasificación de documentos inmobiliarios. Esa cabecera es lo único que corrigió la segunda versión: ningún dato cambió entre la v1 y la v2.
Hay además cifras que no cuadran entre tablas y figuras del propio documento. El MedQA de GPT-4o mini sin anonimizar aparece como 0,88 en una tabla, 0,90 en una figura y 0,89 en otra, y el RGB pseudonimizado como 0,32 en un sitio y 0,34 en otro, pese a que todas las ejecuciones son con temperatura 0. El paper tampoco dice qué métrica concreta produce ese 0,80 y ese 0,32 de RGB: se limita a decir que usa «las métricas estándar de cada benchmark».
La única cobertura editorial del estudio, ppc.land, añade por su cuenta el contexto regulatorio europeo que el paper no trae, empezando por la doctrina de que un dato pseudonimizado sigue siendo un dato personal bajo el Reglamento General de Protección de Datos. Ese es el encaje real del trabajo: qué precio pagas en calidad por cumplir.