Claude lanza búsqueda en el 83% de los prompts y GPT-5.3 en el 14%
El preprint se titula Characterizing Web Search by Conversational LLM Agents y se subió a arXiv el 16 de septiembre de 2026. Lo firman doce autores, ocho de ellos del Max Planck Institute for Software Systems, con gente de la Universidad del Sarre, la Ruhr-Universität Bochum, la École Polytechnique y la Universidad Nacional de Seúl, más un autor de Microsoft, Manish Gupta. No está revisado por pares y se publica con licencia CC BY 4.0.
Dentro hay dos estudios. El primero, que los autores llaman invivo, se apoya en conversaciones reales donadas por 613 usuarios reclutados en Prolific, que pidieron a cada plataforma el export de sus datos al amparo del artículo 15(3) del RGPD y lo cedieron con consentimiento informado y aprobación del comité ético. Son 171.264 conversaciones y 845.008 turnos, de los que 48.703 llevan búsqueda web. El reparto está muy escorado: ChatGPT aporta 143.730 conversaciones del total, y Claude, Grok y DeepSeek rondan las 9.000 cada uno.
El segundo, invitro, manda los mismos 1.000 prompts por API a GPT-5.3-chat, Claude Sonnet 4.6, Grok-4.3 y DeepSeek-v4-flash. De ahí salen las cifras de invocación de búsqueda: Claude Sonnet 4.6 busca en 825 de los 1.000 prompts, Grok-4.3 en 766, DeepSeek-v4-flash en 584 y GPT-5.3-chat en 140. El paper lo resume así: "while GPT calls Web search for only 140 (14% of) prompts, Claude calls Web search for 825 (83% of) prompts".
Ese 83% no es una tasa poblacional, y el diseño del experimento explica por qué. Los 1.000 prompts se muestrearon del propio conjunto de ChatGPT de forma equilibrada: 500 que en su día dispararon búsqueda y 500 que no, usando solo el primer mensaje del usuario y sin historial. Lo que mide, entonces, es cuánto busca cada modelo ante la misma mezcla de preguntas, no cada cuánto busca un usuario cualquiera. En las conversaciones reales la proporción de turnos con búsqueda es bastante más baja en las cuatro plataformas.
En número de consultas también hay diferencias. Sobre las conversaciones reales, la mediana va de 2 consultas por prompt en Claude a 4 en Grok, con máximos por encima de diez, y las medias quedan en 3,07 para ChatGPT, 1,80 para Claude, 4,55 para Grok y 2,63 para DeepSeek. En la interfaz real, ChatGPT, Grok y DeepSeek disparan varias consultas en paralelo en cada iteración (el fan-out de toda la vida), mientras que Claude lanza una sola por iteración y encadena más vueltas. Por API el comportamiento se invierte y solo GPT-5.3 hace fan-out, algo que los autores atribuyen al andamiaje del producto y no al modelo.
Cada agente devuelve una lista de dominios que apenas se solapa
El estudio saca el top 10 de dominios por resultados devueltos en cada plataforma y las listas no se parecen. En ChatGPT mandan reddit.com, wikipedia.org y youtube.com; en Grok, youtube.com, reddit.com y facebook.com; en DeepSeek, youtube.com, wikipedia.org y reddit.com. En Claude no aparecen ni reddit.com ni youtube.com: su lista la encabezan amazon.com, github.com, wikipedia.org y learn.microsoft.com, seguidos de stackoverflow.com y sciencedirect.com.
Los autores lo dejan escrito con signo de exclamación incluido: "reddit.com and youtube.com dominate search results returned by ChatGPT and Grok and also rank highly in DeepSeek search, but they are completely absent in Claude search!". Y añaden una segunda observación, que no está claro que el usuario sea consciente de esas preferencias ni de si constituyen sesgos indeseados de la plataforma.
El volumen de resultados también cambia, y es pequeño. Por consulta, ChatGPT devuelve una media de 14,06 URLs, Claude 9,19, Grok 8,95 y DeepSeek 5,46. Sumando todas las consultas de un mismo prompt, ChatGPT llega a 43,24 URLs y DeepSeek se queda en 14,37. Los autores subrayan que es mucho menos de lo que ofrece una SERP de Google y que la concentración es alta: el top 10 de dominios acapara el 21,3% de todos los resultados de ChatGPT y el 32,3% de los de Grok.
Entre el 15% y el 53% de las afirmaciones se apoyan en URLs que nunca se citan
El método para medir la atribución es este. Cada respuesta se descompone en afirmaciones atómicas, se rastrea el contenido de las URLs citadas y de las recuperadas, y un modelo juez de la misma familia que la plataforma decide de dónde sale cada afirmación. La atribución es jerárquica y excluyente: primero la cita inmediatamente posterior, luego cualquier otra cita de la respuesta, luego las URLs que el buscador devolvió y la respuesta nunca citó, y lo que no encaja en ninguna se marca como conocimiento propio del modelo. Un estudio con anotadores humanos da un 93% de acuerdo con el juez automático.
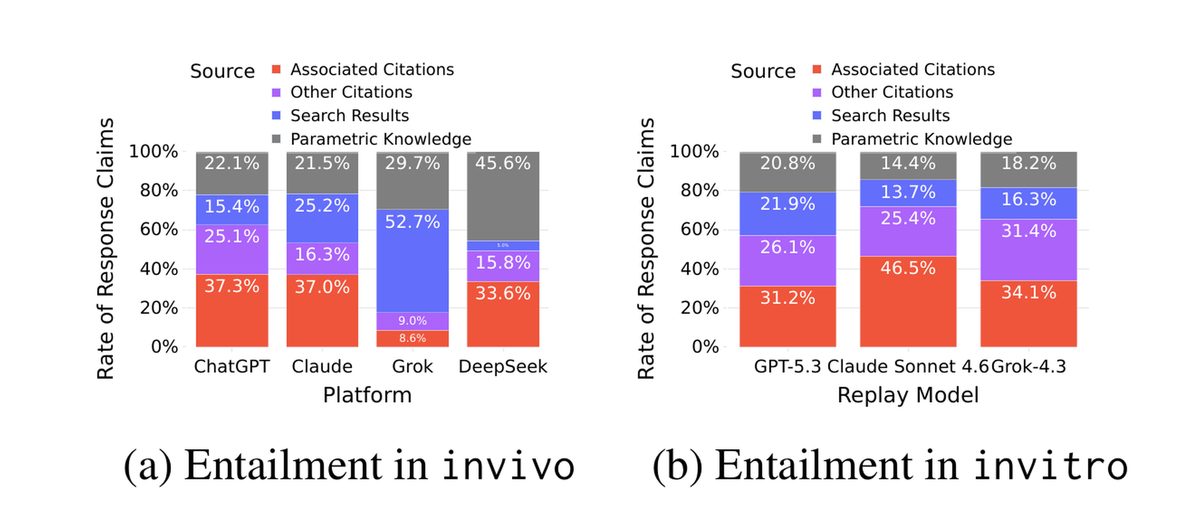
Sobre las conversaciones reales, esa banda de URLs recuperadas y no citadas es del 15,4% en ChatGPT, del 25,2% en Claude y del 52,7% en Grok. Los autores lo formulan así: "these uncited, yet searched URLs, consistently account for 14% to 53% of all claims", y añaden que el comportamiento plantea dudas sobre si los agentes están atribuyendo correctamente el crédito a las URLs de origen.
DeepSeek aparece con un 5,0% en esa misma banda, pero el paper lo deja fuera de la frase anterior y explica por qué en un apéndice: su formato de export solo engancha citas a URLs de resultados, así que el resto es inobservable por construcción. De hecho, DeepSeek es la plataforma con más afirmaciones sin fundamentar en ninguna URL recuperada, un 45,6%, frente al 22,1% de ChatGPT, el 21,5% de Claude y el 29,7% de Grok.
La otra cara del mismo asunto es la tasa de citación, es decir, qué fracción de las URLs que devuelve el buscador acaba citada en la respuesta. En las conversaciones reales es del 13,3% en ChatGPT, del 19,9% en Claude, del 34,1% en DeepSeek y del 1,8% en Grok. En absolutos, Grok recupera 110.684 URLs y cita 1.950, unas 0,7 citas por respuesta. Las citas inventadas, en cambio, son raras: entre el 1% y el 2% en los dos escenarios.
Un dato más para quien trabaje contenido. Comparando los rangos Tranco de los dominios, las URLs que acaban citadas vienen de sitios mejor posicionados que el conjunto de las recuperadas. El buscador de la plataforma devuelve una cosa y el modelo tiende a citar lo más popular de lo que le han devuelto.
Lo que el estudio no puede decir
Los autores dedican una sección a los límites. El primero es que no ven dentro de la caja: los registros no exponen el razonamiento interno, ni los algoritmos de ranking, ni los pipelines de recuperación, así que parte de lo observado puede venir del producto y no del modelo. Lo escriben tal cual: "some observed behaviors may reflect platform-specific harness implementations rather than the underlying language models alone".
El segundo es la muestra: 613 usuarios de Prolific, sin cuotas por país, con los conjuntos de datos muy desequilibrados y, sobre todo, el estudio es solo en inglés y solo sobre texto. No hay ni un dato de consultas en español ni de mercados no anglosajones. El tercero es que casi todas las etiquetas las pone un modelo juez: hay validación humana, pero en la métrica de factualidad el acuerdo entre juez y humano baja al 66,7% y la concordancia entre los propios anotadores humanos es prácticamente nula.
Hay además dos ausencias en el estudio: ni Gemini ni Perplexity están evaluados. Las versiones que sí lo están (GPT-5.3-chat, Claude Sonnet 4.6, Grok-4.3 y DeepSeek-v4-flash) son una foto de mediados de 2026 que se queda vieja cada pocos meses. Tampoco hay ningún dato de tráfico, clics ni conversión: el paper mide qué se recupera y qué se cita, no qué gana un sitio por aparecer ahí.
Mi lectura
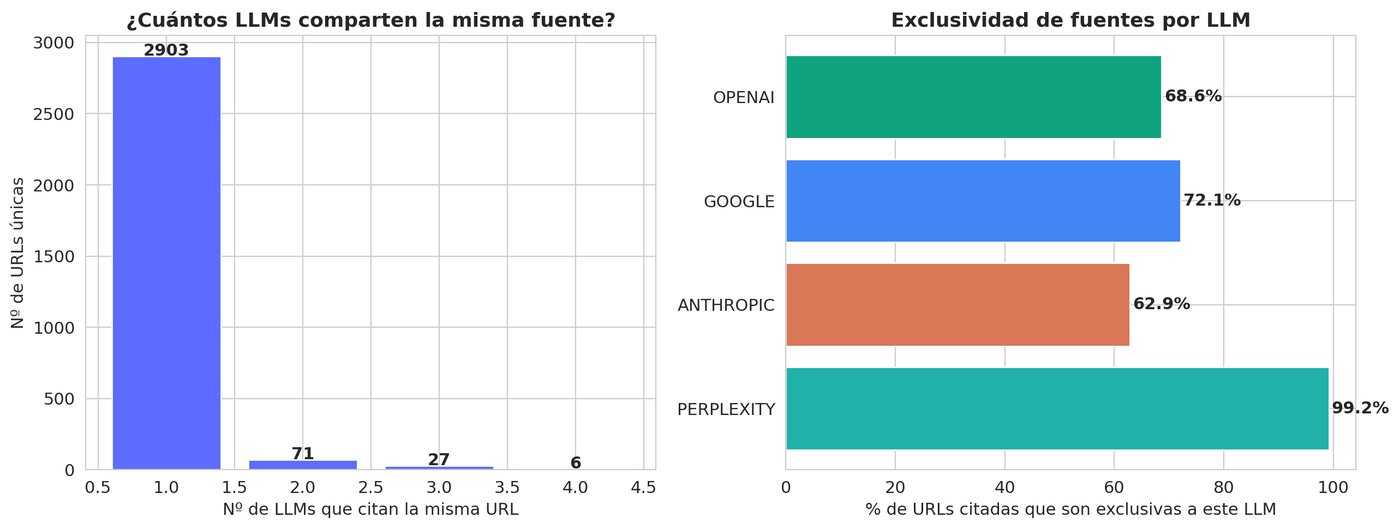
Lo de que cada plataforma es un buscador distinto ya lo medí con datos propios, y con una muestra que no es pequeña. En el estudio de patrones de citación que publiqué con Clicandseo en abril, sobre 21.614 citaciones recogidas durante 59 días en cuatro modelos y tres sectores, el 96,5% de las 3.007 URLs citadas aparecía en un solo LLM, y solo seis URLs, el 0,2%, eran citadas por los cuatro a la vez. La exclusividad iba del 62,9% de Anthropic al 99,2% de Perplexity, y el tipo de fuente también cambiaba de arriba abajo: Anthropic mandaba el 55,2% de sus citas a dominios oficiales y Perplexity el 3,2%. Lo que escribí entonces se sostiene igual de bien hoy, y es que la idea de optimizar para LLMs como una sola estrategia no aguanta los datos.
La distancia entre lo que el modelo recupera y lo que cita la medí en el tutorial de Query fan-out de ChatGPT: una ejecución de Responses API con gpt-5.5 dejó 92 URLs en las fuentes de las llamadas y 13 en las citas de la respuesta. Escribí entonces que aquello no daba para calcular ninguna probabilidad de citación, y sigue sin darla, pero el paper sí la calcula sobre 171.264 conversaciones y a ChatGPT le salen 13,3 citas por cada 100 URLs recuperadas.
Ahora, lo que el estudio no dice. Es un preprint sin revisar, en inglés y con 613 usuarios de Prolific, y la lista de dominios que sale ahí es la de ese conjunto de conversaciones, no la de tu sector ni la del mercado español. Cogerla como mapa de dónde hay que estar sería inventar, igual que lo sería coger la mía: mi estudio cubre tres sectores y un periodo de dos meses, y lo dejé escrito en sus limitaciones. Lo que sí aguanta en los dos es el mecanismo: cada plataforma tiene su índice, es pequeño comparado con una SERP y está muy concentrado. Trabajar el SEO para IA con la cabeza puesta en una sola plataforma es la vía rápida a llevarte una sorpresa el día que el cliente pregunte por otra.