WebFetch en la app de Claude: un modelo pequeño lee la página y Opus recibe su respuesta
Anthropic lanzó Opus 5.5 el 22 de septiembre de 2026 y ese mismo día apareció su system prompt en CL4R1T4S, el repositorio de GitHub donde Pliny publica las instrucciones internas de los modelos. Quien ha puesto el foco en la parte de búsqueda es Natzir Turrado, que sigue estos leaks para entender cómo leen la web los LLM. El prompt corresponde a la app de Claude que ya integra Cowork (dice literalmente que "Cowork's capabilities are now part of Claude") y aclara que ese entorno está construido sobre Claude Code y que sus herramientas vienen de ahí.
La herramienta para leer páginas se llama WebFetch y su descripción ocupa una línea: "Fetches a URL, converts the page to markdown, and answers `prompt` against it using a small fast model". Cada llamada lleva dos parámetros, la URL y un prompt que escribe Opus. El resultado es que Opus no lee la página, lee lo que el modelo pequeño contesta sobre ella. El leak no dice qué modelo es ese.
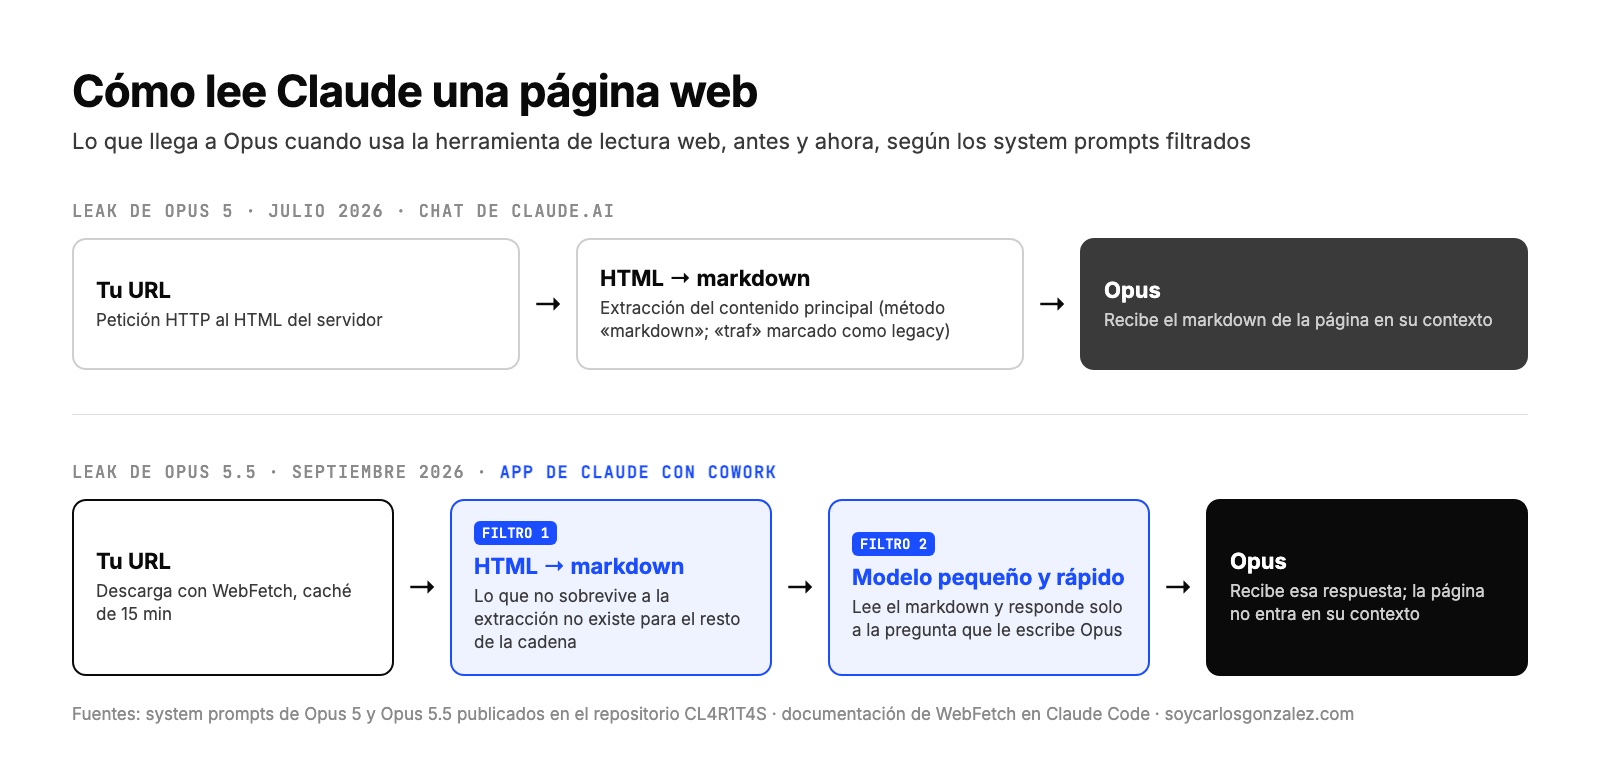
La documentación oficial de Claude Code describe WebFetch de la misma forma: descarga la página, la pasa a markdown cuando el servidor devuelve HTML y ejecuta el prompt sobre el contenido con un modelo pequeño y rápido. Anthropic la define como «lossy by design», con pérdida de información por diseño, y añade una advertencia: "a result that says a page doesn't mention something may only mean the prompt didn't ask about it". La misma documentación dice que las páginas grandes se truncan a un límite fijo de caracteres antes de procesarlas, que el agente se identifica con un User-Agent que empieza por Claude-User y que pide markdown en la cabecera Accept.
El resto de la descripción de WebFetch en el leak coincide con esa documentación. Las respuestas se guardan en caché 15 minutos por URL, el HTTP se fuerza a HTTPS y las redirecciones a otro dominio no se siguen: la herramienta devuelve la URL de destino y Opus tiene que pedirla en una segunda llamada. El prompt añade que WebSearch y WebFetch rechazan algunos sitios por motivos legales y que, cuando pasa, Claude no debe saltárselo con curl, una petición de Python, una caché o un mirror.
Qué hacía Opus 5 en julio: el markdown entraba entero en el contexto
El prompt de Opus 5, publicado en el mismo repositorio el 24 de julio de 2026, describía otra herramienta, web_fetch, con un parámetro html_extraction_method cuya descripción dice que "'markdown' produces better content extraction than the legacy 'traf' method". Tenía además un límite de tokens para "Truncate text to be included in the context", es decir, el texto de la página entraba en el contexto del modelo sin un intermediario que lo resumiera.
El «traf» no es nuevo para quien siguió el experimento que Natzir Turrado publicó en noviembre de 2025. Probó quince maquetaciones del mismo producto y vio que Claude perdía precios metidos en un footer o descripciones dentro de un aside, algo compatible con un extractor de contenido principal tipo Trafilatura o Readability. Él mismo encontró la abreviatura «traf» en el esquema interno y avisó de que sugería, pero no confirmaba, que fuera Trafilatura. En julio ese método ya aparecía como legacy; en septiembre, en la app, la página pasa además por el modelo pequeño.
Cómo decide buscar Claude: un párrafo en lugar del bloque de instrucciones
El prompt de Opus 5 tenía un bloque de pautas de búsqueda con consultas de 1 a 6 palabras ("Queries short and specific, 1-6 words. Start broad (1-2 words), then narrow"), rangos de llamadas según la complejidad (de 1 a 20) y la preferencia por fuentes originales frente a agregadores. En el de Opus 5.5 ese bloque no aparece. El criterio cabe en un párrafo: Claude busca antes de afirmar cualquier cosa que describa el mundo tal como está ahora ("who holds a role, what something costs, whether a rule is still in force, how things currently rank"), aunque la respuesta le resulte familiar, y hace él mismo casi toda la investigación "because one finding usually shapes the next search".
El orden de las fuentes también está escrito. Primero los conectores para los datos del propio usuario, luego WebSearch y WebFetch para la web pública, y el navegador solo para lo que no pueden hacer los demás: iniciar sesión, rellenar formularios, recorrer un flujo o leer una página que WebFetch no consigue renderizar. WebSearch devuelve títulos y URLs, se define como "US-only" y admite filtros allowed_domains y blocked_domains. Cuando la respuesta se apoya en fuentes enlazables, Claude termina con una lista «Sources:» en formato [Título](URL).
Hay también widgets nuevos que afectan a cómo se muestran las fuentes y los productos. Una tarjeta enseña de 1 a 6 enlaces con título, fuente y extracto, con la instrucción de no inventar nunca una URL y descartar la entrada si no hay una real. Hay tarjetas de producto (una recomendación, una comparativa de dos o tres, un carrusel) y una lista de lugares con fotos que solo puede usar sitios encontrados en la web, porque no puede mostrar datos de Google Places.
La skill deep-research reparte la pregunta entre subagentes en paralelo
La investigación larga va por una skill llamada deep-research, que viene completa en el leak. El procedimiento es descomponer la pregunta en subtemas que no se solapen y lanzar un subagente investigador por cada uno, todos a la vez. La tabla del prompt va de uno a seis o más investigadores según la pregunta, y fija tres como valor por defecto en caso de duda.
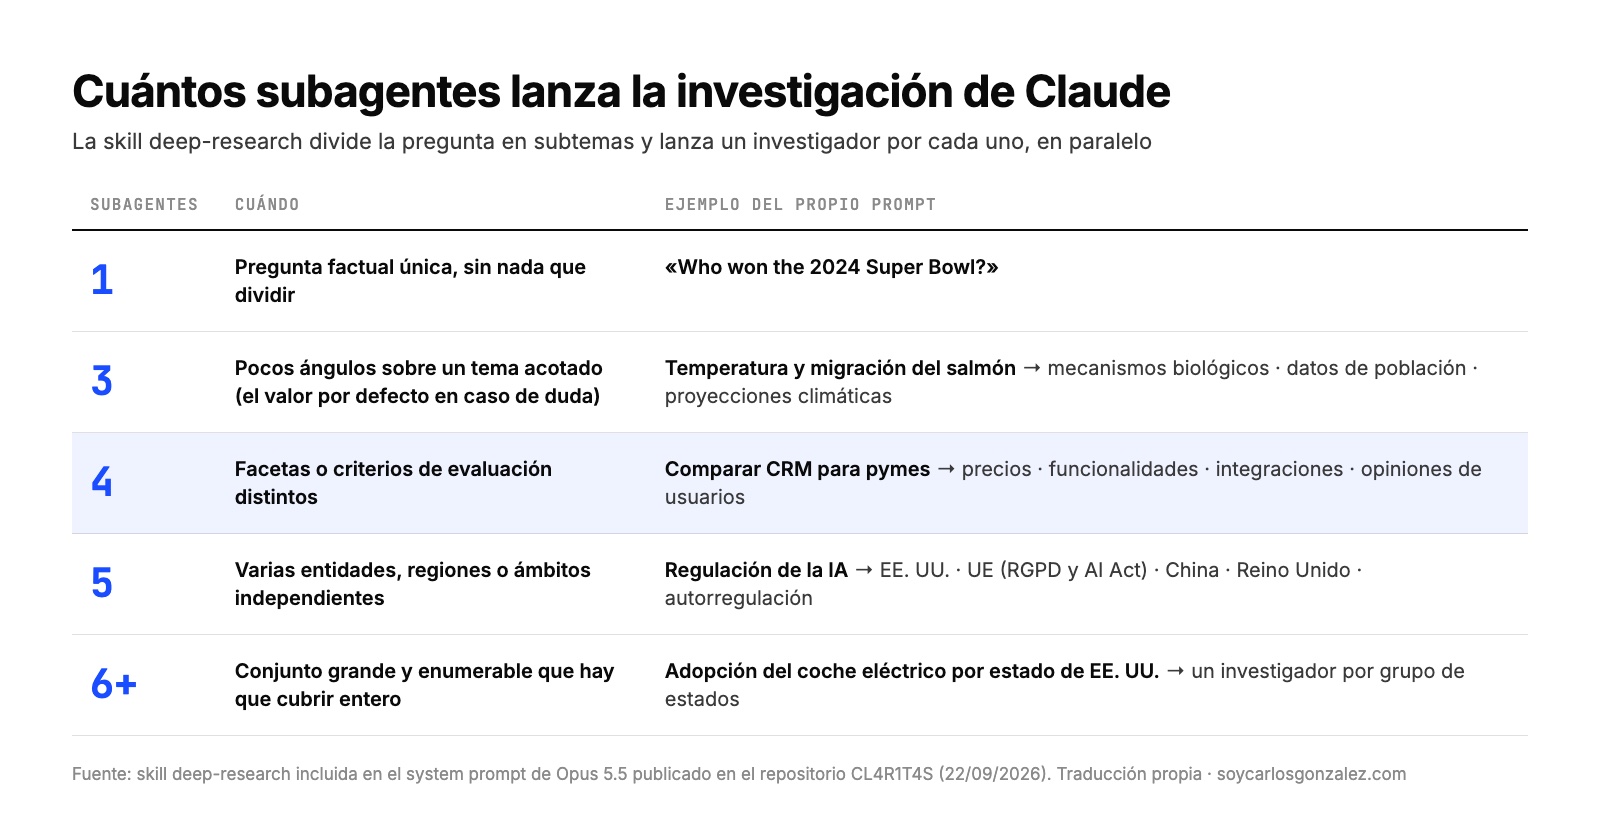
El ejemplo que más interesa en SEO es el comercial: «Compare CRM platforms for small businesses» se parte en precios, funcionalidades, integraciones y opiniones de usuarios, y cada parte la investiga un subagente distinto. La idea no es nueva. Anthropic la explicó en junio de 2025 en su blog de ingeniería, donde contaba que el agente principal lanza de tres a cinco subagentes en paralelo y que una comparación directa puede necesitar de dos a cuatro. Lo que cambia es que ahora está escrita en el prompt con sus umbrales, igual que el query fan-out de ChatGPT reparte una consulta en varias búsquedas.
Mi lectura
Natzir lo resume como un doble filtro y me parece la forma correcta de verlo. Tu contenido tiene que sobrevivir a la extracción de HTML a markdown y, además, tiene que contestar la pregunta concreta que Opus le hace al modelo pequeño, que no es la consulta del usuario sino la que Opus redacta para esa página. Si el precio está en un bloque que el extractor tira, o si la respuesta a lo que se pregunta está repartida entre cinco párrafos que no la dicen claro, el modelo pequeño contesta «no aparece» y Opus se lo cree. La propia documentación lo avisa, y eso cambia qué hay que comprobar cuando haces SEO para IA (GEO).
Lo práctico es que este patrón ya estaba documentado en Claude Code, así que se puede probar hoy pidiéndole a WebFetch una página tuya con preguntas concretas y viendo qué contesta. Una página con el dato en HTML servido desde el servidor, cerca de su encabezado y dicho en una frase que se entienda sin el resto, pasa los dos filtros. Y si la pregunta es comparativa, piensa que cada faceta la va a investigar un subagente por separado, así que la página de precios, la de integraciones y las opiniones tienen que aguantar solas. Con matices, eso sí. Es un leak, Anthropic no lo ha confirmado y el modelo pequeño puede cambiar mañana sin previo aviso.