Qué es Google-Agent y desde cuándo lo documenta Google
Google define Google-Agent como el nombre que usan los agentes alojados en su infraestructura para «navigate the web and perform actions upon user request». En pocas palabras, es el agente de Google que entra en una web y hace cosas en ella porque un usuario se lo ha pedido. Google lo clasifica dentro de los user-triggered fetchers, los rastreadores que se activan por una petición de una persona y no por el rastreo automático.
El nombre no es nuevo. Google lo añadió a su documentación de rastreadores el 20 de marzo de 2026, junto con sus rangos de IP, y entonces la ficha ponía como ejemplo Project Mariner. Ese ejemplo ya no aparece en la ficha actual, y ni la ficha ni la guía nueva nombran hoy ningún producto concreto que use el agente.
El 17 de noviembre el changelog de la documentación de rastreo recoge una entrada nueva, «Added guidance on allowing Google-Agent», con el motivo de ayudar a los editores que quieren habilitarlo en su web. La guía se titula «Allow Google-Agent traffic» y va dirigida a quien gestiona el CDN, el WAF o el servicio de detección de bots, más que al equipo de contenido.
Cómo identificar a Google-Agent: User-Agent, rangos de IP y Web Bot Auth
La guía propone tres comprobaciones. La primera es la cabecera User-Agent, que debe contener Google-Agent. Hay una versión móvil y otra de escritorio, y en la de escritorio el token va dentro del paréntesis de KHTML ((KHTML, like Gecko; compatible; Google-Agent; ...)), así que una regla que solo lo busque al final de la cadena no lo encuentra.
La segunda es la IP, que tiene que estar en el fichero user-triggered-agents.json que publica Google. La versión que he descargado el 18 de noviembre tiene 20 prefijos, 12 IPv4 y 8 IPv6, y está generada el 17 de noviembre. Google regenera ese fichero, así que la fecha y el contenido cambian.
La tercera es la firma criptográfica. Google dice que está experimentando con el protocolo Web Bot Auth usando la identidad https://agent.bot.goog: las peticiones firmadas llevan las cabeceras Signature, Signature-Input y Signature-Agent según el estándar de firmas de mensajes HTTP (RFC 9421), y la web las valida contra las claves públicas que Google publica en ese dominio. Google empezó a documentarlo el 4 de mayo de 2026, lo marca como experimental y avisa de que no firma todas las peticiones de un mismo agente: «We don't sign every request of a particular agent».
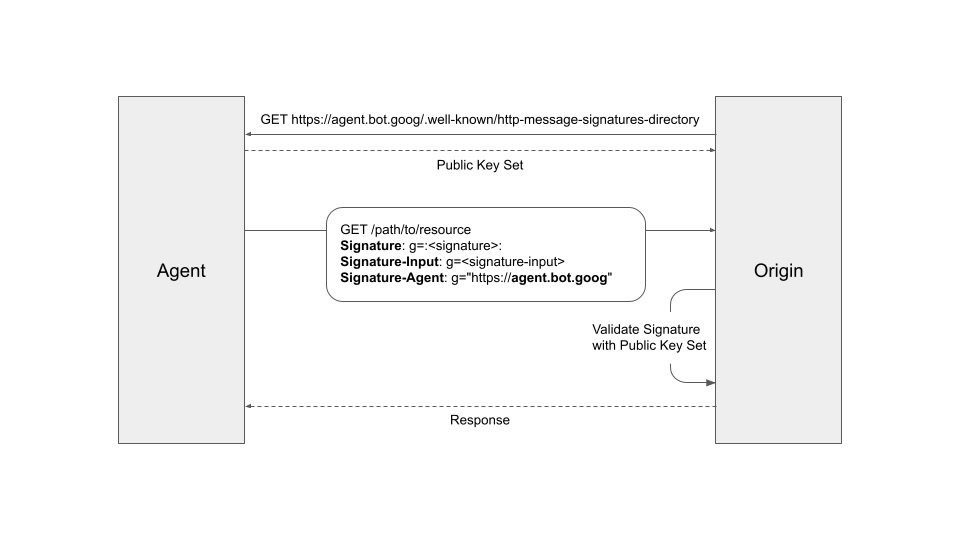
Con esas tres piezas, la guía resume la configuración en cuatro reglas: comprobar el User-Agent, comprobar la IP, verificar la firma «if provided» y, para las peticiones verificadas, «skip bot challenges». Es decir, que una vez identificado el agente no se le pongan CAPTCHA ni retos de JavaScript.
Los seis puntos en los que el CDN o el WAF siguen bloqueando a Google-Agent
La sección de resolución de problemas de la guía recoge seis casos en los que el agente se queda fuera aunque exista una regla para permitirlo. Google los describe así:
- Prioridad de las reglas. La regla que permite a Google-Agent tiene que evaluarse antes que los bloqueos por ASN de nube o centro de datos, las reglas gestionadas de bots y las políticas que bloquean la categoría de agentes de IA.
- Retos interactivos. Hay que saltarse también los CAPTCHA y los retos JavaScript, incluidos los que aparecen al buscar o al enviar un formulario.
- Acciones dentro del recorrido. El permiso tiene que cubrir la búsqueda interna, los filtros, las fichas, el añadir al carrito, las reservas y las llamadas XHR, GraphQL o a subdominios
api.*que hay detrás. - Límites de peticiones por IP. Muchos usuarios salen por el mismo conjunto de IP («concurrent requests from multiple users share the same egress pool»), así que los límites por IP tienen que contemplar los rangos verificados.
- Listas de IP desactualizadas. Las reglas por IP tienen que sincronizarse con el JSON vigente.
- Cabeceras en proxies. Los balanceadores y proxies tienen que conservar la IP original, el User-Agent y las cabeceras de firma.
Search Engine Roundtable y PPC Land publicaron la guía el mismo 17 de noviembre. La lectura de «seis formas de bloquearlo» es de PPC Land; en el documento de Google esa parte se llama «Troubleshooting». Es el mismo problema que planteaba OpenAI al lanzar ChatGPT Wallet, cuando pidió a las tiendas que configurasen su CDN para no bloquear a sus agentes por error (OpenAI lanza ChatGPT Wallet para que sus agentes paguen con tarjeta y pide a las tiendas que no los bloqueen por error).
Google-Agent, robots.txt y lo que la guía no cuenta
La guía solo trata de cómo permitir el acceso. No menciona robots.txt ni explica cómo bloquear a Google-Agent. La página general de los fetchers activados por usuarios sí dice que, como la petición la hace una persona, estos fetchers «generally ignore robots.txt rules». En pocas palabras, una regla de robots.txt no garantiza que el agente no entre, y Google no detalla un comportamiento específico de Google-Agent con ese fichero.
Tampoco hay cifras. Google no da datos de cuánto tráfico genera Google-Agent ni de qué parte de sus peticiones llega firmada. La única forma de saber si una web lo está recibiendo, y con qué respuestas (200, 403, retos), es mirar los logs del servidor y del CDN (Cómo saber qué bots de IA visitan tu web y cuántas veces), y el control de bots es una de las siete áreas que revisa la Auditoría Web Agent.