Puedes saber qué bots de IA solicitan páginas de tu web analizando los logs de acceso del servidor o de tu CDN. El registro permite contar peticiones, identificar URLs y comprobar las respuestas HTTP. Para atribuirlas a un proveedor hay que verificar también la IP de origen con el método que publique ese proveedor.
Para saber si ChatGPT, Claude o Perplexity acceden a tu web, vamos a mirar los logs del servidor. Te voy a enseñar dónde descargarlos, cómo reconocer los user agents de sus bots y cómo analizar las solicitudes con Screaming Frog Log File Analyser.
Al terminar tendrás una tabla con los bots detectados, cuántas solicitudes hace cada uno, qué URLs pide y qué códigos HTTP recibe. Las capturas utilizan un ejemplo sintético para explicar los pasos.
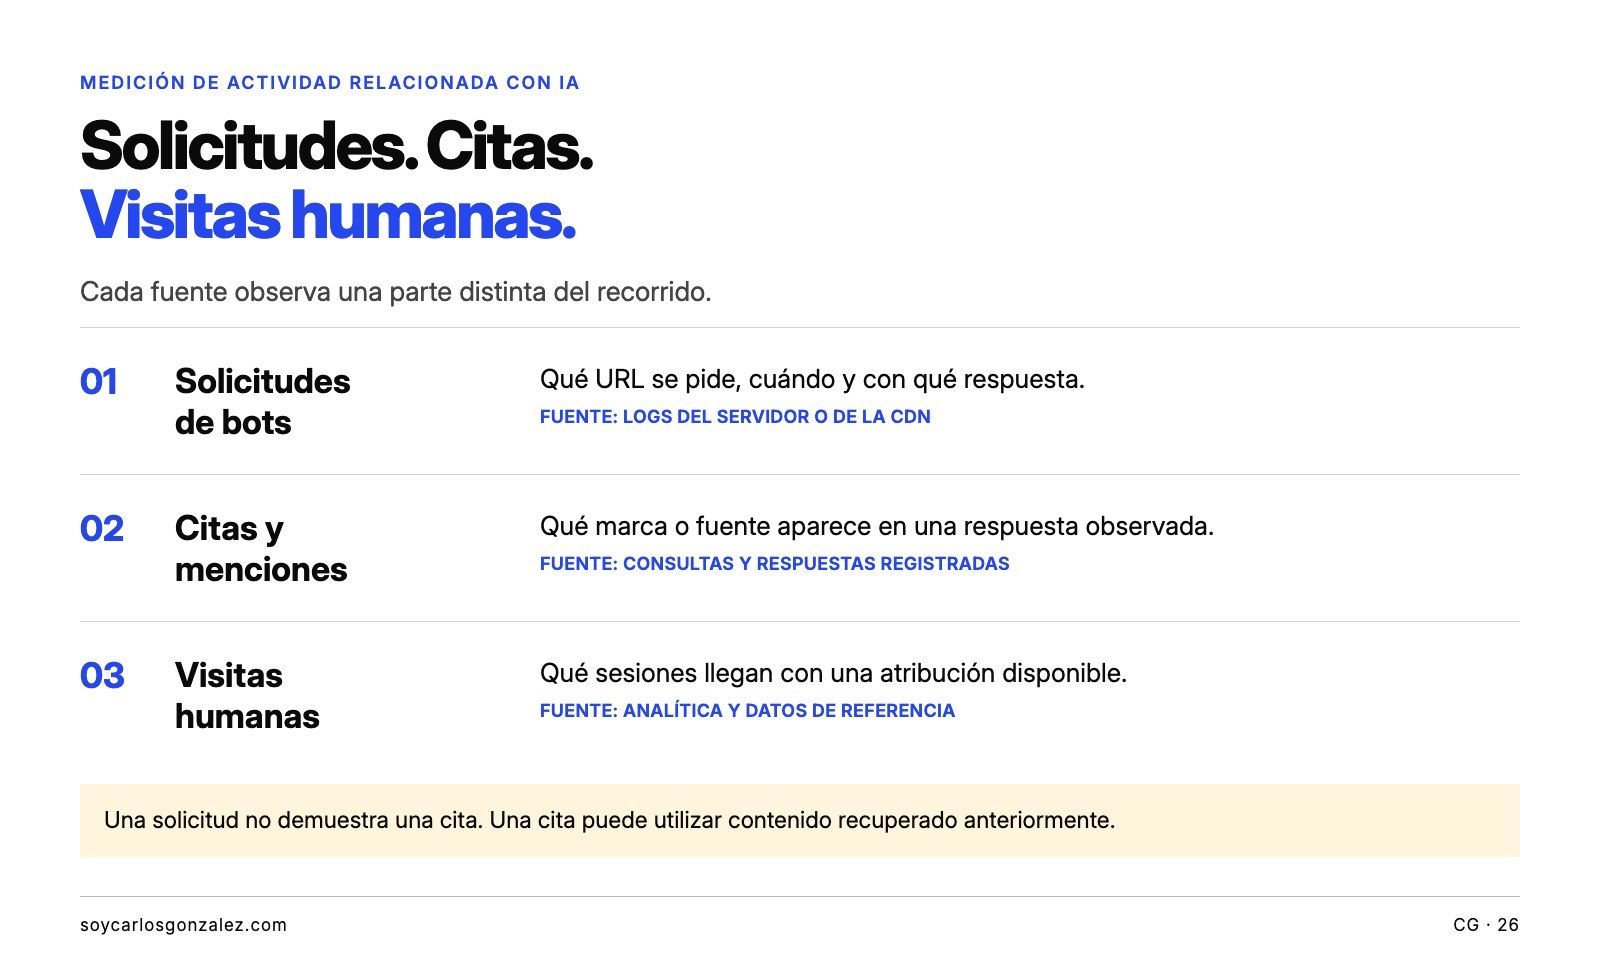
Antes de empezar, conviene fijar qué estamos midiendo. Una solicitud de un bot no acredita una cita en una respuesta de IA. Tampoco permite contar personas ni identificar el modelo que está utilizando un usuario. Aquí vamos a observar accesos a la web y a comprobar qué ocurre en esos accesos.
Qué puedes saber con los logs de acceso
Un access log es un registro de solicitudes recibidas por una capa de tu infraestructura. En un hosting puede ser el servidor web; si utilizas una CDN, esta tiene su propio registro de lo que recibe y responde.
Una petición a /blog/guia-seo/ puede dejar una línea con la fecha, la IP, el método, la ruta, el estado HTTP y el identificador del cliente. Con esas líneas podemos contar actividad y reconstruir qué páginas se solicitaron durante un periodo.
El resultado que buscamos tiene esta estructura:
| Dato | Qué estamos contando | Cómo lo interpretaría |
|---|---|---|
| Solicitudes | Eventos registrados para un bot. | Una URL puede tener muchas peticiones, incluidas revalidaciones y reintentos. |
| URLs distintas | Direcciones diferentes solicitadas. | Especifica si conservas parámetros y cómo tratas HTTP, HTTPS y www. |
| GET de documentos con 200 | Solicitudes GET a posibles documentos que recibieron 200. | Ayuda a separar el acceso a contenido de los recursos y controles; el cuerpo necesita su propia comprobación. |
| Verificación de IP | Solicitudes cuya IP coincide con los rangos oficiales consultados. | Requiere que el campo contenga la IP fiable del cliente y que se documente la fecha de los rangos. |
| Respuestas HTTP | Estados devueltos por la capa observada. | Permiten investigar errores, bloqueos, redirecciones y respuestas correctas. |
GA4 no es un inventario de rastreadores. Google excluye automáticamente el tráfico de bots conocidos y no ofrece un recuento del volumen excluido. Las visitas humanas que llegan desde un asistente son otra medición. La documentación de Analytics explica esa exclusión.
Cómo descargar los logs de tu hosting
Necesitas los registros de acceso. Los registros de errores sirven para investigar incidencias, pero no incluyen necesariamente cada solicitud ni los campos que hacen falta para clasificar bots.
En cPanel
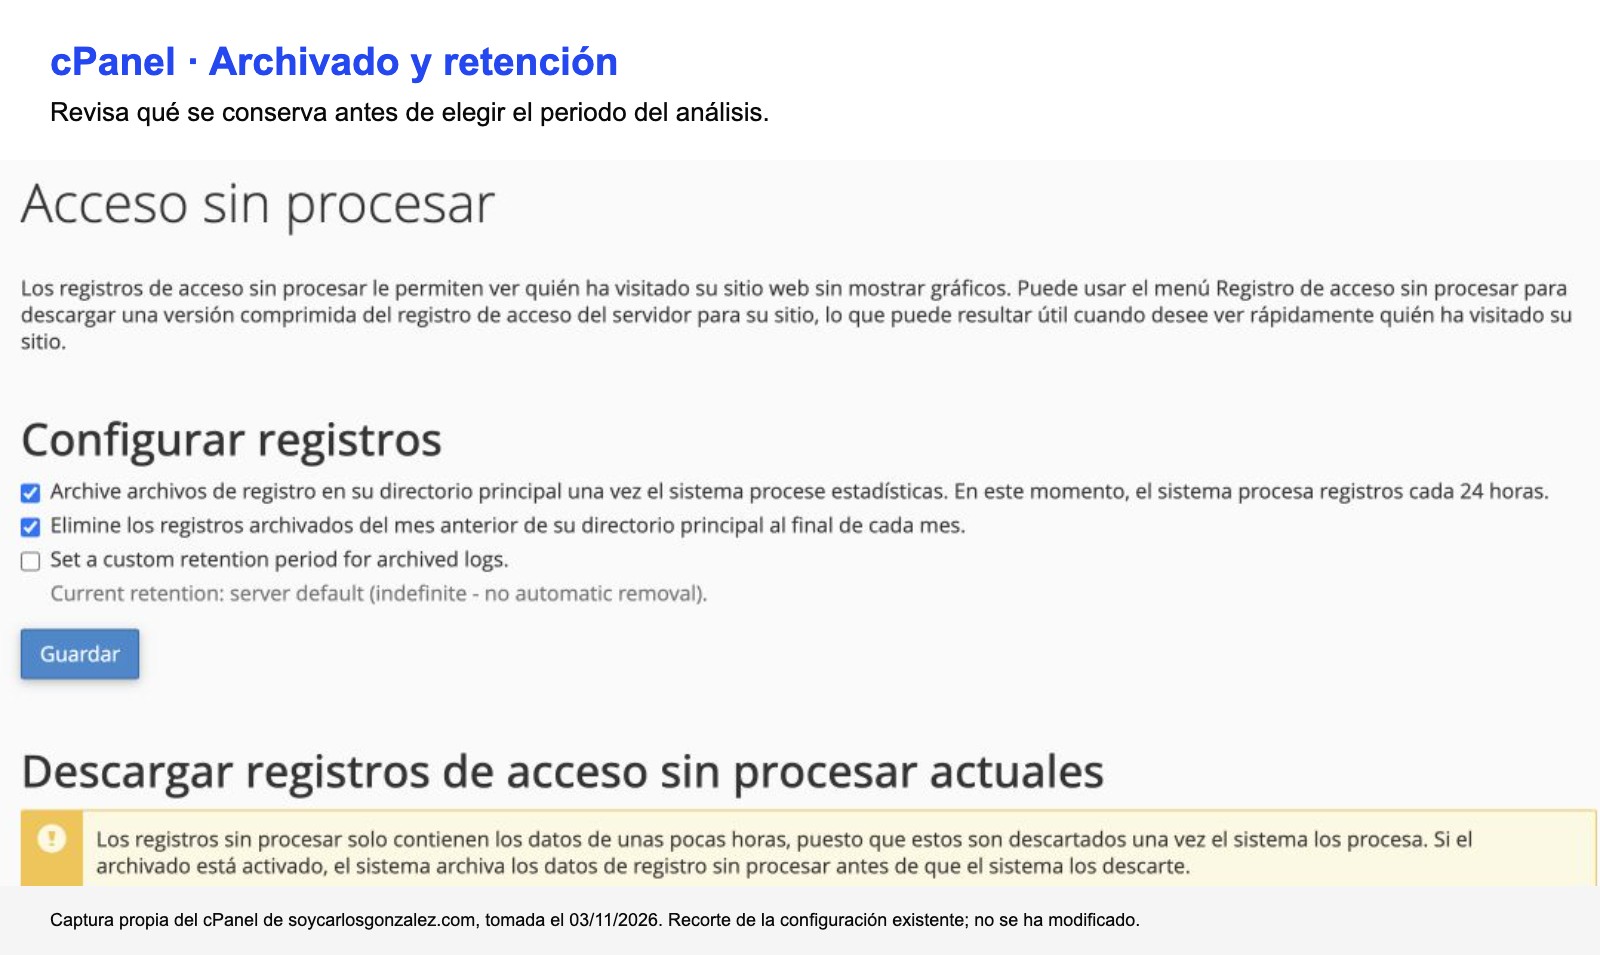
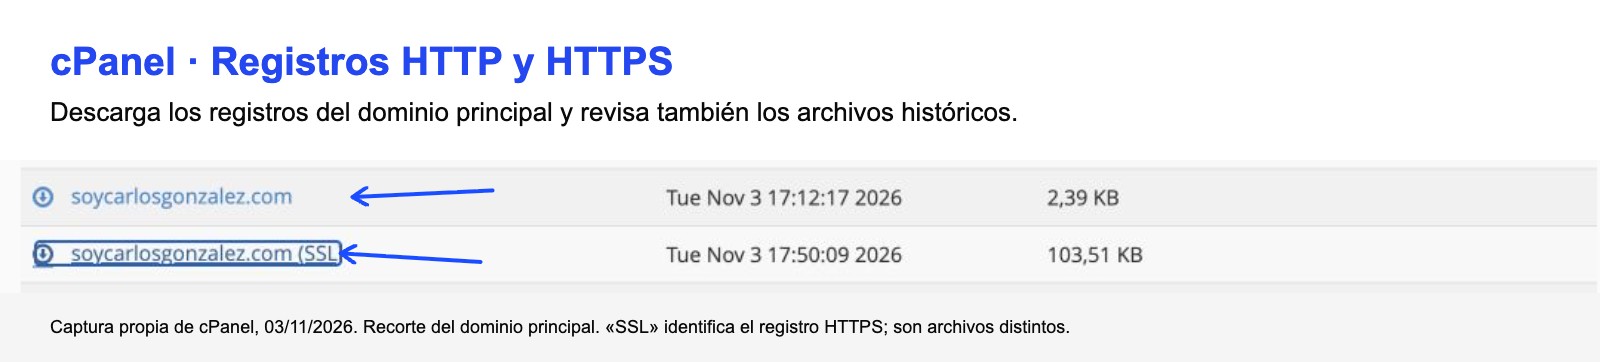
Entra en el cPanel del alojamiento y busca Raw Access, que puede aparecer traducido como Acceso sin procesar, dentro del apartado de métricas. Selecciona el dominio del análisis y descarga sus registros HTTP y HTTPS si ambos están disponibles. En esta interfaz, el segundo aparece como (SSL). cPanel entrega estos registros comprimidos en .gz.
Revisa también los archivos históricos disponibles. Anota qué has descargado, para qué dominio y qué periodo contiene. La fecha del archivo no sustituye a las fechas de las solicitudes que hay dentro. La función y sus opciones de archivo están descritas en la documentación de cPanel.
En otro panel o con acceso al servidor
Busca la sección de registros del dominio y localiza el archivo de accesos. En un servidor administrado puedes pedir al responsable un export del periodo que necesites, con IP del cliente, fecha y zona horaria, método, URL, estado y user agent. Añade bytes y tiempo de respuesta si están disponibles.
Las rutas de Apache o NGINX dependen de la instalación. Evita asumir que un directorio concreto contiene los registros de tu dominio: comprueba el virtual host y el formato antes de empezar. No necesitas cambiar la configuración del servidor para analizar un archivo que ya existe.
Si utilizas Cloudflare u otra CDN
Comprueba primero dónde se responde a la solicitud. Una respuesta servida desde la caché de una CDN puede resolverse sin llegar al servidor de origen. Cloudflare documenta sus distintos estados de caché.
Por eso, un análisis del origen debe identificarse como tal. Para estudiar actividad que se resuelve o bloquea antes, necesitas también los datos de esa capa. No sumes sin más el recuento de la CDN y el del origen: una misma petición puede aparecer en ambos.
Conserva los originales en privado. Antes de compartir capturas o exports, revisa IP personales, parámetros con correos o identificadores, rutas privadas y referencias a otras cuentas.
Cómo leer una línea del log
Vamos con un ejemplo en formato Combined. Es un formato habitual en Apache y se puede utilizar también en configuraciones compatibles de NGINX. El archivo de práctica de este tutorial utiliza esta estructura:
192.0.2.10 - - [30/Oct/2026:08:00:00 +0000] "GET /blog/guia-seo/ HTTP/1.1" 200 8420 "-" "Mozilla/5.0 (compatible; GPTBot/1.0; +https://example.com/bot)"Esta línea es sintética. La IP pertenece a un rango reservado para documentación y el user agent está simplificado. Sirve para aprender a leer los campos; no representa un acceso de OpenAI.
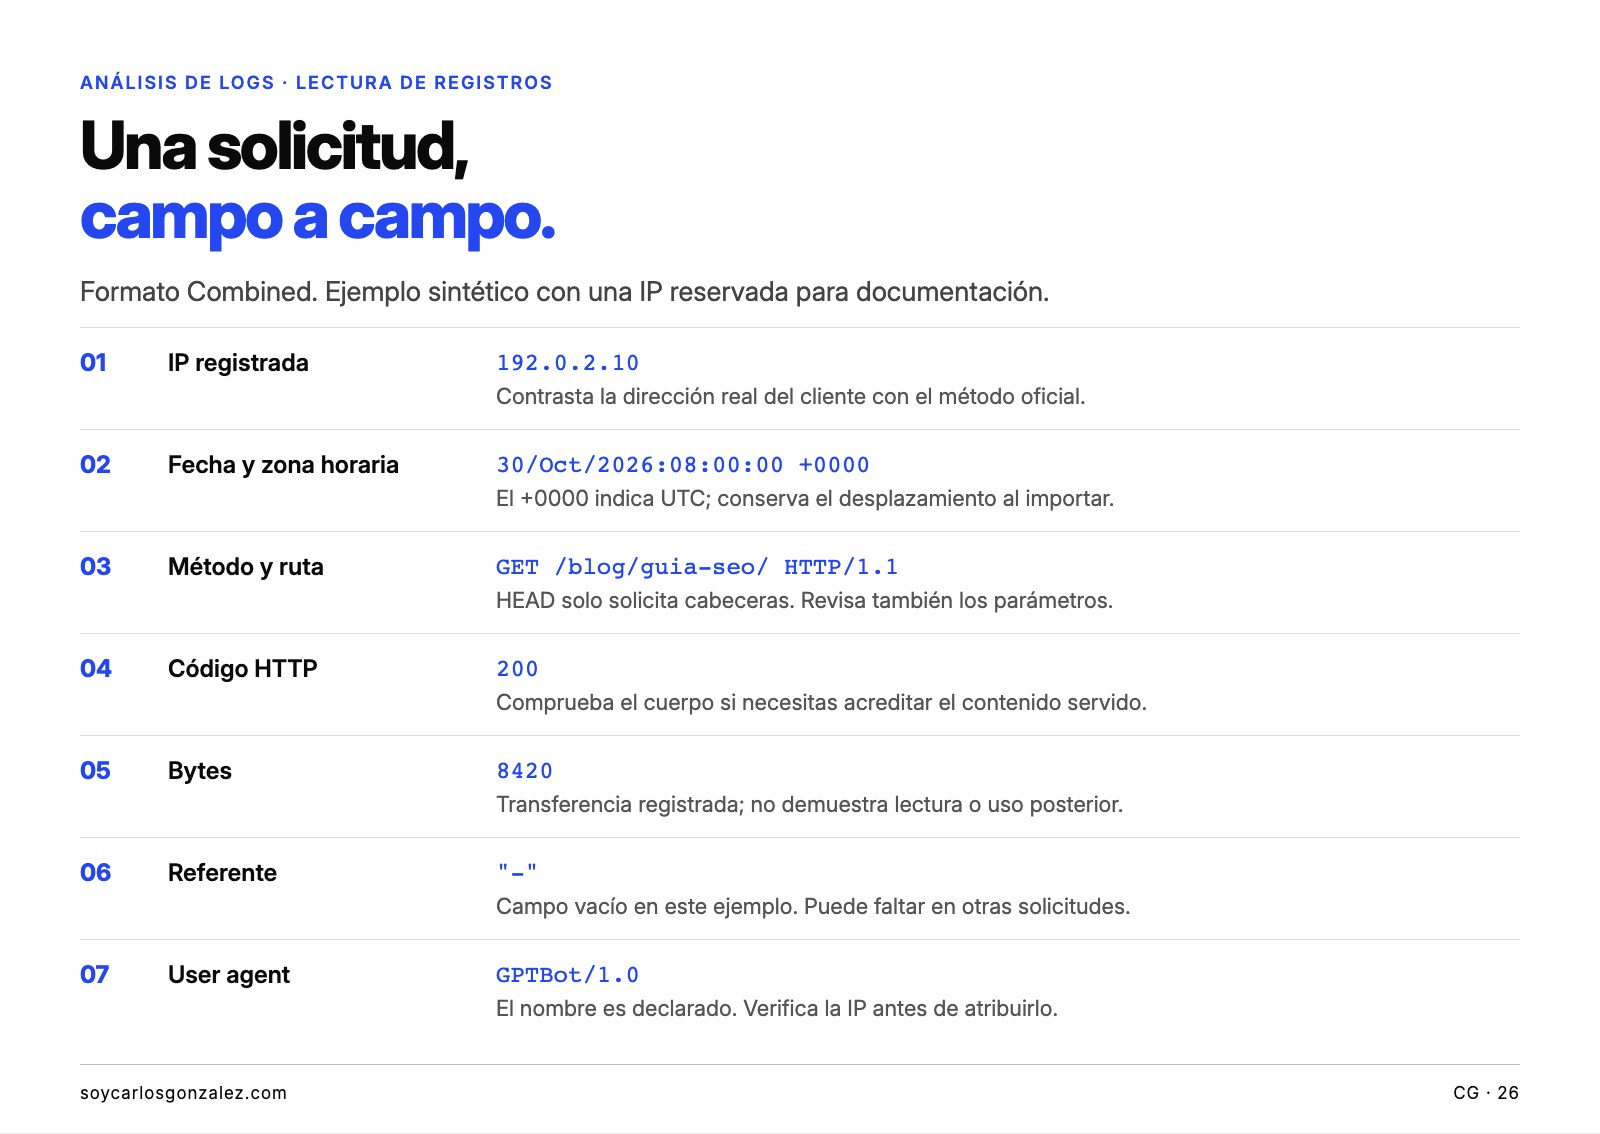
192.0.2.10es la dirección registrada como origen.30/Oct/2026:08:00:00 +0000indica fecha, hora y desplazamiento respecto a UTC.GET /blog/guia-seo/ HTTP/1.1contiene el método y la ruta solicitada.200es el código de respuesta.8420es el número de bytes registrado en este campo."-"ocupa el campo de referente, que aquí está vacío.- La última cadena entre comillas es el user agent, el identificador que declara el cliente.
El formato de cada instalación manda. Si tu archivo tiene otros campos o está en JSON, utiliza el importador correspondiente. Un log Common sin user agent no permite aplicar este procedimiento de identificación por nombre. Puedes contrastar la estructura con la referencia de logs de Apache.
Hay dos detalles que cambian la lectura: una solicitud HEAD pide las cabeceras sin descargar el cuerpo, y una petición a /robots.txt no equivale a leer un artículo. Conviene conservar esos eventos y analizarlos por separado.
Qué user agents utilizan los bots de IA
Para reconocer un bot buscamos su identificador dentro del campo User-Agent. Si buscas el texto en toda la línea, podrías encontrarlo en una URL o en el referente y contar una coincidencia incorrecta.
Esta tabla reúne los identificadores principales de OpenAI, Anthropic y Perplexity documentados al revisar el artículo el 3 de noviembre de 2026. La finalidad es la que declara cada proveedor; no acredita qué uso posterior tuvo una página concreta.
| Proveedor | Identificador | Finalidad declarada |
|---|---|---|
| OpenAI | GPTBot | Recogida de contenido que puede utilizarse para entrenamiento. |
| OpenAI | OAI-SearchBot | Búsqueda para las funciones de búsqueda de ChatGPT. |
| OpenAI | ChatGPT-User | Accesos asociados a acciones iniciadas por usuarios. |
| Anthropic | ClaudeBot | Recogida de contenido que puede contribuir al entrenamiento. |
| Anthropic | Claude-SearchBot | Recuperación e indexación para mejorar las búsquedas. |
| Anthropic | Claude-User | Accesos a petición de usuarios de Claude. |
| Perplexity | PerplexityBot | Rastreo para encontrar y enlazar páginas en sus resultados. |
| Perplexity | Perplexity-User | Recuperación de páginas vinculada a peticiones de usuarios. |
Las fuentes de esta clasificación son las páginas oficiales de OpenAI, Anthropic y Perplexity. OpenAI documenta además OAI-AdsBot para páginas presentadas como anuncios: si aparece, clasifícalo por separado.
Filtra por el identificador estable y admite que cambie la versión. La cadena completa puede incorporar una versión de navegador y otros componentes. Una expresión que solo reconozca una versión exacta puede dejar fuera solicitudes posteriores.
Common Crawl y los bots de Amazon
Si aparece CCBot, estás observando una declaración del rastreador de Common Crawl, que construye un archivo público de la web. Su presencia no identifica qué empresa utilizará esos datos después. Common Crawl publica su identificación y los métodos de verificación.
Amazon documenta Amazonbot para mejorar productos y posibles usos de entrenamiento, Amzn-SearchBot para búsqueda y Amzn-User para accesos por acciones de usuarios. Puedes consultar sus identificadores y rangos en la documentación de Amazon.
Busca el identificador del cliente dentro del campo user agent, separándolo de los enlaces que contenga. En los logs de mi web aparece un Perplexity-User cuyo enlace de documentación termina en /perplexitybot. Buscar ese nombre en cualquier parte de la cadena lo asignaría al bot equivocado. Excluye esos enlaces de la búsqueda para clasificar el identificador correcto.
El catálogo es un punto de partida ampliable. Hay otros rastreadores, herramientas y agentes que pueden recuperar información de una web. La ausencia de uno de estos nombres no permite medir toda la actividad relacionada con IA.
Google-Extended y el rastreo de Google
Google-Extended no tiene un user agent HTTP independiente. Es un token de control para determinados usos del contenido. Google explica que el rastreo se realiza con identificadores que ya utiliza su infraestructura. Buscar Google-Extended como si fuera un bot separado conduce a una medición incorrecta.
Una solicitud de Googlebot tampoco permite atribuir esa recuperación a una respuesta concreta de AI Overviews, AI Mode o Gemini. La distinción está documentada en la lista de rastreadores de Google.
Cómo comprobar si la solicitud pertenece al bot
El user agent lo declara quien hace la petición. Cualquier cliente puede enviar un nombre conocido. Para distinguir la declaración de una identificación contrastada, compara la IP del cliente con los rangos que publica el proveedor, cuando estén disponibles.
OpenAI y Perplexity publican archivos JSON para sus distintos identificadores. Anthropic enlaza su listado de rangos desde la documentación de sus bots. La coincidencia con una red de Anthropic identifica infraestructura del proveedor; el nombre del bot sigue saliendo de la cabecera.
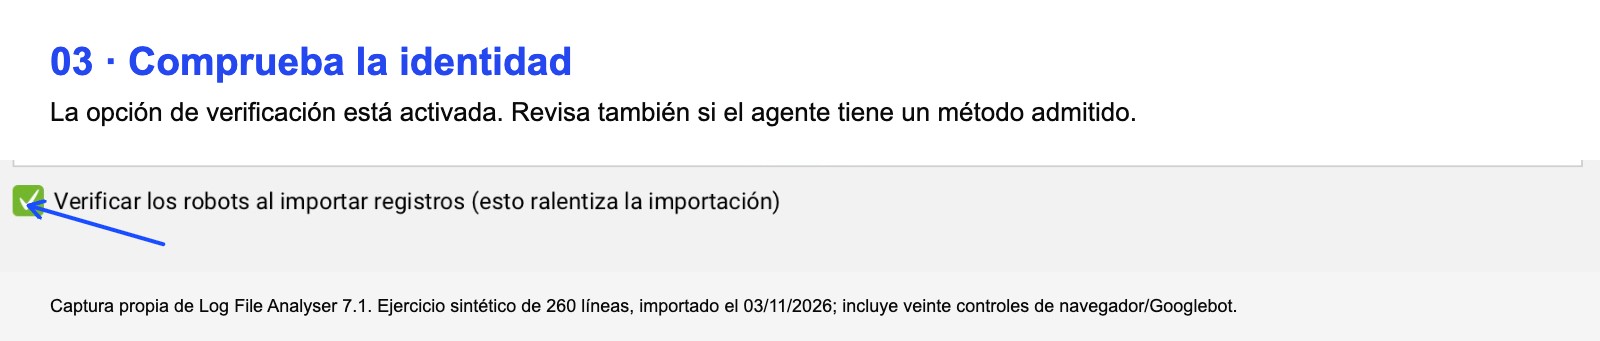
En Log File Analyser puedes activar la verificación durante la importación o ejecutarla después. Revisa qué método está configurado para cada agente y cómo se interpreta el resultado. La posibilidad de agrupar bots de IA y configurar su verificación forma parte de la versión 7 de la herramienta.
Antes de dar por válida la comprobación, revisa estos puntos:
- IP real del cliente. Si el log contiene la IP del proxy, estarás contrastando otra máquina. La restauración de la IP debe estar configurada con proxies de confianza.
- Fecha de los rangos. Un listado descargado hoy puede haber cambiado respecto a un acceso antiguo. Conserva la fecha de consulta.
- Resultado separado. Guarda las solicitudes que coinciden con rangos, las que quedan fuera y las que no has podido verificar. Un fallo de descarga o de resolución también puede impedir la comprobación.
Enviar tú mismo una petición con User-Agent: GPTBot sirve para probar cómo responde tu web a esa cabecera. Esa prueba no convierte tu conexión en un acceso de OpenAI. Si haces comprobaciones de ese tipo, anótalas para excluirlas del análisis de actividad observada.
Cómo analizar los logs con Screaming Frog
Vamos a utilizar Screaming Frog Log File Analyser. SEO Spider es el rastreador de la misma empresa y lo usaremos después para cruzar datos; son aplicaciones distintas y tienen licencias separadas.
La versión gratuita de Log File Analyser permite analizar hasta 1.000 eventos en un proyecto. Para las capturas he utilizado un archivo sintético de 260 líneas, dentro de ese límite. Para analizar un periodo mayor, comprueba el volumen y las condiciones de la versión que utilices.
Las capturas se han tomado en Log File Analyser 7.1 importando un archivo sintético creado para explicar los pasos. Las cifras representan el ejercicio de práctica.
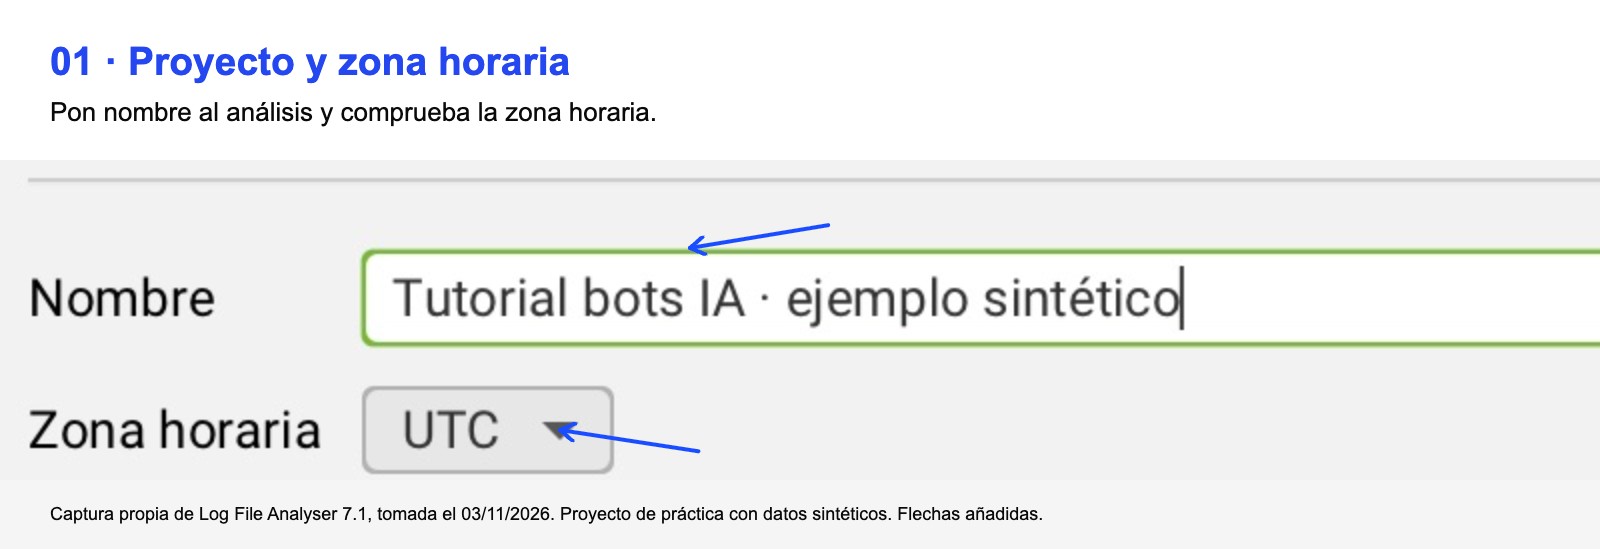
1. Prepara el proyecto y la zona horaria
Con los logs de tu hosting ya descargados, pulsa Nuevo. Pon nombre al proyecto y revisa la zona horaria antes de confirmar su creación. Al importar el archivo indicarás el dominio y el protocolo correspondientes a ese registro.
Para trabajar con tus datos, selecciona los archivos del mismo dominio y del periodo elegido. Revisa si los registros actuales y los históricos se solapan. Conservar los nombres y las fechas de los originales ayuda a detectar una importación duplicada.
2. Selecciona los user agents que vas a analizar
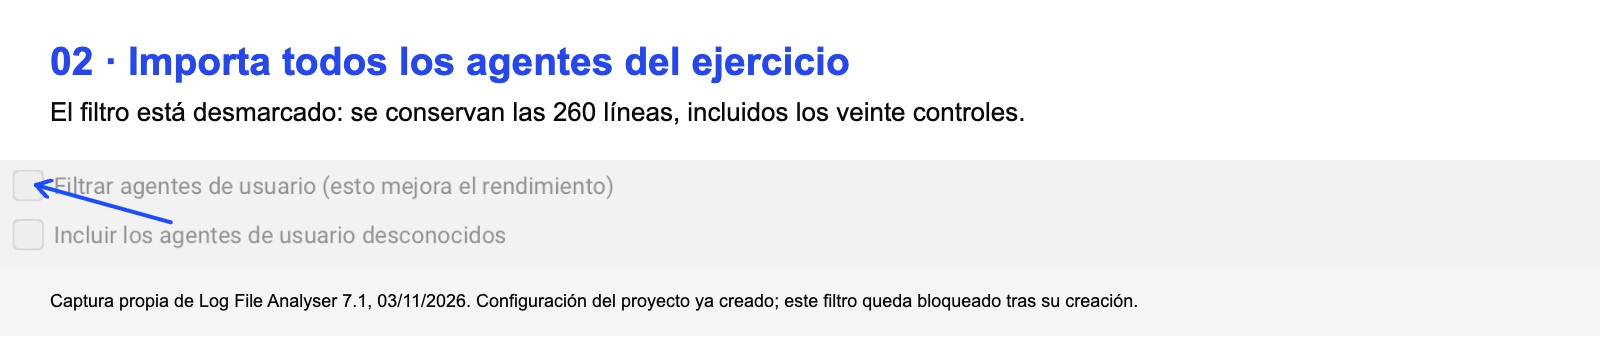
Antes de pulsar Aceptar en la creación del proyecto, entra en Agentes de usuario. El filtro predeterminado se centra en buscadores y puede dejar fuera todos los bots de IA. En las capturas he desmarcado «Filtrar agentes de usuario» para importar las 260 líneas, incluidos los veinte eventos de control. Después puedes filtrar los bots en la vista de análisis.
Configura este filtro antes de crear el proyecto. En la versión 7.1 queda bloqueado después, incluso si todavía no has importado eventos. Con la versión gratuita, que solo permite un proyecto, revisarlo a tiempo evita tener que rehacer el proyecto de práctica.
Con un archivo grande puedes mantener el filtro de importación y añadir los bots de IA al panel de seleccionados antes de crear el proyecto. Comprueba si falta alguno del catálogo y configura un agente adicional cuando sea necesario.
Seleccionar solo un grupo de bots limita lo que entra en el proyecto. Para explorar otros clientes o identificadores desconocidos, utiliza las opciones correspondientes y documenta el filtro utilizado. Evita interpretar un agente excluido de la importación como ausencia de actividad.
3. Activa la verificación disponible
Activa la comprobación de bots que permita tu versión y revisa los rangos o métodos asociados. Después separa los resultados confirmados por esa comprobación de las declaraciones de user agent que no se han podido contrastar.
El ejemplo sintético utiliza IP reservadas, con cero coincidencias con los rangos oficiales. En Log File Analyser 7.1, las cadenas simplificadas del ejercicio no se reconocen como sus agentes predefinidos y pueden mostrar «Verificación no admitida». Ese estado indica que no se ha aplicado un método de comprobación; no equivale a una IP verificada ni a una suplantación demostrada.
4. Importa el log y comprueba el intervalo
Confirma ahora la creación del proyecto. Utiliza Importar o arrastra el log a la ventana. Cuando se solicite, indica el dominio y el protocolo que correspondan al archivo. En las capturas utilizo https://ejemplo.com para el ejemplo sintético.
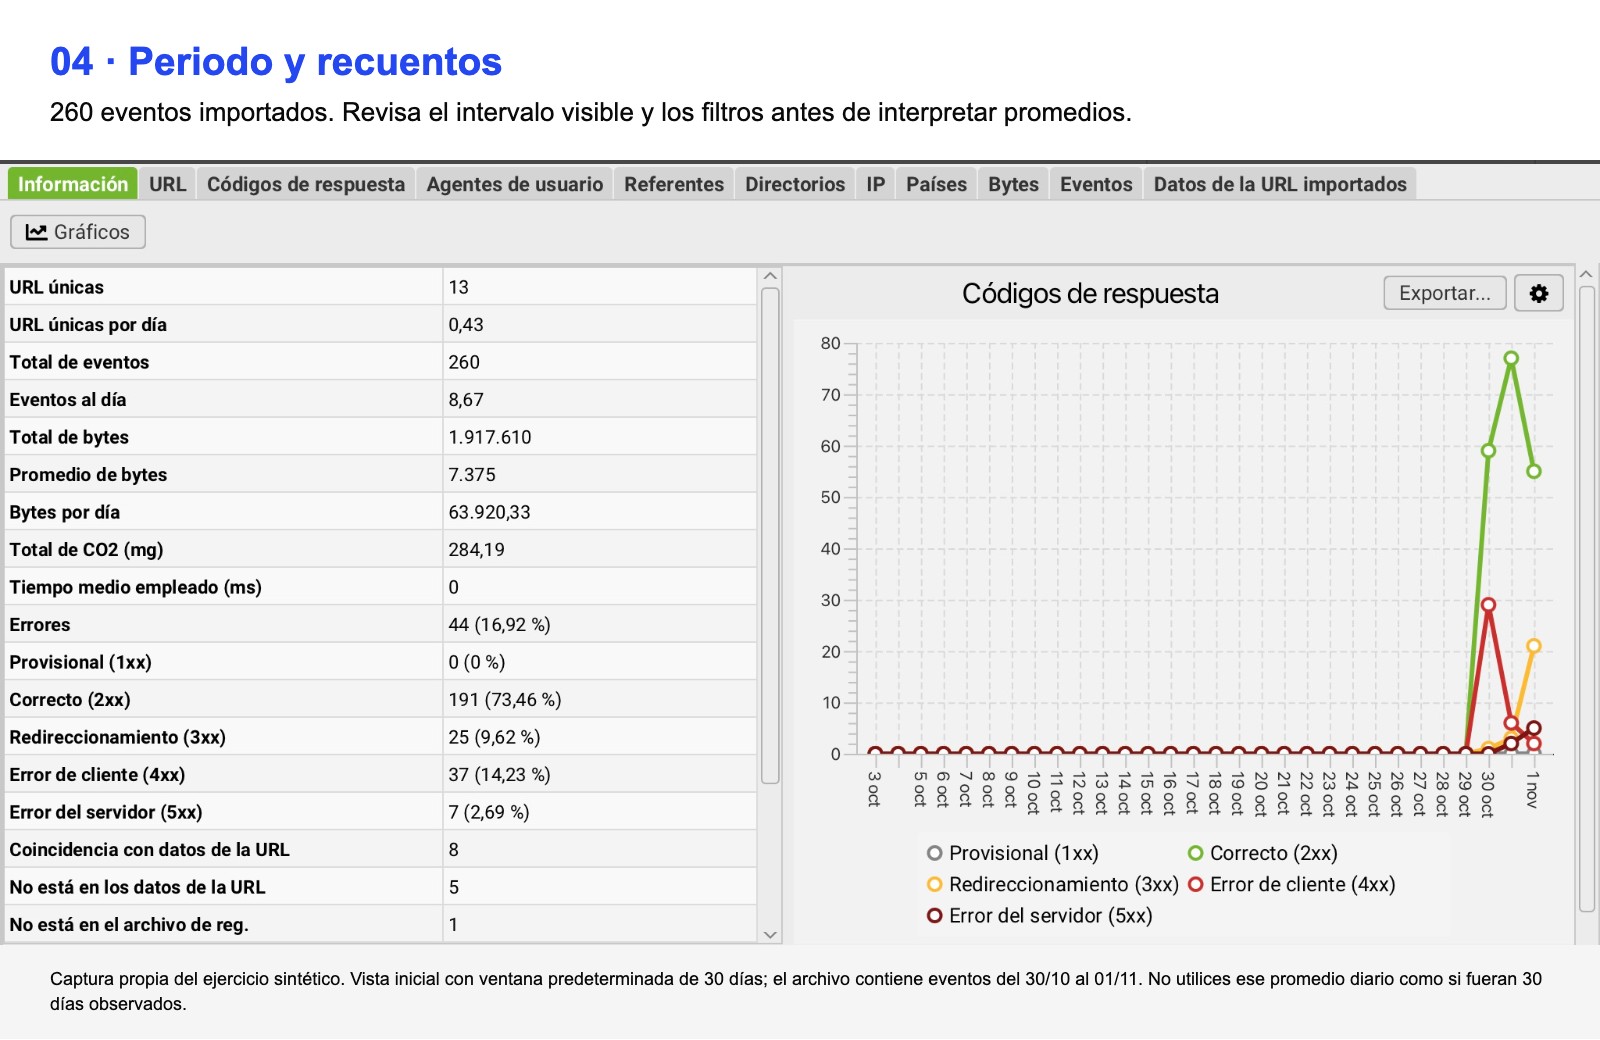
Selecciona el periodo del archivo y revisa la zona horaria de la aplicación. En el ejercicio trabajamos con eventos del 30 de octubre al 1 de noviembre de 2026, en UTC. Son fechas de un archivo simulado; no acreditan observación continua de una web durante esos días.
La captura muestra la vista inicial con los 260 eventos y la ventana predeterminada de 30 días. Cámbiala al periodo del archivo antes de utilizar promedios diarios. Los veinte controles explican por qué el total importado es 260 y la suma de los ocho bots es 240.
Comprueba el número de líneas procesadas, los filtros activos y los eventos importados. Si una aplicación omite líneas o limita el volumen, investiga la causa antes de interpretar sus gráficas.
5. Revisa agentes, URLs y respuestas
En el ejercicio, lee la columna Cadena de agente de usuario y busca identificadores como GPTBot u OAI-SearchBot dentro de ese campo. La columna Agente de usuario puede estar vacía: los user agents se han simplificado y no coinciden con las definiciones preconfiguradas de esta versión. Mantener todos los agentes durante la importación permite conservarlos y revisarlos.
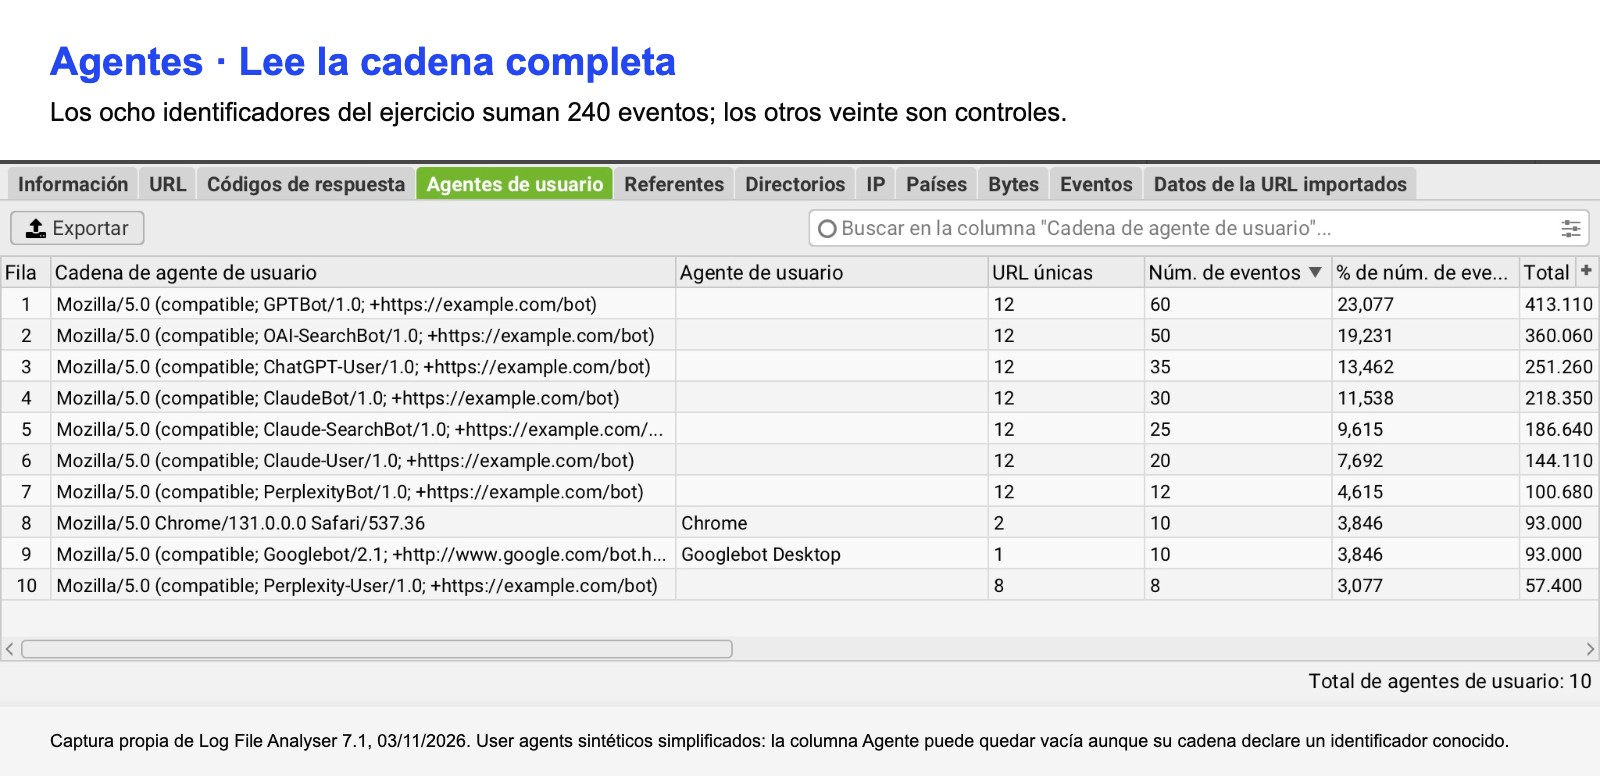
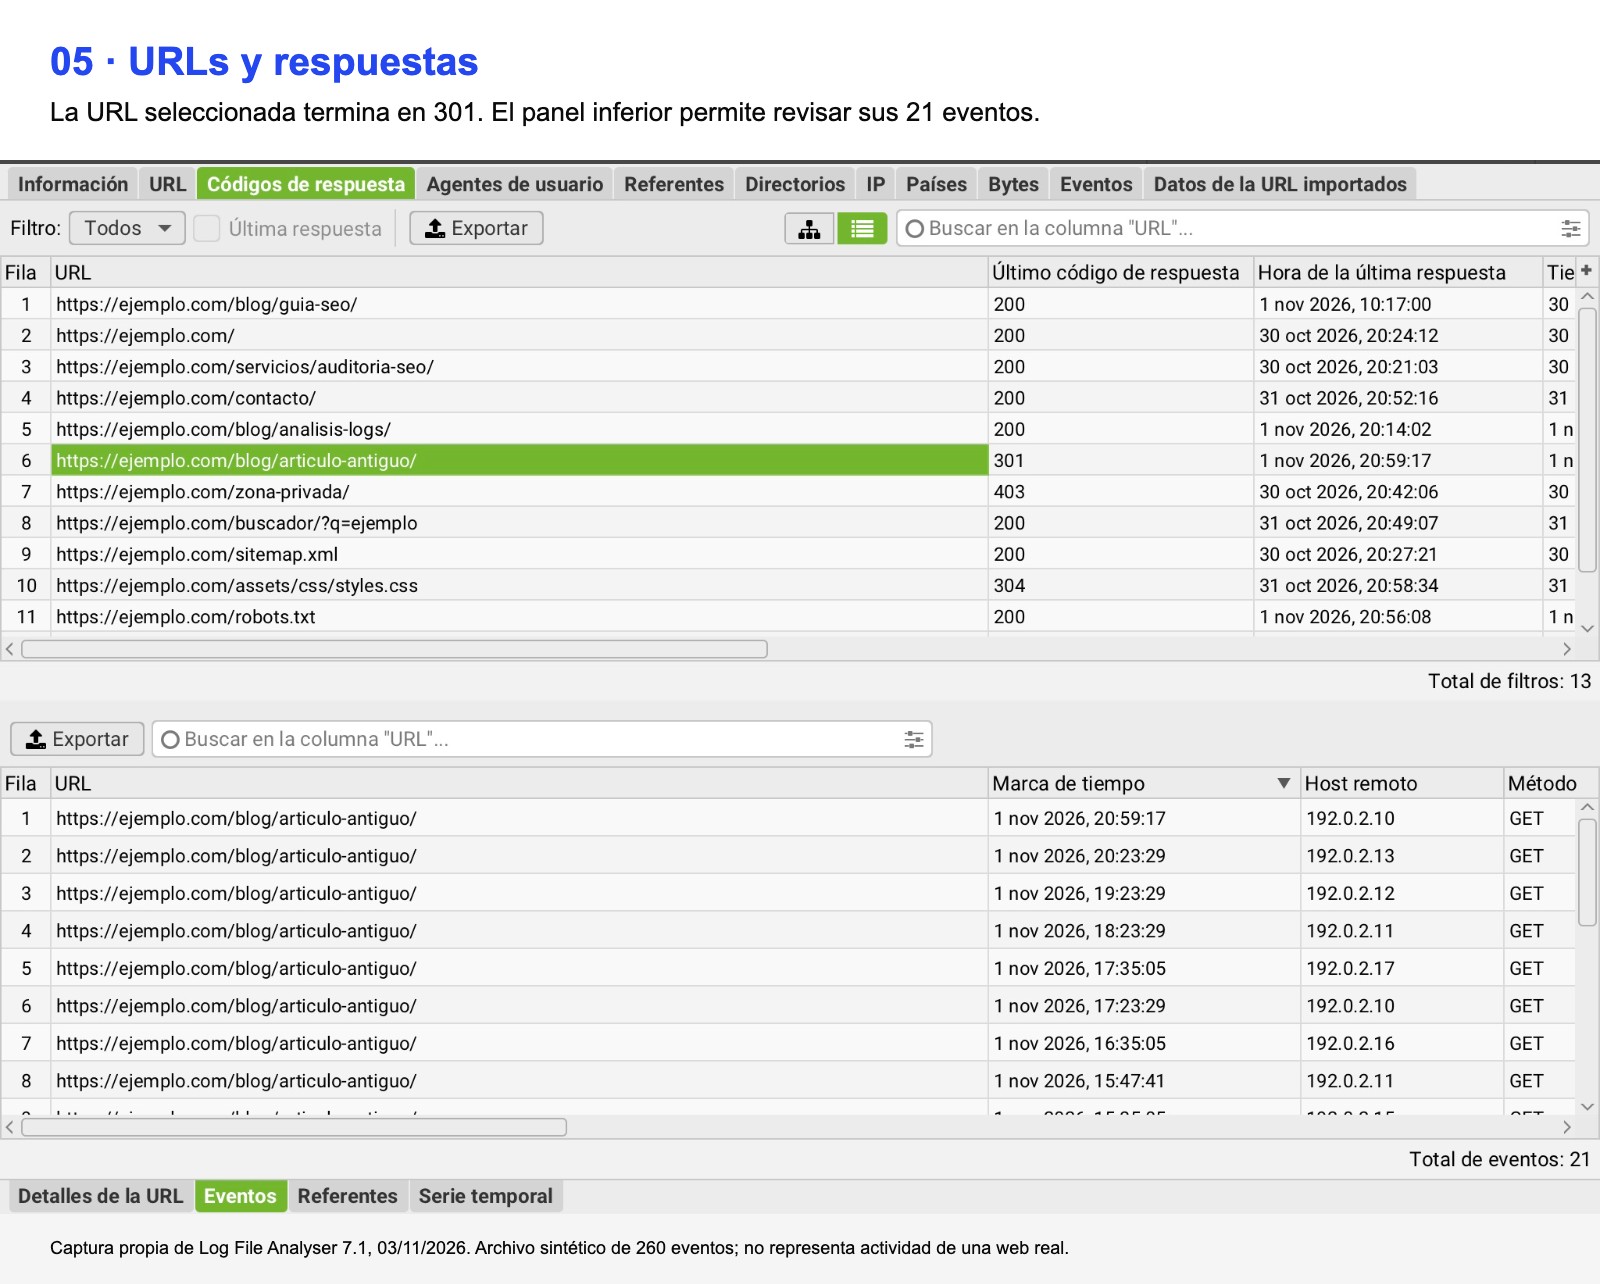
Empieza por la vista de agentes de usuario para comparar la actividad de cada identificador. Pasa después a URLs y filtra por un bot concreto. La vista de códigos de respuesta permite localizar los estados devueltos.
Comprueba el detalle de eventos cuando una URL tenga varios códigos: una respuesta actual correcta puede convivir en el periodo con errores anteriores. Exporta las tablas que necesites junto al periodo y los filtros. La guía de vistas de Log File Analyser explica qué agrega cada tabla.
Qué mirar en los resultados
Cuántas solicitudes hace cada bot
Presenta el total con fecha, dominio, capa de registro y estado de verificación. Puedes agrupar por proveedor, pero conserva el detalle del bot: entrenamiento, búsqueda y acceso por petición de usuario tienen funciones distintas.
Para comparar semanas, utiliza periodos equivalentes y comprueba la cobertura. Un archivo que conserva dos días no permite afirmar que la actividad semanal ha caído frente a otro con siete días completos.
Qué URLs solicita y con qué frecuencia
Ordena las páginas por solicitudes y revisa qué secciones aparecen. Separa documentos de imágenes, CSS y otros recursos. Si el log no incluye el tipo MIME real, la clasificación por extensión es una aproximación: una ruta sin extensión puede devolver contenido diferente.
Conserva una copia original y define la agrupación. Por ejemplo, /guia/?utm_source=uno y /guia/?utm_source=dos pueden contarse juntas en una vista por ruta. Un parámetro que cambia el contenido puede requerir mantenerlas separadas. Tampoco sumes URLs únicas por bot para obtener el total del sitio: distintos bots pueden pedir las mismas direcciones.
Qué respuesta recibe
| Estado | Qué comprobaría |
|---|---|
200 | El servidor respondió correctamente a nivel HTTP. Revisa el cuerpo si necesitas comprobar el contenido entregado. |
301 / 302 | Destino y motivo de la redirección. Comprueba si después se solicita la URL de destino. |
304 | Revalidación de un recurso que no ha cambiado. No la clasifiques como error. |
401 / 403 | Autenticación, autorización o reglas de protección. Comprueba si el bloqueo es intencional. |
404 / 410 | Si la URL se retiró o si un enlace o sitemap sigue apuntando a una página que debería funcionar. |
429 | Frecuencia de acceso y límites configurados. Revisa si están frenando el rastreo que quieres permitir. |
5xx | Incidencias del servidor o de la capa intermedia y su duración. Contrasta con los registros de errores. |
Una página que devuelve 200 puede contener un desafío, una pantalla de acceso o muy poco contenido. Para revisar esa parte tienes que comprobar lo que devuelve la URL. En el artículo sobre bloqueos que afectan a los bots de IA desarrollo esos problemas.
Qué parte del sitio aparece en los registros
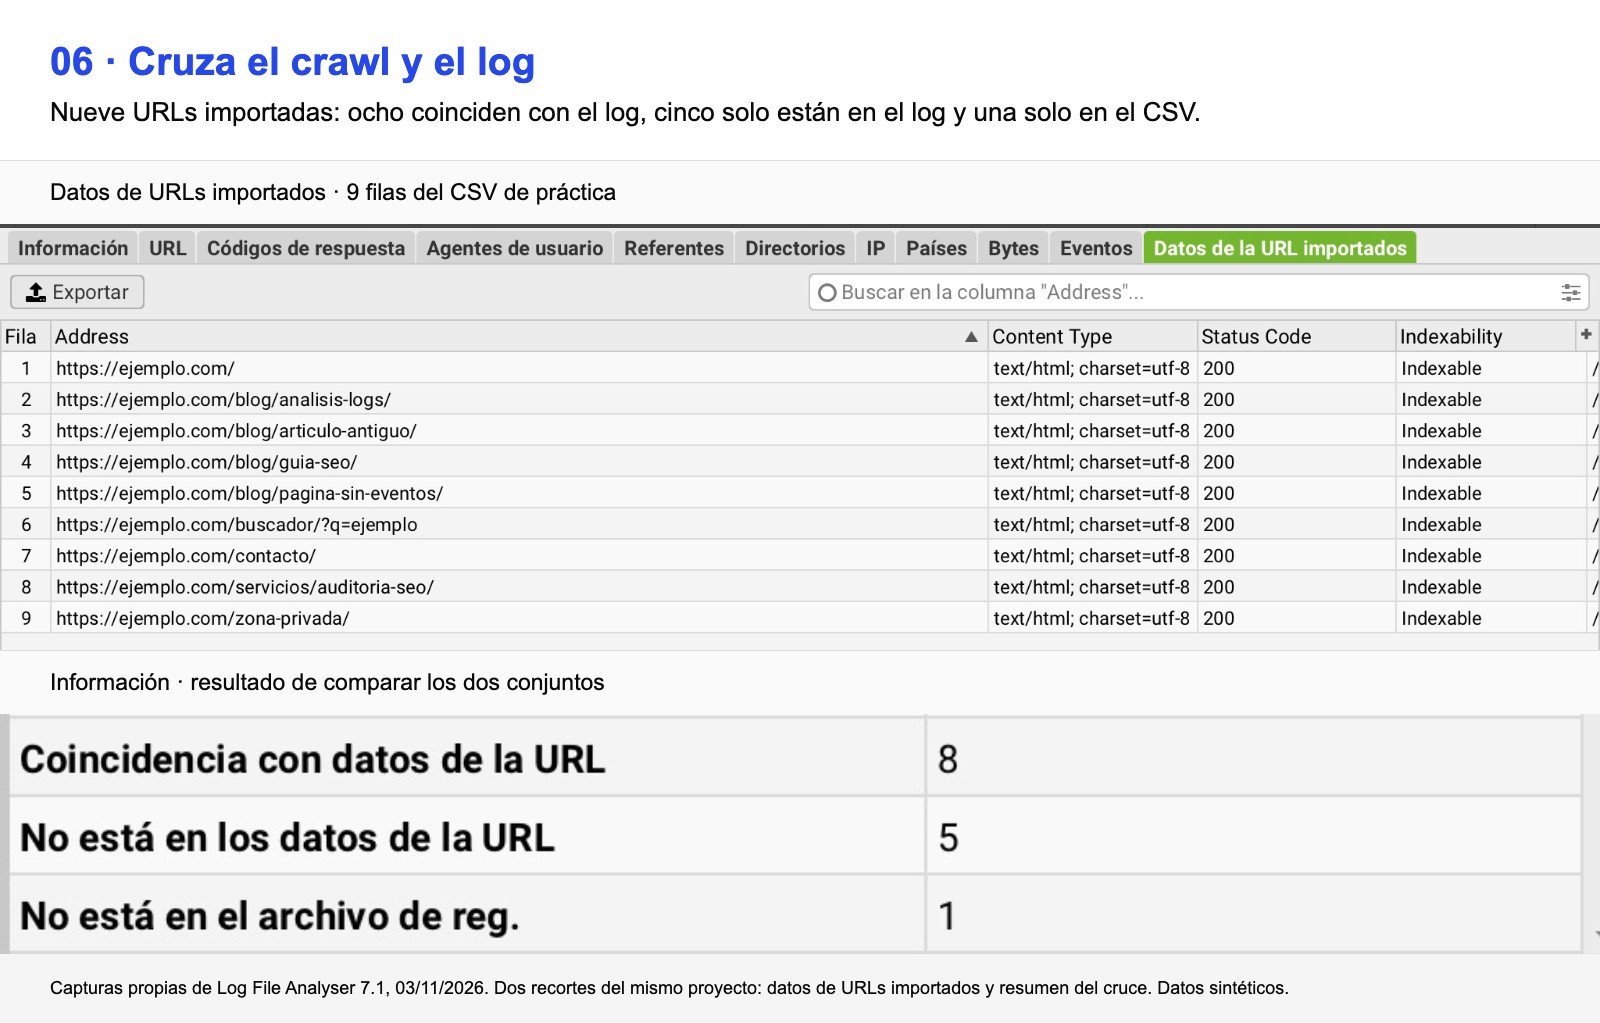
Exporta las URLs de un crawl de SEO Spider e impórtalas como datos de URLs en Log File Analyser. Revisa las páginas presentes en el crawl que no tienen eventos en el periodo y las URLs del log que no aparecen en ese crawl.
Esas diferencias son listas para investigar. Una URL sin eventos puede ser nueva, estar excluida del fichero analizado, resolverse desde caché o no haber recibido solicitudes en ese intervalo. Un crawl incompleto también cambia el cruce. Revisa protocolo, host, barras finales y parámetros antes de atribuir diferencias al bot.
En las capturas he importado un CSV de ejemplo desde Proyecto → Importar datos de URL. Contiene nueve URLs: ocho tienen correspondencia con el log y una no registra eventos. A su vez, cinco URLs del log no están en ese CSV. Este cruce utiliza los 260 eventos, incluidos los controles; la URL con parámetros de uno de ellos explica que la aplicación muestre trece URLs frente a las doce rutas de los ocho bots.
Ejemplo de análisis con un archivo de práctica
Los datos de este apartado son sintéticos. He preparado un archivo de 260 líneas con 240 solicitudes que declaran identificadores de bots de IA y 20 solicitudes de control con Googlebot o un navegador. Todas las direcciones IP pertenecen a rangos reservados para documentación.
El archivo sirve para comprobar los filtros y aprender a interpretar las tablas. Incluye 12 rutas distintas entre las solicitudes de IA, peticiones HEAD, robots.txt, sitemap, recursos estáticos y distintos códigos de respuesta. Estos son sus recuentos:
| Identificador declarado | Solicitudes | URLs distintas por bot | Coincidencias de IP |
|---|---|---|---|
GPTBot | 60 | 12 | 0 |
OAI-SearchBot | 50 | 12 | 0 |
ChatGPT-User | 35 | 12 | 0 |
ClaudeBot | 30 | 12 | 0 |
Claude-SearchBot | 25 | 12 | 0 |
Claude-User | 20 | 12 | 0 |
PerplexityBot | 12 | 12 | 0 |
Perplexity-User | 8 | 8 | 0 |
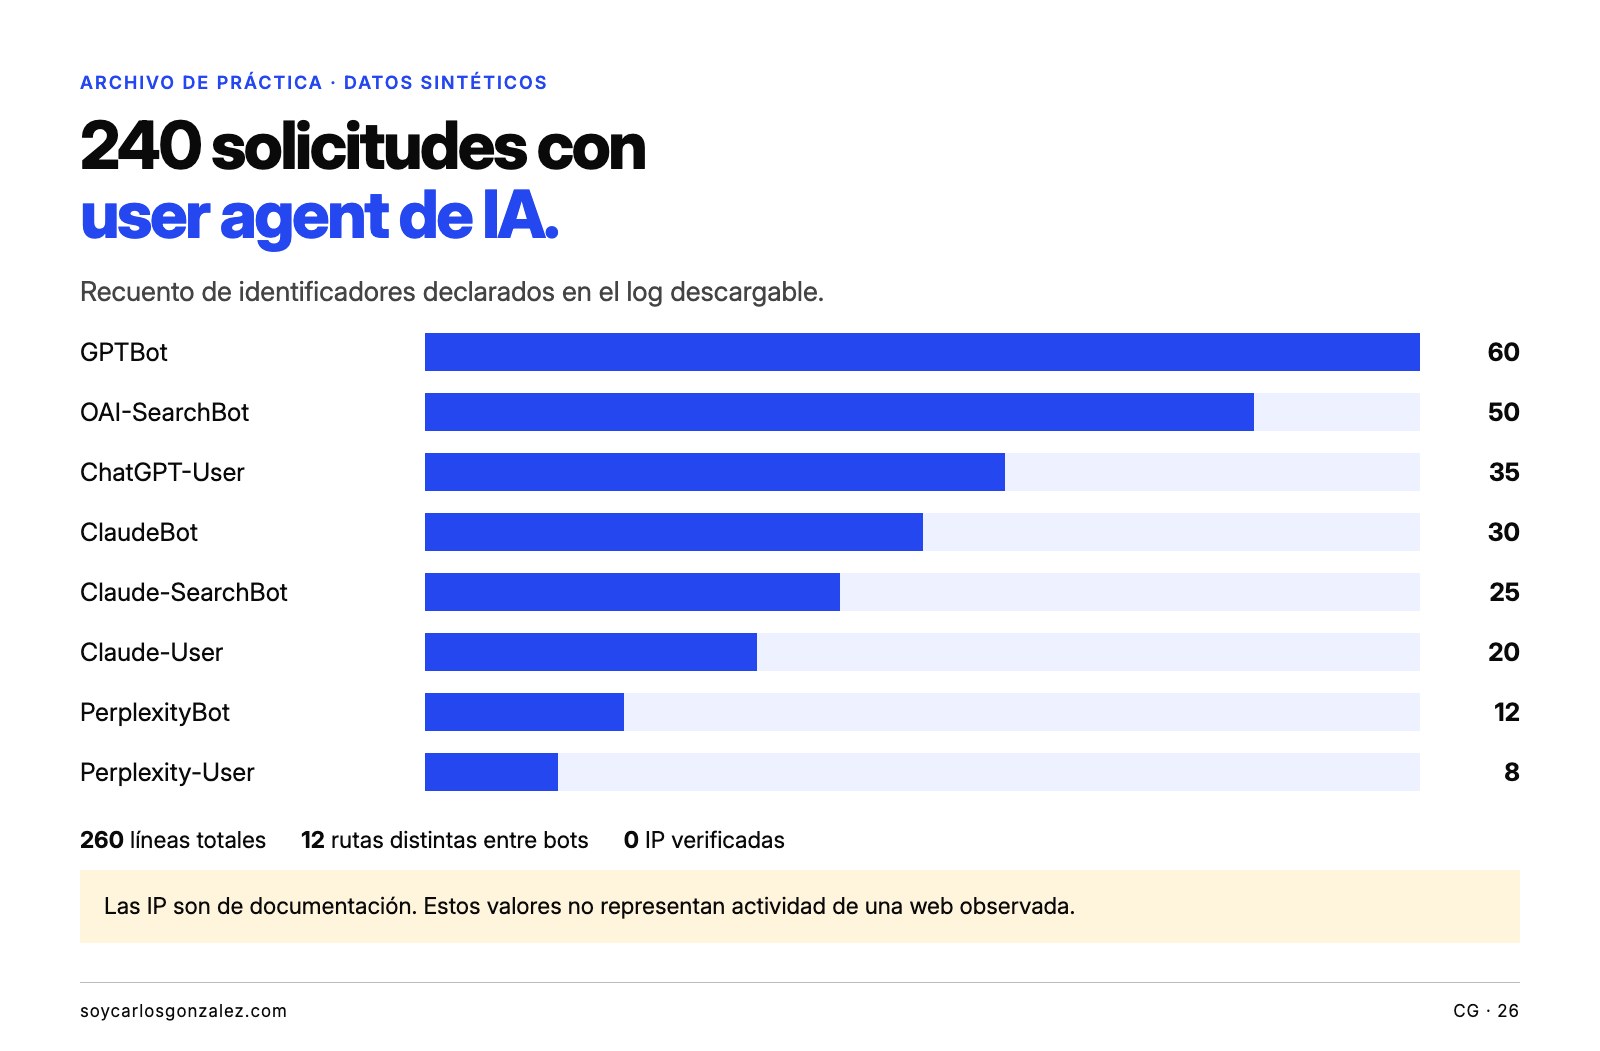
Hay tres recuentos que puedes comprobar en este ejemplo. La suma de solicitudes de los ocho identificadores da 240. El total de URLs distintas entre ellos es 12, aunque varias aparecen bajo distintos bots. Y la verificación de sus IP debe dar cero coincidencias con los rangos oficiales descargados.
En una de las solicitudes de navegador aparece la palabra GPTBot en un parámetro de la URL. No debe clasificarse como acceso de ese bot: su cabecera User-Agent corresponde al navegador. Es una forma de comprobar que el filtro utiliza el campo correcto.
Caso real: qué encontré en los logs de mi web
He aplicado este análisis a soycarlosgonzalez.com. Descargué los registros del hosting Raiola el 3 de noviembre de 2026 y filtré las solicitudes con fecha entre el 1 de octubre a las 00:00 UTC y el 1 de noviembre a las 00:00 UTC, este último instante excluido.
El conjunto contiene 45.490 líneas interpretadas, con registros en los 31 días del mes. Dentro del catálogo de este artículo aparecen 3.009 solicitudes con identificadores de once bots y 602 rutas distintas. Las rutas se agrupan sin parámetros y se suman los eventos HTTP y HTTPS; no se están contando 602 URLs canónicas ni 3.009 lectores.
| User agent declarado | Solicitudes | IP en rangos | IP fuera de rangos |
|---|---|---|---|
ClaudeBot | 1.125 | 1.118 | 7 |
OAI-SearchBot | 563 | 548 | 15 |
PerplexityBot | 484 | 468 | 16 |
ChatGPT-User | 258 | 244 | 14 |
GPTBot | 213 | 194 | 19 |
CCBot | 156 | 144 | 12 |
Claude-User | 149 | 98 | 51 |
Amazonbot | 27 | 14 | 13 |
Claude-SearchBot | 13 | 0 | 13 |
Perplexity-User | 13 | 0 | 13 |
OAI-AdsBot | 8 | 0 | 8 |
| Total | 3.009 | 2.828 | 181 |
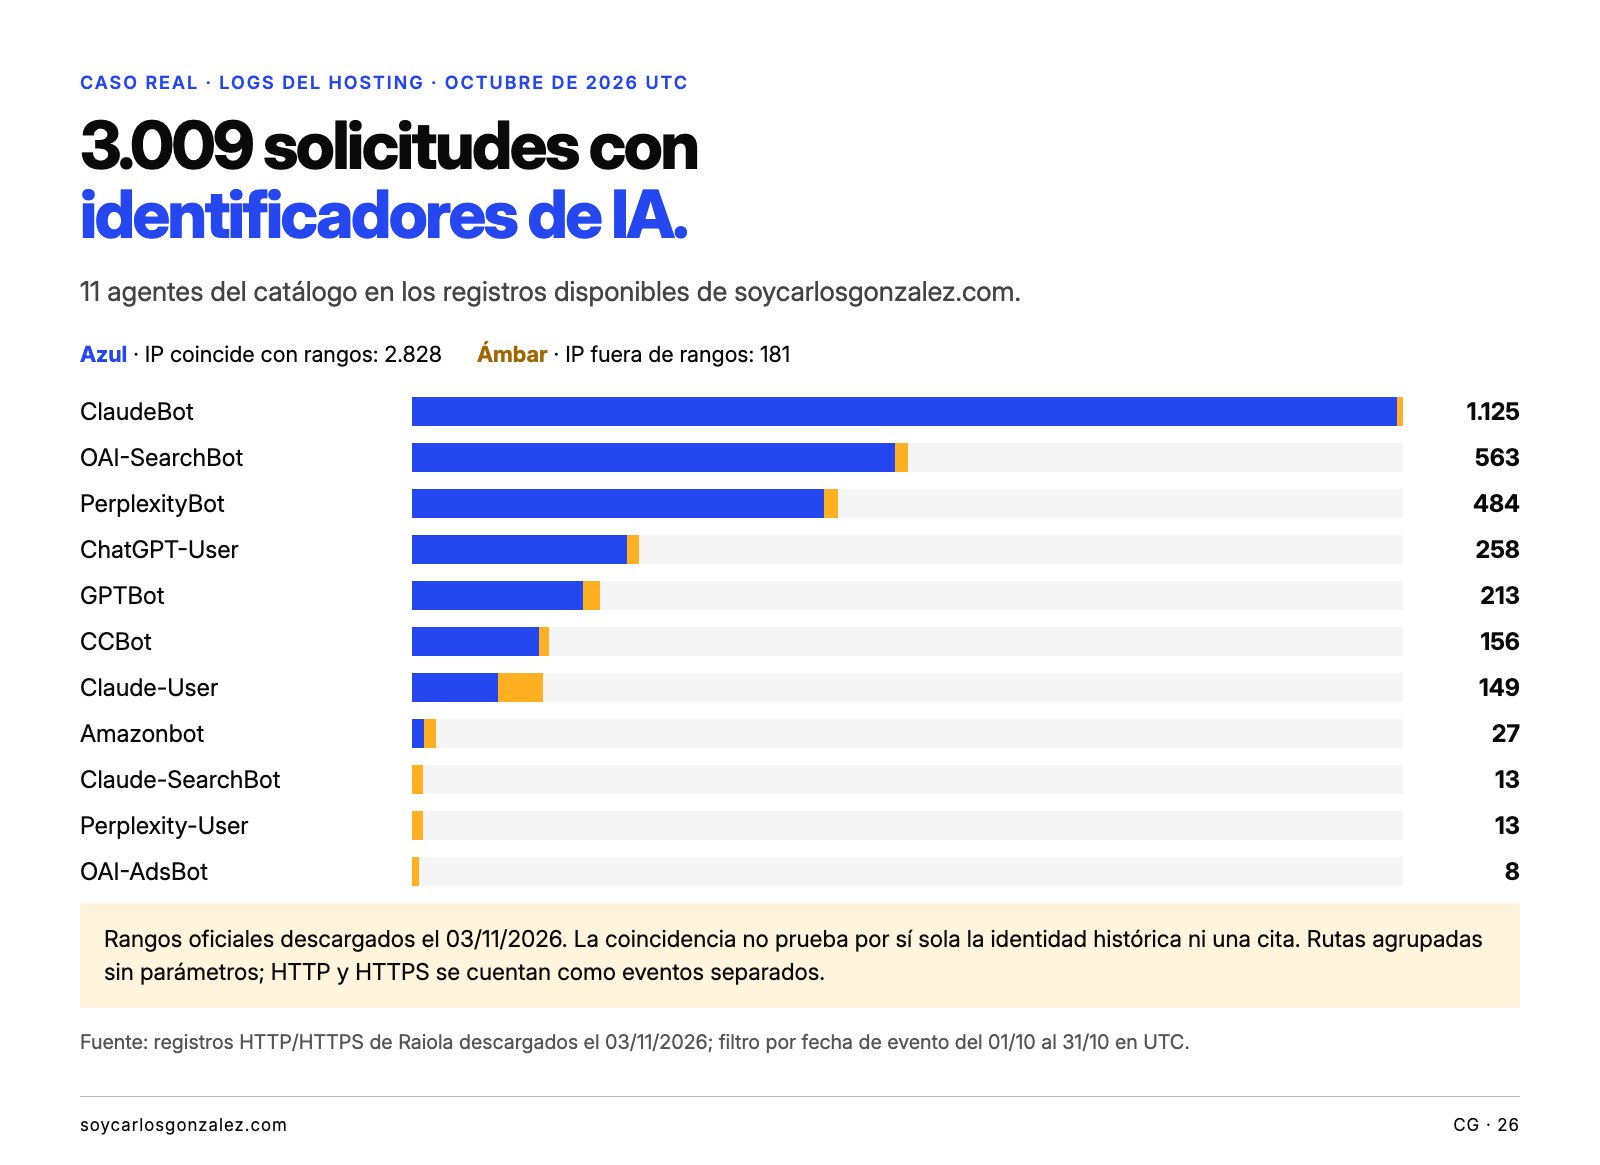
Qué cambia al contrastar las IP
2.828 solicitudes coinciden con los rangos oficiales consultados y 181 quedan fuera. No convertiría automáticamente esas 181 en «bots falsos»: estoy contrastando accesos de octubre con listas descargadas el 3 de noviembre, y hay que revisar la cobertura histórica, el campo de IP y el método de cada proveedor. En Anthropic, además, la lista de infraestructura es compartida por sus agentes.
Esta diferencia se ve en identificadores concretos. OAI-SearchBot figura en 563 solicitudes; 548 coinciden con sus rangos. ChatGPT-User aparece en 258; coinciden 244. Las trece que declaran Claude-SearchBot quedan fuera de la lista cargada. Esa fila exige investigar antes de atribuir los accesos a Anthropic.
Qué están solicitando
Las rutas más frecuentes son /robots.txt, con 715 solicitudes, /sitemap.xml, con 377, y la portada, con 292. Solo robots.txt y sitemap.xml reúnen 1.092 peticiones. Contarlas como lecturas de artículos inflaría la interpretación del resultado.
También se piden contenidos: /actualidad/resumen-semanal/semana-40-2026/ aparece 31 veces y /blog/query-fan-out-chatgpt/, 24. El log acredita esas solicitudes y sus respuestas; no demuestra que esos artículos hayan aparecido citados.
En este conjunto hay 2.621 respuestas 200, 152 redirecciones 301, 132 respuestas 404, 59 respuestas 403 y 45 respuestas 429. Revisaría los eventos y las URLs afectadas por esos estados antes de proponer cambios de acceso o de contenido.
Una trampa del archivo mensual
Para reconstruir octubre necesité los archivos de octubre y los de noviembre: estos últimos aportan 1.254 líneas del 31 de octubre. Si hubiera elegido el periodo por el nombre del .gz, las habría perdido. Por eso el filtro final se aplica a la fecha y zona horaria de cada registro.
No hay líneas idénticas entre archivos del mismo protocolo. Hay nueve coincidencias entre HTTP y HTTPS, que conservo porque pueden ser solicitudes legítimas iguales dentro de un segundo. Sin un identificador de petición no las elimino por parecido. La presencia de registros en los 31 días tampoco acredita que no haya huecos.
Alcance del caso: archivos de acceso disponibles en el hosting, catálogo de trece identificadores, agrupación por ruta sin query y contraste con listas oficiales del 03/11/2026. El conjunto completo supera el límite gratuito de Log File Analyser, por lo que estos agregados se han calculado con un script local. Las capturas de la herramienta utilizan el ejercicio sintético de 260 líneas. Los originales y las IP se conservan en privado.
Cómo relacionar los logs con tu visibilidad en IA
Los registros te ayudan a investigar el acceso al contenido. Para observar si una marca o URL aparece en una respuesta, necesitas guardar la consulta y la respuesta de esa ejecución. Para medir visitas humanas, utiliza los datos de analítica con la atribución que esté disponible.
Puedes seguir menciones y fuentes en Clicandseo y contrastarlas por páginas y periodos con los logs. Una coincidencia temporal entre una solicitud y una mención puede orientar una investigación, pero no demuestra que esa petición concreta haya generado la respuesta.
Si quieres profundizar en las consultas que genera un asistente, tienes el tutorial sobre cómo investigar las query fan-out de ChatGPT. Para revisar el contenido que depende de JavaScript, puedes seguir el análisis con SEO Spider.
Preguntas frecuentes
¿Cómo sé si ChatGPT visita mi web?
Sabes si bots de ChatGPT solicitan páginas de tu web buscando sus identificadores en los logs de acceso y verificando las IP con los rangos publicados por OpenAI. Revisa por separado OAI-SearchBot, ChatGPT-User y GPTBot, junto con el periodo y las respuestas recibidas.
¿Puedo saber cuántas veces me ha citado una IA con los logs?
No, con los logs no puedes saber cuántas veces te ha citado una IA. Los registros muestran solicitudes a la infraestructura observada. Para contar citas necesitas observar las respuestas en las que aparece tu marca o URL, con una metodología y una muestra definidas.
¿Google-Extended aparece en los logs del servidor?
No, Google-Extended no aparece como un user agent HTTP independiente en los logs del servidor. Google lo define como un token de control y utiliza identificadores existentes para rastrear. Una solicitud de Googlebot no identifica por sí sola una respuesta de IA concreta.
¿Puedo analizar estos bots con la versión gratuita de Screaming Frog?
Sí, puedes analizar estos bots con la versión gratuita de Screaming Frog Log File Analyser dentro de su límite de 1.000 eventos y un proyecto. El ejemplo de este artículo tiene 260 líneas. SEO Spider es una aplicación distinta.
¿Que no aparezca un bot significa que la IA no utiliza mi contenido?
No, que no aparezca un bot en tus logs no significa que la IA no utilice tu contenido. Revisa los filtros, la cobertura del archivo y la capa observada. Además, una respuesta puede utilizar información recuperada anteriormente o suministrada por otras fuentes.
¿Un código 200 demuestra que el bot ha leído mi página?
No, un código 200 no demuestra que el bot haya leído tu página. Acredita el estado HTTP registrado para esa solicitud. Comprueba el método, el contenido entregado y, si procede, las capas de protección que intervienen.
Fuentes y metodología
Documentación oficial revisada el 3 de noviembre de 2026. El catálogo incluye OpenAI, Anthropic, Perplexity, Amazon y Common Crawl; Google se trata por separado. El ejemplo de las capturas es sintético y no contiene registros de visitantes ni datos de clientes.
- OpenAI: identificadores, funciones y rangos de sus bots.
- Anthropic: bots de Claude y fuentes para identificarlos.
- Perplexity: rastreadores y accesos de usuario.
- Google: función de Google-Extended.
- cPanel: descarga de registros de acceso.
- Apache: formato Combined.
- Screaming Frog: guía de Log File Analyser, configuración y vistas.
- Cloudflare: estados de caché.
- Google Analytics: exclusión de bots conocidos.
- Common Crawl: identificación y rangos de CCBot
- Amazon: identificadores y rangos de sus bots
Si necesitas revisar los accesos de IA junto con el resto de problemas técnicos de tu web, puedes consultar mi servicio de auditoría SEO. Trabajo como consultor SEO en Sevilla para proyectos de toda España. Cuéntame tu caso.