Robots.txt es un protocolo de preferencia de acceso, no de uso, según Google
El vídeo se titula «What can you actually put in a robots.txt?», dura 9 minutos y 45 segundos y lo publicó el canal Google Search Central el 21 de octubre de 2026 a las 05:06, hora del Pacífico. Es el segundo episodio de la serie que Gary Illyes y Cherry Prommawin, de Google Search Relations, estrenaron el 14 de octubre con uno sobre URLs. La parte sobre IA empieza en el minuto 7:06, cuando Prommawin pregunta si robots.txt sirve para decirle a un modelo «you can crawl my site, but don't use my chicken diary to train your generative models». La respuesta de Illyes es que robots.txt solo expresa una preferencia de acceso, tal y como lo define el RFC 9309, del que él mismo es coautor.
La cita completa es esta: «robots.txt is an access-preference protocol. It only tells bots, "You can crawl this page," or, "You shouldn't crawl this other page." It doesn't dictate what a system does with the data after it has already crawled it». Y sobre la directiva en sí, «disallow bluntly means, "Do not enter the room." It has nothing to do with looking at my chicken diary or putting it in a database». Si lo que quieres es que un rastreador de IA concreto no entre, hay que nombrar su token de user-agent de forma explícita en el fichero. El vídeo no menciona Google-Extended, Google-Agent, AI Overviews ni AI Mode, y habla de «a system» en general, sin nombrar empresas ni políticas de uso.
El propio RFC 9309 lo recoge en su texto: las reglas «are not a form of access authorization». Las citas de este artículo salen de la transcripción que publicó Search Engine Roundtable el mismo 21 de octubre, que atribuye cada frase a quien la dice. PPC Land, que lo cubrió el mismo día, trabajó con los subtítulos automáticos de YouTube y avisa de que sus subtítulos no distinguen quién habla en cada momento.
Solo cuatro directivas: user-agent, allow, disallow y sitemap
Illyes describe el parser de Google como una máquina sencilla que lee línea a línea y busca solo cuatro reglas, user-agent, allow, disallow y sitemap. Lo que no entiende lo descarta, «If you mess up a line or try to get fancy with your spacing, the system will just silently discard the line it doesn't understand and move on». El ejemplo que pone es una línea «don't crawl secret page», que Google ignora por no ser una regla válida, con la consecuencia de que «might actually crawl your secret page anyway». Lo mismo pasa con cualquier regla inventada para la IA, que el parser «will just throw it in the trash, character by character».
Los comentarios con almohadilla sí valen, y de hecho se puede pegar un dibujo en ASCII sin romper nada, aunque Illyes lo califica de «a questionable life choice». Prommawin cuenta que encontró un robots.txt que era un 97% de relleno y un 3% de directivas, que no rompió ningún parser pero gastaba ancho de banda. La documentación de Google añade que el fichero debe ser UTF-8, que ignora el BOM y que solo lee los primeros 500 KiB; lo que sobre de ahí no se aplica.
Con los tokens de user-agent no hay margen. Según Illyes, «user-agent tokens can only have letters and dashes», así que un emoji o un carácter no ASCII en el token no se parsea. El RFC 9309 admite también el guion bajo, algo que el vídeo no menciona. En las rutas sí hay flexibilidad, el parser de Google codifica solo caracteres chinos, diéresis o emojis, pero Prommawin recomienda escribirlas ya en percent-encoding (/%F0%9F%90%94-gear en vez de /🐔-gear) porque «other or older crawlers on the web might get confused» e ignorar la línea entera de disallow.
Google-Extended, Google-Agent y lo que robots.txt no cubre en Google
Lo que el vídeo deja fuera está en la documentación de rastreadores de Google, actualizada el 15 de octubre. Google-Extended es un token sin user-agent propio que sirve «to manage whether content Google crawls from their sites may be used for training future generations of Gemini models» y para el grounding de Gemini y Vertex AI. Es decir, una preferencia de uso expresada dentro de robots.txt, aunque formalmente sea un grupo de user-agent más. Google aclara que no afecta a la inclusión en Search ni es señal de ranking, y esa página no menciona AI Overviews ni AI Mode.
Para esos dos, el control va por otro sitio. La página «Control what you share with Google Search», reescrita el mismo 21 de octubre, lista el control de IA generativa de Search Console y la etiqueta nosnippet (o data-nosnippet y X-Robots-Tag) como vías para quedar fuera de las funciones generativas de la búsqueda. Robots.txt no aparece entre ellas.
Y luego están los fetchers que dispara un usuario. La documentación es literal: «Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules». En esa lista está Google-Agent, el user-agent de los agentes alojados en Google que navegan y actúan por encargo del usuario, añadido en marzo de 2026, con rangos de IP propios y una identidad experimental con el protocolo Web Bot Auth. OpenAI dice lo mismo de ChatGPT-User en su documentación de bots, que puede no respetar robots.txt por ser una petición iniciada por el usuario.
TollBit y HasData: cuánto se respeta el disallow en la práctica
PPC Land acompaña el vídeo con dos estudios de cumplimiento. El informe State of the Bots de TollBit para el primer semestre de 2026, hecho con logs de servidor de los editores de su red, define «bypass» como un rastreo de un bot de IA identificado sobre una URL que el sitio le había prohibido en robots.txt. Su cifra es que alrededor del 15% de los rastreos de IA en sitios europeos ignoraron un disallow activo. La mediana de rastreos con bypass en un sitio europeo es 2,8 veces la de uno norteamericano, y por bot, ChatGPT-User saltó la prohibición en el 54% de sus rastreos, Bytespider en el 48% y PerplexityBot en el 42%. PPC Land lo formula como un 15% de los agentes; en el informe la métrica es sobre rastreos, no sobre agentes.
TollBit solo cuenta tráfico que se identifica como tal, avisa de que un disallow puede tardar entre 24 y 72 horas en reflejarse en los bots, y no publica cuántos sitios forman la muestra. Además, OpenAI sostiene que robots.txt puede no aplicarse a ChatGPT-User porque son peticiones iniciadas por un usuario, la misma lógica que Google aplica a Google-Agent. En tu dominio, el análisis de logs para identificar bots de IA permite comprobar qué agentes se presentan como tales y qué URLs solicitan.
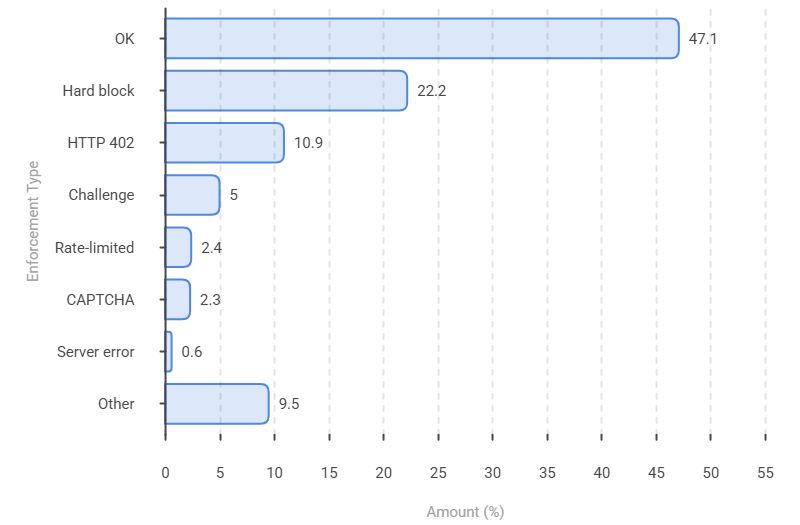
El segundo estudio es el AI Crawler Block Index de HasData, sobre 10.894 dominios (los 10.000 primeros de Tranco más 1.148 editores de noticias), con una medición en julio y otra el 16 de septiembre de 2026. Para medir el cumplimiento pidió la portada dos veces desde la misma IP de centro de datos, una con user-agent de Chrome y otra con el de GPTBot, falsificado, no desde la infraestructura de OpenAI. El resultado es que 234 de los 592 sitios probados sin errores que prohíben GPTBot le sirvieron la página igual, el 39,5%, en julio; en septiembre fue el 34,9%. Lo que mide es si el servidor hace cumplir su propio robots.txt, no si OpenAI lo respeta. HasData es una empresa de scraping y la prueba es una sola petición a la portada.
Mi lectura
Un disallow es un cartel de «no entres» que los bots educados respetan y que no dice nada de lo que ya tienen guardado. Si has entregado un robots.txt como «control de los rastreadores de IA», lo que has entregado es una preferencia, y conviene llamarla así delante del cliente. El control de verdad está en otras capas. Para Google, Google-Extended decide el entrenamiento y el grounding de Gemini, y el ajuste de Search Console o nosnippet deciden AI Overviews y AI Mode. Para el resto, si quieres que un bot no pase, toca bloquearlo en el servidor o en el CDN, que es justo lo que HasData dice que una parte grande de los sitios no hace.
Y ojo con el lado contrario, que es el que más me importa en el SEO para IA: si quieres que te citen, los rastreadores de búsqueda de los LLM tienen que poder entrar, y los agentes que navegan por encargo del usuario van a entrar igual, lo ponga o no tu robots.txt. Lo que sí decides es qué se encuentran cuando llegan, y eso ya es trabajo de Auditoría Web Agent.