Qué ha medido SISTRIX en 10.826 series de visibilidad en IA
Johannes Beus, fundador de SISTRIX, publicó el 28 de octubre de 2026 en el blog de la herramienta «Measuring AI visibility: why breadth beats repetition», con versión en español el mismo día. El análisis parte de 10.826 series diarias de medición en cuatro modelos y ocho países, sacadas de los datos de SISTRIX. Los modelos no se enumeran como tales, pero el texto dice que el patrón se repite en ChatGPT, AI Overviews, AI Mode y Perplexity. Los ocho países, el periodo de las series y cuántas marcas y prompts entran no se publican.
La pregunta del estudio es cuánto error tiene un dato de visibilidad en IA, el porcentaje de respuestas en las que aparece una marca, según cómo se mida. Beus lo plantea así: «It can be measured reliably, just not in the way many tools and guides suggest», es decir, que se puede medir de forma fiable, pero no como sugieren muchas herramientas y guías. Es el segundo estudio de SISTRIX sobre IA en una semana, después de SISTRIX compara 96.418 URLs del mismo dominio: el índice de contenidos multiplica por 1,7 las citas en la IA y llms.txt no tiene efecto medible, y responde a un artículo de Mike King en iPullRank del 17 de septiembre que defendía que en el seguimiento de la búsqueda con IA no existe la exactitud, solo la precisión.
El mismo prompt da un resultado distinto cada día
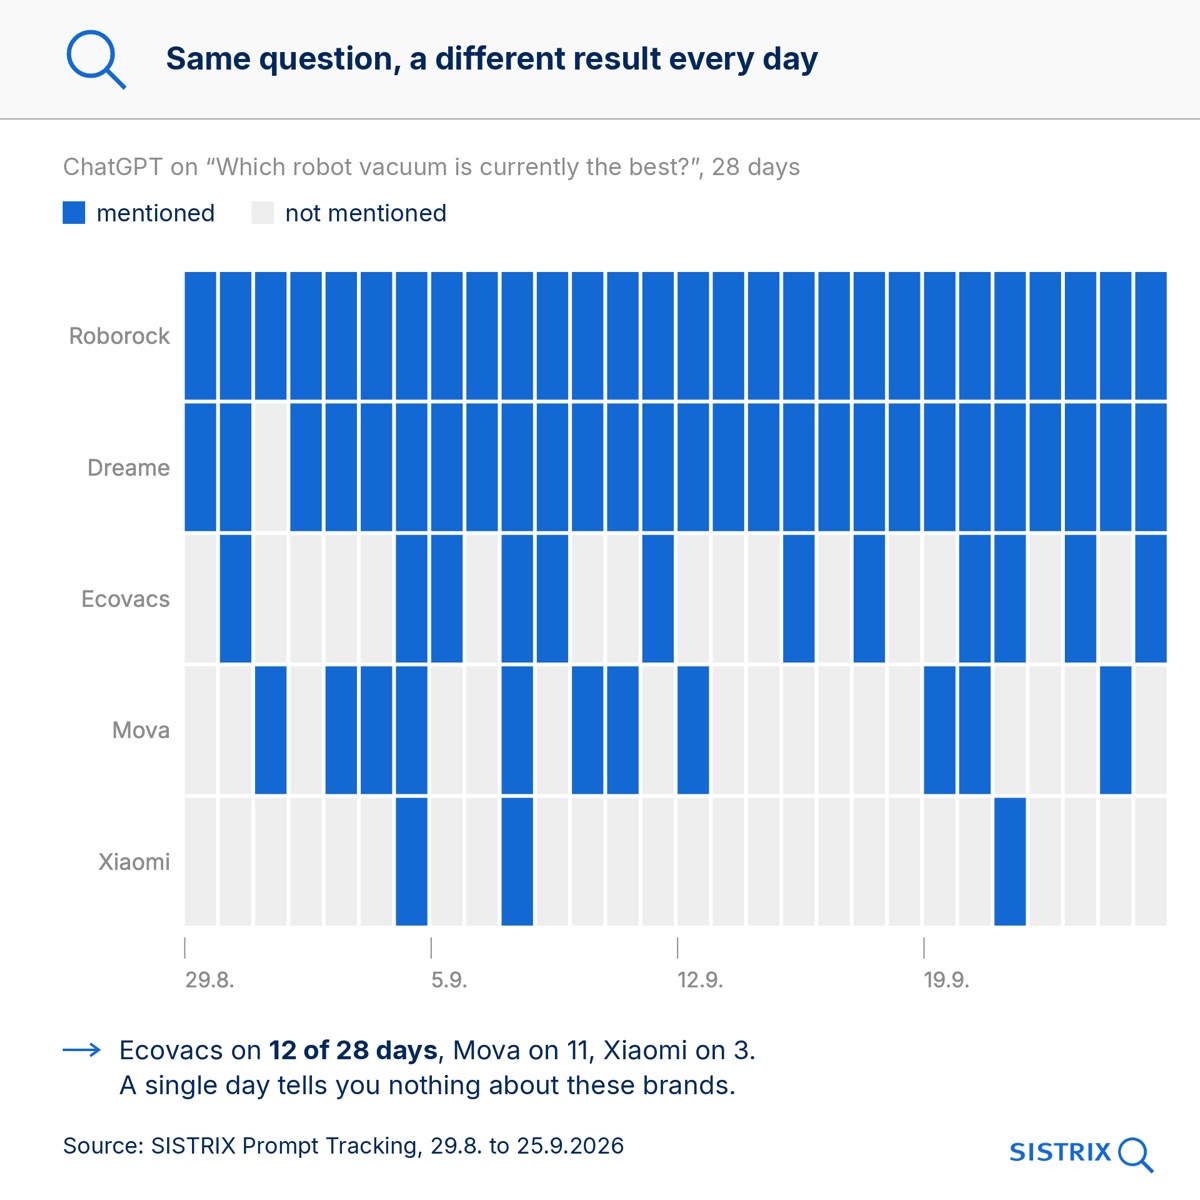
El ejemplo de partida es un prompt de ChatGPT, «Which robot vacuum is currently the best?», seguido durante 28 días con el Prompt Tracking de SISTRIX, entre el 29 de agosto y el 25 de septiembre de 2026. Roborock y Dreame salen casi a diario, pero Ecovacs aparece 12 de los 28 días, Mova 11 y Xiaomi 3, sin un patrón reconocible. La conclusión de Beus es que «checking on any single day therefore tells you practically nothing about these three brands», que mirar un solo día no dice prácticamente nada de esas tres marcas.
A escala, el patrón se mantiene. De las marcas que aparecen en las respuestas a un prompt, el 70% sale menos de uno de cada cinco días y solo el 6% sale al menos cuatro de cada cinco. SISTRIX lo compara con el experimento de Mike Sonders que citaba iPullRank, 12 prompts lanzados 100 veces en ChatGPT sin sesión, donde el 72% de las marcas aparecía en menos de una de cada cinco respuestas. La respuesta también cambia con quién pregunta, como se vio en Decir tu nivel de renta en el prompt cambia las marcas que recomienda la IA.
Veinte prompts distintos miden tres veces mejor que uno repetido 20 días
Para comparar los dos métodos, SISTRIX supone una marca que aparece en el 25% de las respuestas y un presupuesto de 20 consultas. Con un prompt repetido 20 días, la medición cae entre el 0% y el 59%; con 20 prompts distintos en un día, entre el 16% y el 35%, y con 100 prompts en un día, entre el 21% y el 29%. Son los rangos donde caen dos de cada tres mediciones, con desviaciones de ±34, ±9,5 y ±4,2 puntos. El artículo no explica cómo se fija ese 25% de referencia ni cómo se calculan los rangos a partir de las series.
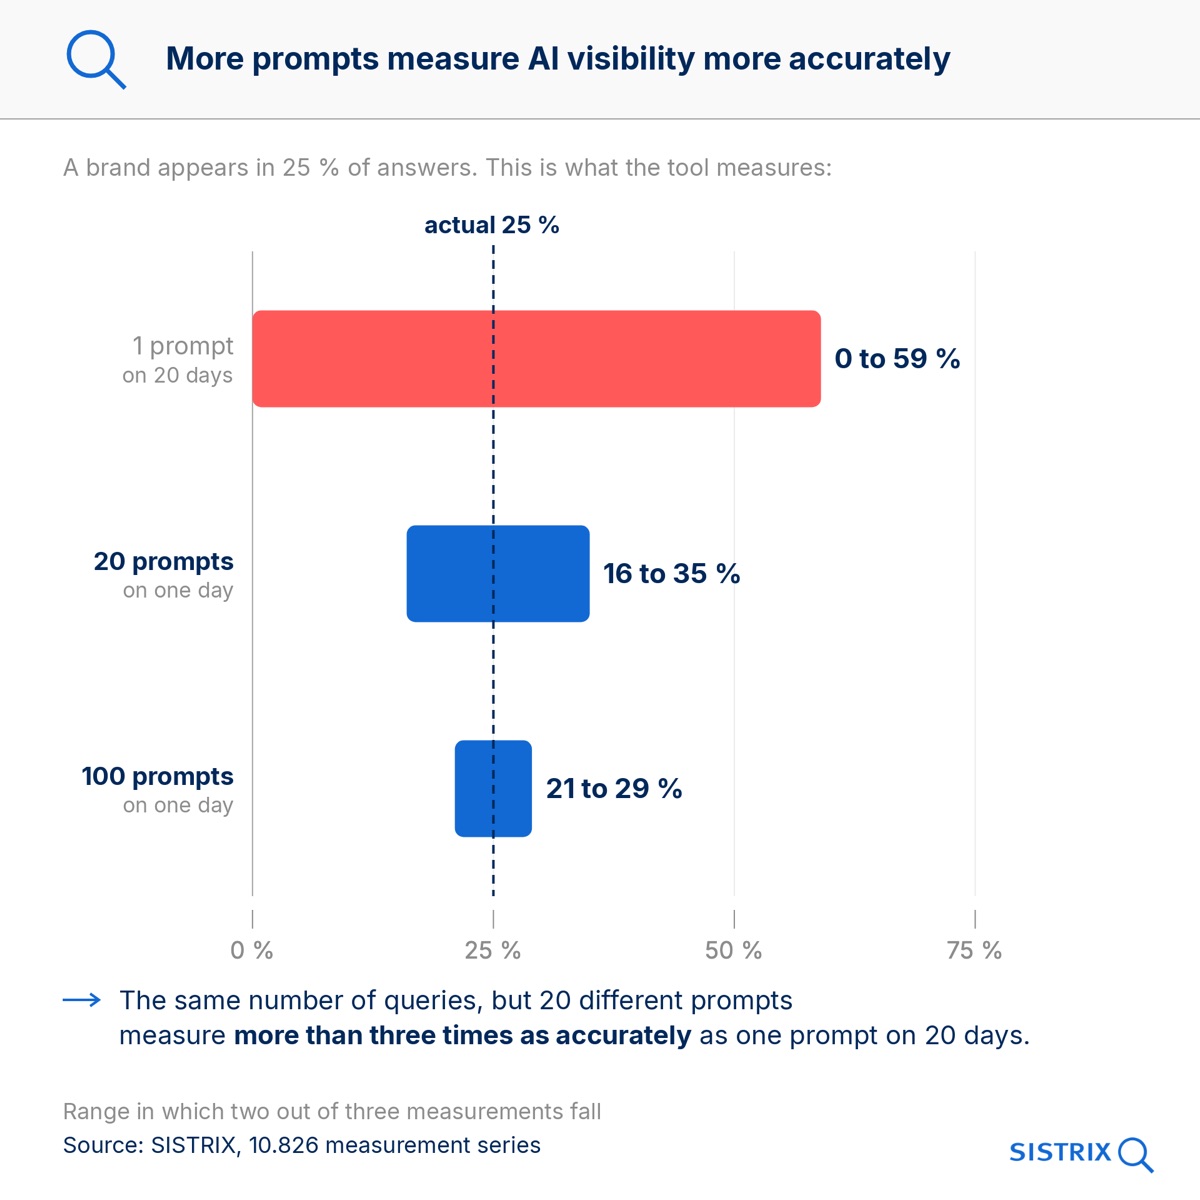
La razón que da Beus es que las diferencias entre prompts son 2,4 veces mayores que la fluctuación del mismo prompt de un día a otro. Repetir solo ataca la variación pequeña: «Repetition only tackles the smaller of the two». Con 20 prompts queda un suelo de ±7,6 puntos aunque se repitan sin límite, y con 20 prompts la desviación se mueve entre ±9 y ±10 puntos en todos los modelos y países.
De ahí sale la regla práctica del artículo: «halving the uncertainty takes four times as many prompts», reducir la incertidumbre a la mitad cuesta cuatro veces más prompts. Para un margen de ±5 puntos hacen falta unos 70 prompts y para ±3, unos 200. Y como la amplitud importa más que la frecuencia, SISTRIX recomienda 100 prompts semanales antes que 15 diarios.
Para ver cambios, medias semanales sobre un set fijo
El estudio separa dos preguntas: «'How visible am I?' is answered with breadth. 'Has anything changed?' is answered with repetition». Cuánta visibilidad tienes se contesta con amplitud, y si algo ha cambiado, con repetición sobre los mismos prompts. Con 20 prompts fijos, el valor diario tiene ±4,8 puntos de error y la media semanal, ±1,8. La media diaria salta 4 o 5 puntos sin que cambie nada, y uno de cada diez días, 10 o más.
Las mismas 140 consultas repartidas en 140 prompts distintos en un día dan ±3,6 puntos, frente a los ±7,9 de 20 prompts diarios con ventana móvil de siete días. En los datos semanales del AI Check, con 60 marcas por país en Alemania, Estados Unidos, Reino Unido, Francia, Italia y España, entre el 20% y el 55% de los prompts con mención cambia cada semana, la mitad en ChatGPT y AI Mode y uno de cada cinco en AI Overviews, pero el total de menciones solo varía entre un 4% y un 10%. La fluctuación semanal mediana baja del ±5,7% con menos de 100 prompts por marca al ±1,9% con 10.000 o más.
Los prompts que elige la marca la favorecen en 3 de cada 4 casos
La última parte compara los sets de prompts que eligen las propias marcas con el AI Check, que SISTRIX usa como «valor verdadero», definido como «the mention rate across all prompts in a market, as captured by the AI Check». La marca sale mejor parada en su propio set en 3 de cada 4 casos, entre el 63% y el 80% según cómo se definan los competidores. Beus lo llama «a selection effect», un efecto de selección y no un error de medición, y avisa de que las cifras de competidores dentro de un set propio son poco fiables. No dice cuántas marcas ni cuántos sets entran en esa comparación.
El valor de referencia es el AI Check, una herramienta que vende SISTRIX, y el artículo la enlaza y la presenta como más adecuada que cualquier set elegido por la marca, con un ±1-3% semanal para marcas con más de 1.000 prompts; el cierre reparte el trabajo entre AI Check para el nivel y Prompt Tracking para los cambios. No hay sección de limitaciones ni se explica si las consultas se hacen por API o por scraping, ni con sesión o sin ella.
Mi lectura
Con este estudio en la mano, lo primero que hay que preguntar a cualquier informe de visibilidad en IA es cuántos prompts distintos hay detrás y quién los ha elegido. Con 15 prompts de marca, una subida de cinco puntos de un mes a otro está dentro del ruido, y si los prompts los ha escogido la propia marca, el nivel sale inflado. Esto incluye a Clicandseo, mi herramienta de seguimiento de prompts, y la cuenta de SISTRIX le aplica igual que a las demás. Lo lógico es ampliar el set de prompts por temas antes que lanzar más veces los mismos, y leer los cambios por semanas sobre un set fijo. Que la referencia sea el AI Check de SISTRIX no cambia la cuenta de fondo, que es la de cualquier muestra.