4.238 ejecuciones de ChatGPT Web capturadas desde la propia sesión
El preprint se titula Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations y se subió a arXiv el 11 de octubre de 2026. Lo firman Yunxuan Jiang y Xiangyu Chang, de la Xi'an Jiaotong University (Jiang también del SGIT AI Lab de State Grid), y Shiqi Zhang, Anqi Xing y Xiaokui Xiao, de la National University of Singapore. Es la versión 1 y no ha pasado revisión por pares.
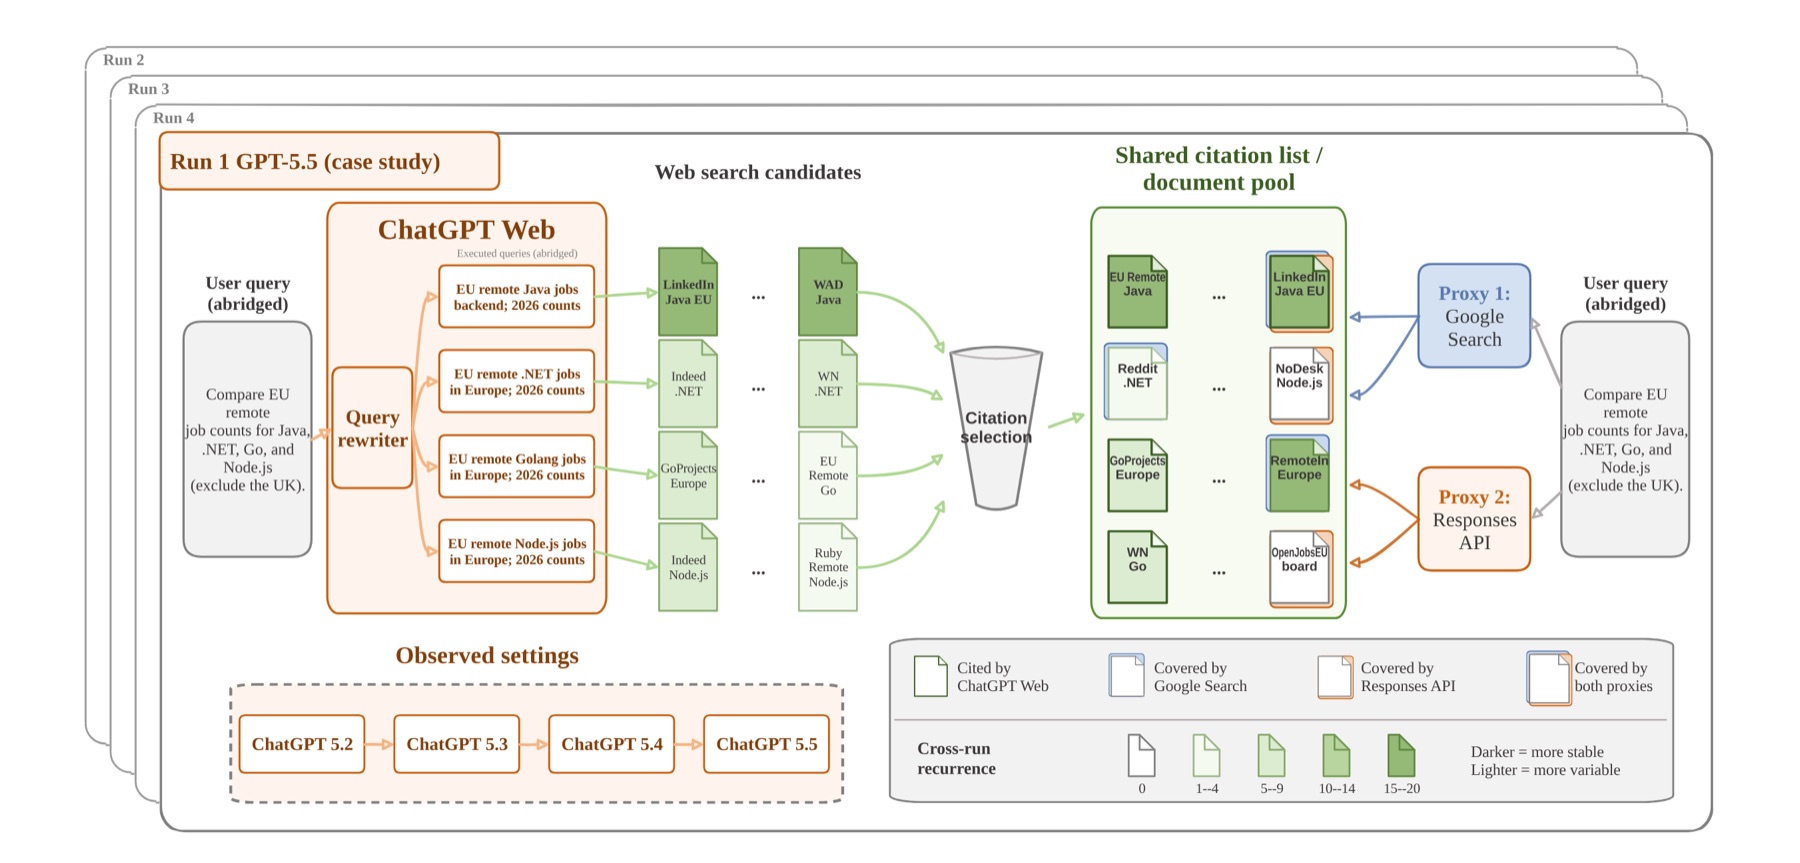
El método parte de las trazas SSE (el flujo de eventos que la web de ChatGPT recibe mientras genera la respuesta) de sesiones autenticadas de los propios autores. De cada traza sacan las consultas que ChatGPT ejecuta, las páginas candidatas, las páginas de apoyo y las citas finales. Es decir, miden el producto que usa la gente y no la API, que es lo que suelen medir los estudios de citación.
La muestra son 80 consultas tomadas de Search Arena, un conjunto de 24.000 interacciones reales, con cuatro intenciones (búsqueda de un dato, síntesis, análisis y recomendación) y la mitad en inglés y la otra mitad en chino. Se recogieron entre el 29 de marzo y el 29 de julio de 2026. Las configuraciones chatgpt-5.3-instant y chatgpt-5.5-instant tienen las 80 consultas con 20 ejecuciones cada una, 1.600 por modelo, mientras que chatgpt-5.2-instant (32 consultas, 547 ejecuciones) y chatgpt-5.4-thinking (30 consultas, 491 ejecuciones) quedaron incompletas porque OpenAI retiró esos modelos antes de terminar. Solo la 5.3 y la 5.5 se comparan con los proxies.
ChatGPT reescribe la consulta y casi nunca busca lo que escribió el usuario
El número de consultas ejecutadas por respuesta cambia mucho entre modelos: 2,36 en la 5.2, 1,06 en la 5.3, 11,82 en la 5.4 Thinking y 1,45 en la 5.5. Las ejecuciones con más de una ronda de búsqueda son el 17,4%, el 5,5%, el 71,3% y el 3,8%, respectivamente. La coincidencia exacta entre lo que escribe el usuario y lo que ChatGPT busca es del 5,5% en la 5.2 y del 0% en las otras tres configuraciones.
Con las preguntas en chino, la 5.2 lanzaba consultas en chino y en inglés en el 96,8% de las ejecuciones. La 5.3 y la 5.5 hacen otra cosa, y en el 67,0% y el 69,6% de las ejecuciones buscan solo en inglés aunque la pregunta llegue en chino. La 5.4 Thinking, además, va afinando en las rondas siguientes, con consultas site: que pasan del 25,1% en la primera ronda al 54,7% en las posteriores y frases entre comillas que suben del 1,0% al 22,7%.
Las URLs que más se recuperan son las que más se citan, con mucha variación entre ejecuciones
Repitiendo la misma consulta 20 veces, entre el 40,8% (5.3) y el 44,5% (5.5) de las URLs candidatas aparecen en una sola de las 20 ejecuciones. El solapamiento entre ejecuciones, medido con el índice de Jaccard, es de 0,30 por URL y de unos 0,40 por dominio o por entidad. Casi la mitad de las candidatas sale una sola vez, y el conjunto es más estable cuanto más se agrupa.
La frecuencia con la que una URL aparece entre las candidatas predice si acaba citada. El área bajo la curva (AUC) es de 0,619, 0,666 y 0,688 en la 5.3 a nivel de URL, dominio y entidad, y de 0,651, 0,709 y 0,711 en la 5.5. Es una señal moderada, y mejora al subir de URL a dominio.
La longitud del fragmento también cuenta. El 16,5-16,9% de los snippets de páginas citadas tiene 500 caracteres o más, frente al 1,5-1,9% de los no citados. La fecha de publicación no predice nada, con AUC de 0,482 y 0,535 e intervalos que incluyen el 0,5. El Max Planck publicó en septiembre otro preprint sobre esa misma distancia entre recuperar y citar, el de Cada agente de IA busca en la web a su manera, y las citas no miden lo mismo en cada uno.
Google y la Responses API recuperan el 26-28% de las URLs citadas y la mitad de los dominios
Los autores prueban dos proxies externos, que son las vías que tiene cualquiera que quiera estimar qué cita ChatGPT sin acceso a la interfaz. Uno es la Responses API de OpenAI con gpt-5.3-chat-latest y gpt-5.5 (este con el razonamiento a none), con 1.600 llamadas por modelo. El otro son las cinco primeras páginas de resultados orgánicos de Google vía SerpAPI, 43,2 resultados de media por consulta. Todo se recogió en la misma ventana de tres días por consulta.
Luego miden qué parte de lo que cita ChatGPT Web aparece en cada proxy. Google solo recupera el 9,4% de las URLs citadas por la 5.3 y el 6,4% de las de la 5.5, y a nivel de dominio el 26,1% y el 22,8%. Las candidatas de la API llegan al 22,9% y al 22,5% de las URLs, y al 38,3% y 38,1% de los dominios. Las citas de la API, al 12,3% y al 13,0% de las URLs. Uniendo todo, el 28,3% y el 26,2% de las URLs citadas, el 50,3% y el 48,7% de los dominios y el 50,7% y el 45,1% de las entidades. El resumen del paper lo dice así: "Even when combined, they recover only about one quarter of cited URLs".
La API gana en precisión, y más con el modelo nuevo. De la 5.3 a la 5.5, la precisión de las citas de la API pasa del 16,4% al 23,3% por URL y del 27,7% al 40,5% por dominio, con la cobertura prácticamente igual. Dicho de otra forma, lo que cita la API se parece más a lo que cita ChatGPT Web, pero no cubre más.
Por último, combinan las señales de Google y de la API en un modelo XGBoost que predice qué candidatas se citan. Llega a un AUC de 0,782 por URL en la 5.3 y de 0,779 en la 5.5, pero solo ordena lo que ya está dentro del conjunto externo, así que el techo lo marca la cobertura: aunque ordenara perfecto, no pasaría del 26-28% de las URLs citadas.
Lo que el estudio de citas de ChatGPT no cubre
Es un estudio observacional y los autores lo repiten en varias secciones. No hay causalidad, y lo escriben en la discusión: los resultados "do not imply that publishing more pages or making a source appear more often in retrieval will increase its likelihood of being cited". Tampoco evalúan ninguna técnica GEO, y no separan las marcas del resto de entidades.
La definición de cita es amplia. Incluye las páginas de apoyo que cuelgan de una referencia seleccionada aunque el usuario no las vea por separado, de modo que no equivale a la cita visible en pantalla. En la 5.3 solo ven las consultas internas en 1.339 de las 1.600 ejecuciones, y dos sesiones pasaron sin aviso a un modelo de reserva tras 14 y 16 ejecuciones correctas.
La muestra son 80 consultas en inglés y en chino, sin país de recogida declarado y sin ningún dato en español. Las etiquetas de los modelos (chatgpt-5.x-instant y chatgpt-5.4-thinking) son las internas que aparecen en las trazas, no nombres comerciales, y la 5.4 Thinking usa consultas distintas a las de las versiones Instant, así que sus cifras no se comparan directamente con las demás.
Mi lectura
Casi cualquier medición de visibilidad en ChatGPT tira de un proxy, porque nadie tiene las trazas de la sesión de tu cliente. Con estos números, el informe por dominio y por entidad es el que aguanta, y el de «esta URL concreta sale citada» hay que leerlo con mucha cautela, porque a nivel de URL ves una de cada cuatro citas. Y con un 40% de candidatas que salen una sola vez en veinte ejecuciones, lanzar el prompt una vez y hacer una captura no es un dato. Hay que repetirlo y mirar frecuencias.
El estudio no tiene ni una consulta en español, así que lo que sigue es hipótesis. Si con preguntas en chino la 5.3 y la 5.5 buscaron solo en inglés en dos de cada tres ejecuciones, conviene comprobar qué consultas lanza ChatGPT de verdad con tus prompts en español, que es justo lo que enseño en el tutorial de Query fan-out de ChatGPT. Si busca en inglés, tu contenido compite con el de fuera aunque el usuario pregunte en español.