Qué es OpenAI Signals v3.0 y cómo se ha construido
El 26 de octubre de 2026 OpenAI publicó en su sección de investigación el post «ChatGPT's expanding world of work» y, con él, la versión 3.0 de OpenAI Signals, el dataset de su unidad de investigación económica. Son 24 ficheros CSV más un README de ocho páginas, descargables en un zip de 2 MB con licencia CC BY 4.0. El post va firmado por «OpenAI»; los nueve autores (Chatterji, Cunningham, Deming, Hitzig, Johnston, Martin Richmond, Ong, Shan y Wadman) solo aparecen en la cita BibTeX.
La muestra es de «1,000,000 consumer ChatGPT messages each month from July 2024 to September 2026», un millón de mensajes al mes durante 27 meses, de cuentas con edad declarada de al menos 18 años en los planes Free, Go, Plus y Pro. Quedan fuera Enterprise y Codex, y el README lo reconoce: «these data likely understate business use», es decir, que los datos probablemente infravaloran el uso empresarial. La versión 3.0 añade julio-septiembre de 2026 y vuelve a muestrear todo el histórico, que en las versiones anteriores era de 300.000 mensajes al mes.
La clasificación la hacen «LLM-based classifiers», clasificadores basados en modelos de lenguaje, con los mismos prompts del paper «How People Use ChatGPT» de 2025. El clasificador de tema produce 24 etiquetas finas que se publican agrupadas en siete temas: escritura, orientación práctica, buscar información, expresión personal, ayuda técnica, multimedia y otros. «Buscar información» junta tres etiquetas: información concreta que suele estar en webs (personas conocidas, actualidad, hechos), productos y servicios a la venta, y recetas.
Para proteger a los usuarios, OpenAI aplica privacidad diferencial con ruido gaussiano (épsilon de 1 para el último trimestre, más laxo en los periodos republicados) y suprime cualquier celda con 100 mensajes o menos. El post lo resume así: «We publish aggregated statistics, withhold results for small groups, and add statistical noise to protect individual messages». Publican agregados, retiran los grupos pequeños y añaden ruido.
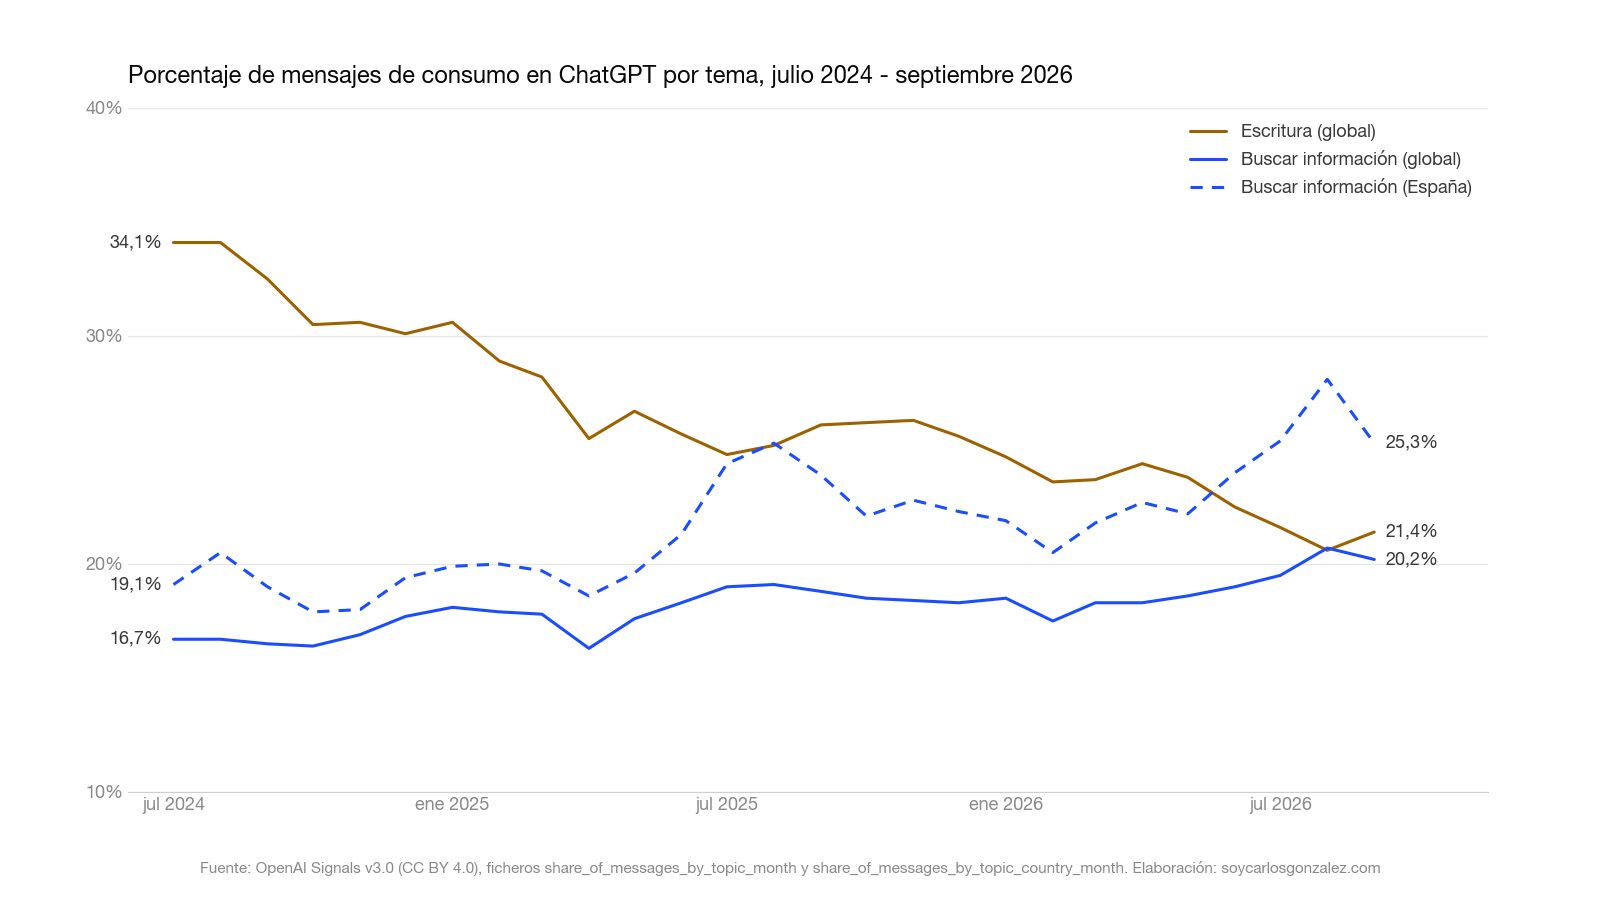
La escritura cae del 34,1% al 21,4% y buscar información sube al 20,2%
El fichero de temas por mes da la serie completa. La escritura era el 34,1% de los mensajes en julio de 2024 y es el 21,4% en septiembre de 2026. Buscar información pasa del 16,7% al 20,2% en el mismo periodo. En agosto de 2026 las dos categorías se cruzaron por primera vez, con un 20,7% de información frente a un 20,6% de escritura, y en septiembre la escritura volvió a ponerse por delante por poco.
La categoría más grande no es ninguna de las dos. Orientación práctica (cómo hacer algo, tutorías, salud, ideas) es la primera desde marzo de 2025: pasa del 26,1% al 28,1% con un pico del 33,1% en abril de 2026. La ayuda técnica, donde entra la programación, cae del 13,5% al 4,6%, y multimedia, expresión personal y «otros» crecen cada una hasta rondar el 8-9%.
Dentro de buscar información hay un movimiento que el post no comenta. La parte de esas consultas que es laboral bajó del 33,1% en julio de 2024 al 17,8% en julio de 2026 y repuntó al 24,3% en septiembre, en solo dos meses. OpenAI no lo explica; PPC Land lo relaciona con la fusión de las apps de Chat, Work y Codex del 9 de julio de 2026, sin confirmación oficial.
España: buscar información ya es el 25,3% y va al revés que Latinoamérica
El fichero por país permite sacar la serie española, que no aparece en el post ni en las coberturas. En España buscar información pasa del 19,1% al 25,3% de los mensajes, con un máximo del 28,1% en agosto de 2026, y la escritura cae del 35,5% al 17,9%. Orientación práctica sube del 24,2% al 30,0%. Es decir, en España la escritura ha caído más que en la media global y la búsqueda de información ha subido más.
La comparación con otros mercados hispanohablantes va en dirección contraria. En México buscar información baja del 20,0% al 16,8%, en Argentina del 19,5% al 16,3% y en Colombia del 18,0% al 14,7%. En Estados Unidos sube del 18,0% al 20,2%, igual que la media. Con el ruido y la supresión de celdas pequeñas del dataset, las cifras por país y mes llevan más incertidumbre que las globales, pero la tendencia española es sostenida durante los 27 meses y la caída latinoamericana también.
El uso laboral baja del 51,6% al 32,2% y sube con el precio del plan
El post se centra en el trabajo: «Today, we are releasing OpenAI Signals data that explores 165 work activities across nearly 100 countries», 165 actividades laborales de la taxonomía O*NET en casi cien países, por trimestres desde principios de 2025. Pero el fichero de mensajes laborales cuenta otra cosa: los mensajes relacionados con el trabajo eran el 51,6% en julio de 2024 y son el 32,2% en septiembre de 2026, con un mínimo del 29,5% en agosto. En España la caída es del 52,3% al 28,6%.
El reparto por plan en septiembre de 2026 va con el precio. Uso laboral del 24,7% en Free, 42,4% en Go, 50,8% en Plus y 68,1% en Pro. Y en las 74 economías con datos todos los trimestres, las diez actividades laborales más frecuentes pasan del 56,0% al 51,1% de los mensajes de trabajo clasificados, que OpenAI lee como una diversificación de tareas.
El 18,3% de Signals frente al 24% del paper de 2025, y lo que el dataset no mide
El paper «How People Use ChatGPT» (NBER, septiembre de 2025, de los mismos autores) decía que «Seeking Information has grown from 14% to 24% of all usage» entre julio de 2024 y julio de 2025, y que la escritura había bajado del 36% al 24%. Signals v3.0 da para junio de 2025 un 18,3% de información y un 25,7% de escritura, y para julio de 2024 un 16,7% de información. Casi seis puntos de diferencia en la misma categoría y el mismo mes, con el mismo pipeline de clasificación.
OpenAI no explica la diferencia ni en el post ni en el README. Hay diferencias de método a la vista: el paper muestreaba 1,1 millones de conversaciones con medias móviles de 28 días y Signals muestrea mensajes por mes natural, con ruido de privacidad diferencial y un histórico remuestreado en cada versión. El README avisa de que las cifras de periodos anteriores cambian con cada republicación. Search Engine Journal y PPC Land señalan que no hay reconciliación oficial entre las dos series.
Hay una segunda ausencia. El dataset no contiene nada sobre búsqueda web, navegación, citas ni enlaces: las palabras «search», «browse» y «citation» solo aparecen en el README como nombres de actividades laborales. Tampoco publica por separado la etiqueta de productos y servicios a la venta, que va fundida en buscar información. La frase del paper de 2025 que describía esa categoría como «a very close substitute for web search», un sustituto muy cercano de la búsqueda web, no está en Signals v3.0.
Mi lectura
Una de cada cuatro peticiones a ChatGPT en España es ya buscar información, y eso con una categoría que mezcla hechos, productos y recetas. Lo que el dato no te dice es qué pasa después, si esa consulta acaba en una búsqueda web, en un enlace o en una respuesta sin fuente. Ya comenté en Google y la API de OpenAI recuperan una de cada cuatro URLs que cita ChatGPT lo poco que se sabe de esa parte, y Signals no añade nada ahí. Así que la demanda crece y el clic no tiene por qué seguirla; para una marca lo que se puede medir es si aparece en esas respuestas y a quién citan, y ahí aviso de que barro para casa, porque eso es justo lo que hace Clicandseo, que es mía.
La otra lectura es que ChatGPT sigue siendo una capa encima de la búsqueda y no un sustituto. La categoría grande es orientación práctica, el «hazme esto» o «explícame cómo», que antes no se escribía en un buscador. Donde sí hay un hueco es en el 25% informacional español, con la escritura cayendo y la búsqueda subiendo más que en la media global y al revés que en México, Argentina o Colombia. Si trabajas contenido en español, el mercado español y el latinoamericano se están comportando distinto dentro de ChatGPT, y lo que explico en Cómo aparecer en ChatGPT conviene aplicarlo mirando el país, y no el idioma.