Casi todo lo que se escribe sobre cómo aparecer en ChatGPT va de lo que tienes que hacer. Hoy vamos a darle la vuelta, y te voy a contar lo que no tienes que hacer si quieres tener, al menos, la posibilidad de que las inteligencias artificiales usen tu contenido para mencionarte ante un prompt determinado.
Te cuento las cosas que no tienes que hacer para que puedan rastrear tu web correctamente. Cada punto va con lo que tienes que revisar y con la documentación oficial de cada plataforma. Y si quieres verlo de forma breve, te dejo un carrusel para que te lo puedas descargar y no se te olvide nunca.
¿Lo quieres guardar? Descarga el carrusel en PDF.
Memoria y búsqueda: las dos vías para salir en las respuestas de la IA
Antes de explicar los bloqueos, es importante separar dos formas en las que la IA genera sus respuestas, porque de esa separación depende que entiendas qué bots te interesa bloquear y cuáles no.
La primera es la capa de memoria, es decir, lo que el modelo aprendió durante su entrenamiento. Esa información ya está en su corpus, en su memoria, así que no necesita acudir a internet para responder a tu pregunta o a tu prompt (a no ser que tú se lo pidas de forma explícita, y entonces entra en juego la segunda capa).
La segunda es la capa de búsqueda, que se activa cuando la IA accede a internet para encontrar la respuesta. Lo hace en tres casos:
- Porque tú se lo has pedido.
- Porque no tiene esa información en su memoria.
- Porque el tipo de consulta lo requiere, como cuando preguntas por algo que ha pasado esta semana.
Para las dos capas hay bots distintos. Es decir, cada IA tiene sus user-agents: bots que entran en tu web o bien para entrenarse con la información que encuentran, o bien para acceder a la información que un usuario necesita en ese momento. En este segundo caso cogen un trocito de contenido de tu web para montar la respuesta junto con los trocitos que hayan sacado de otras webs, y ahí es donde te pueden mencionar.
Así que bloquear un bot u otro puede tener efectos inmediatos en tu visibilidad, y quizá no lo sabes. Vamos con el primer punto, que habla justo de esto.
1. No bloquees a los bots de IA desde el servidor, el firewall o la CDN
Es el bloqueo más traicionero porque no se ve. Tu web carga perfectamente en el navegador, el robots.txt está limpio, y aun así un firewall, una CDN o una regla por IP le devuelve un 403 al bot antes de que llegue a tu contenido. Muchas veces el bloqueo no es una decisión consciente, porque viene activado de serie en un plan de hosting, en un plugin de seguridad o en la configuración de la CDN.
Cloudflare debe ser el primer sitio donde mirar
Cloudflare gestiona una parte muy grande de la web, y en el último año ha cambiado varias veces cómo trata a los rastreadores de IA:
- Julio de 2025. Con su «Content Independence Day», empezó a preguntar a cada dominio nuevo si quería permitir los rastreadores de IA, con el bloqueo como opción por defecto.
- Septiembre de 2025. Lanzó la Content Signals Policy, que añade al robots.txt gestionado tres señales (
search,ai-inputyai-train). El propio Cloudflare aclara que son preferencias declaradas y que no funcionan como un bloqueo técnico. - Julio de 2026. Separó el control en tres categorías: búsqueda, agentes y entrenamiento, disponibles también en el plan gratuito.
Y esto es importante. A partir del el 15 de septiembre de 2026, en los dominios nuevos el entrenamiento y los agentes quedan bloqueados por defecto en las páginas con anuncios, y la búsqueda permitida. Además, Cloudflare avisa de que los rastreadores de uso mixto como Googlebot, Applebot o Bingbot quedan bloqueados para quien tenga marcado el bloqueo de entrenamiento, ya sea con las opciones nuevas o con el antiguo «Block AI bots». En pocas palabras: si un día marcaste esa casilla pensando solo en GPTBot, revisa ahora qué hace, porque puede estar afectando también a Google y a Bing.
Qué revisar en el servidor
- La configuración de bots de tu CDN o WAF (en Cloudflare, el panel de AI Crawl Control y las reglas de seguridad).
- Los plugins de seguridad de tu CMS y las reglas del hosting que bloquean por user-agent o por país.
- Las reglas por IP. Cada plataforma publica sus rangos: OpenAI tiene un JSON por bot, y también lo hacen Perplexity y Anthropic.
- Que tu robots.txt responda con un 200. El estándar del robots.txt (RFC 9309) dice que si el fichero devuelve un error de servidor (5xx), el rastreador tiene que asumir que todo está prohibido. Un firewall que rompe el robots.txt equivale a un
Disallow: /para todo el mundo.
2. No bloquees en robots.txt sin saber a quién y por qué
El robots.txt es aquello que tú controlas para permitir o negar el acceso a ciertos bots, pero recuerda: es una sugerencia, no es una directiva. Es decir, tú puedes bloquear, pero muchos bots de IA no lo van a respetar.
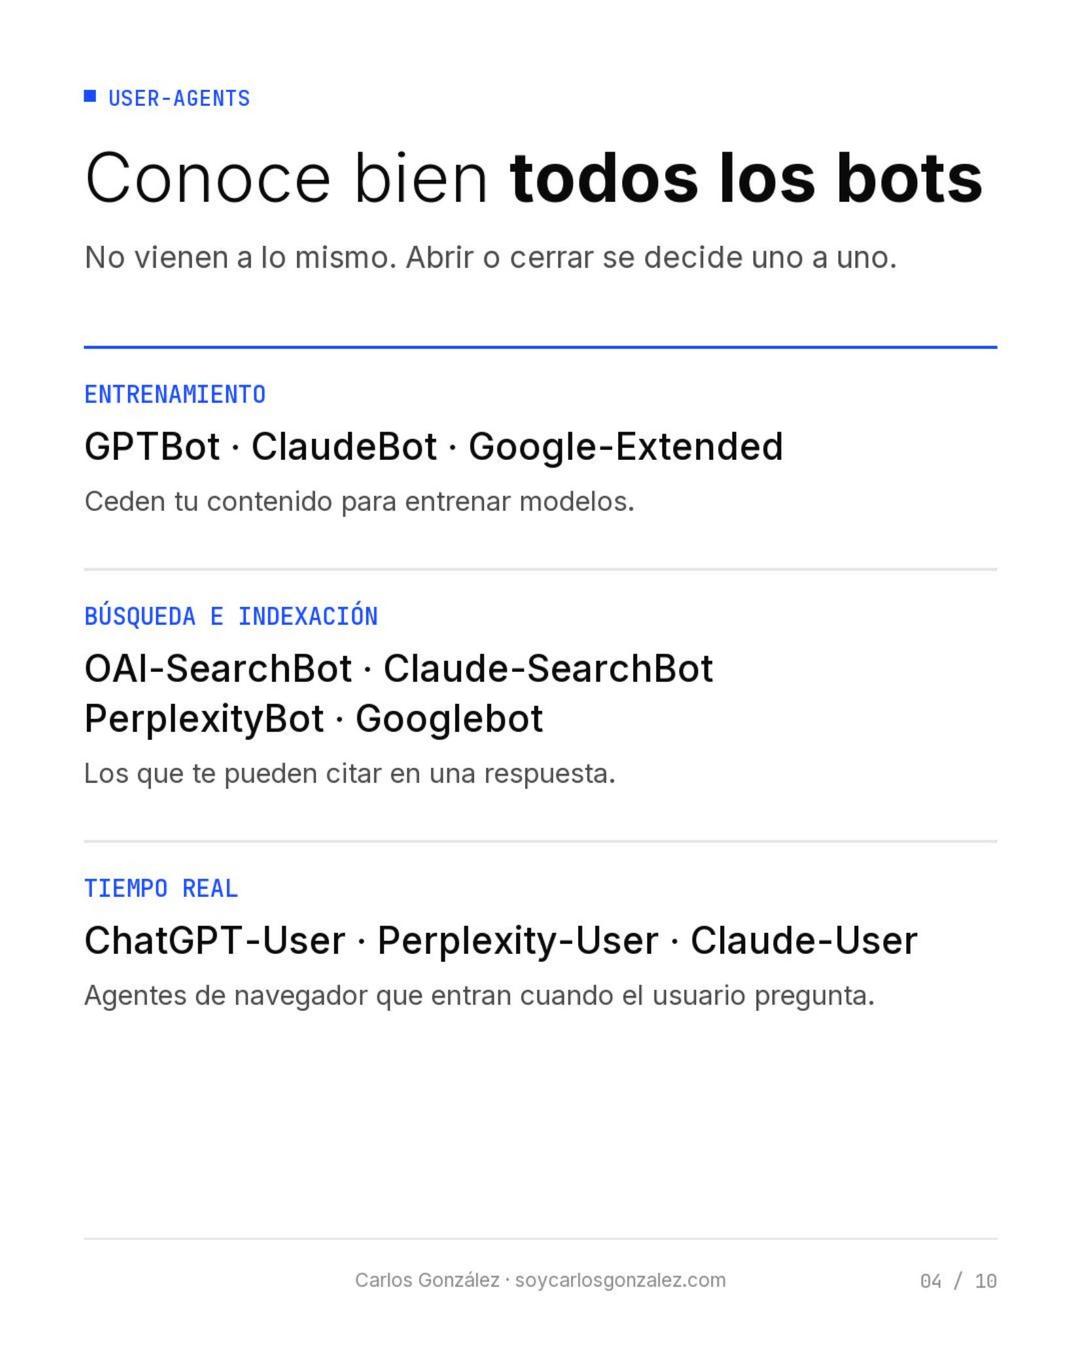
Un error muy habitual en el robots.txt es meter a todos los bots de IA en el mismo saco. Cada bot se identifica con su user-agent, y cada uno viene a una cosa distinta:
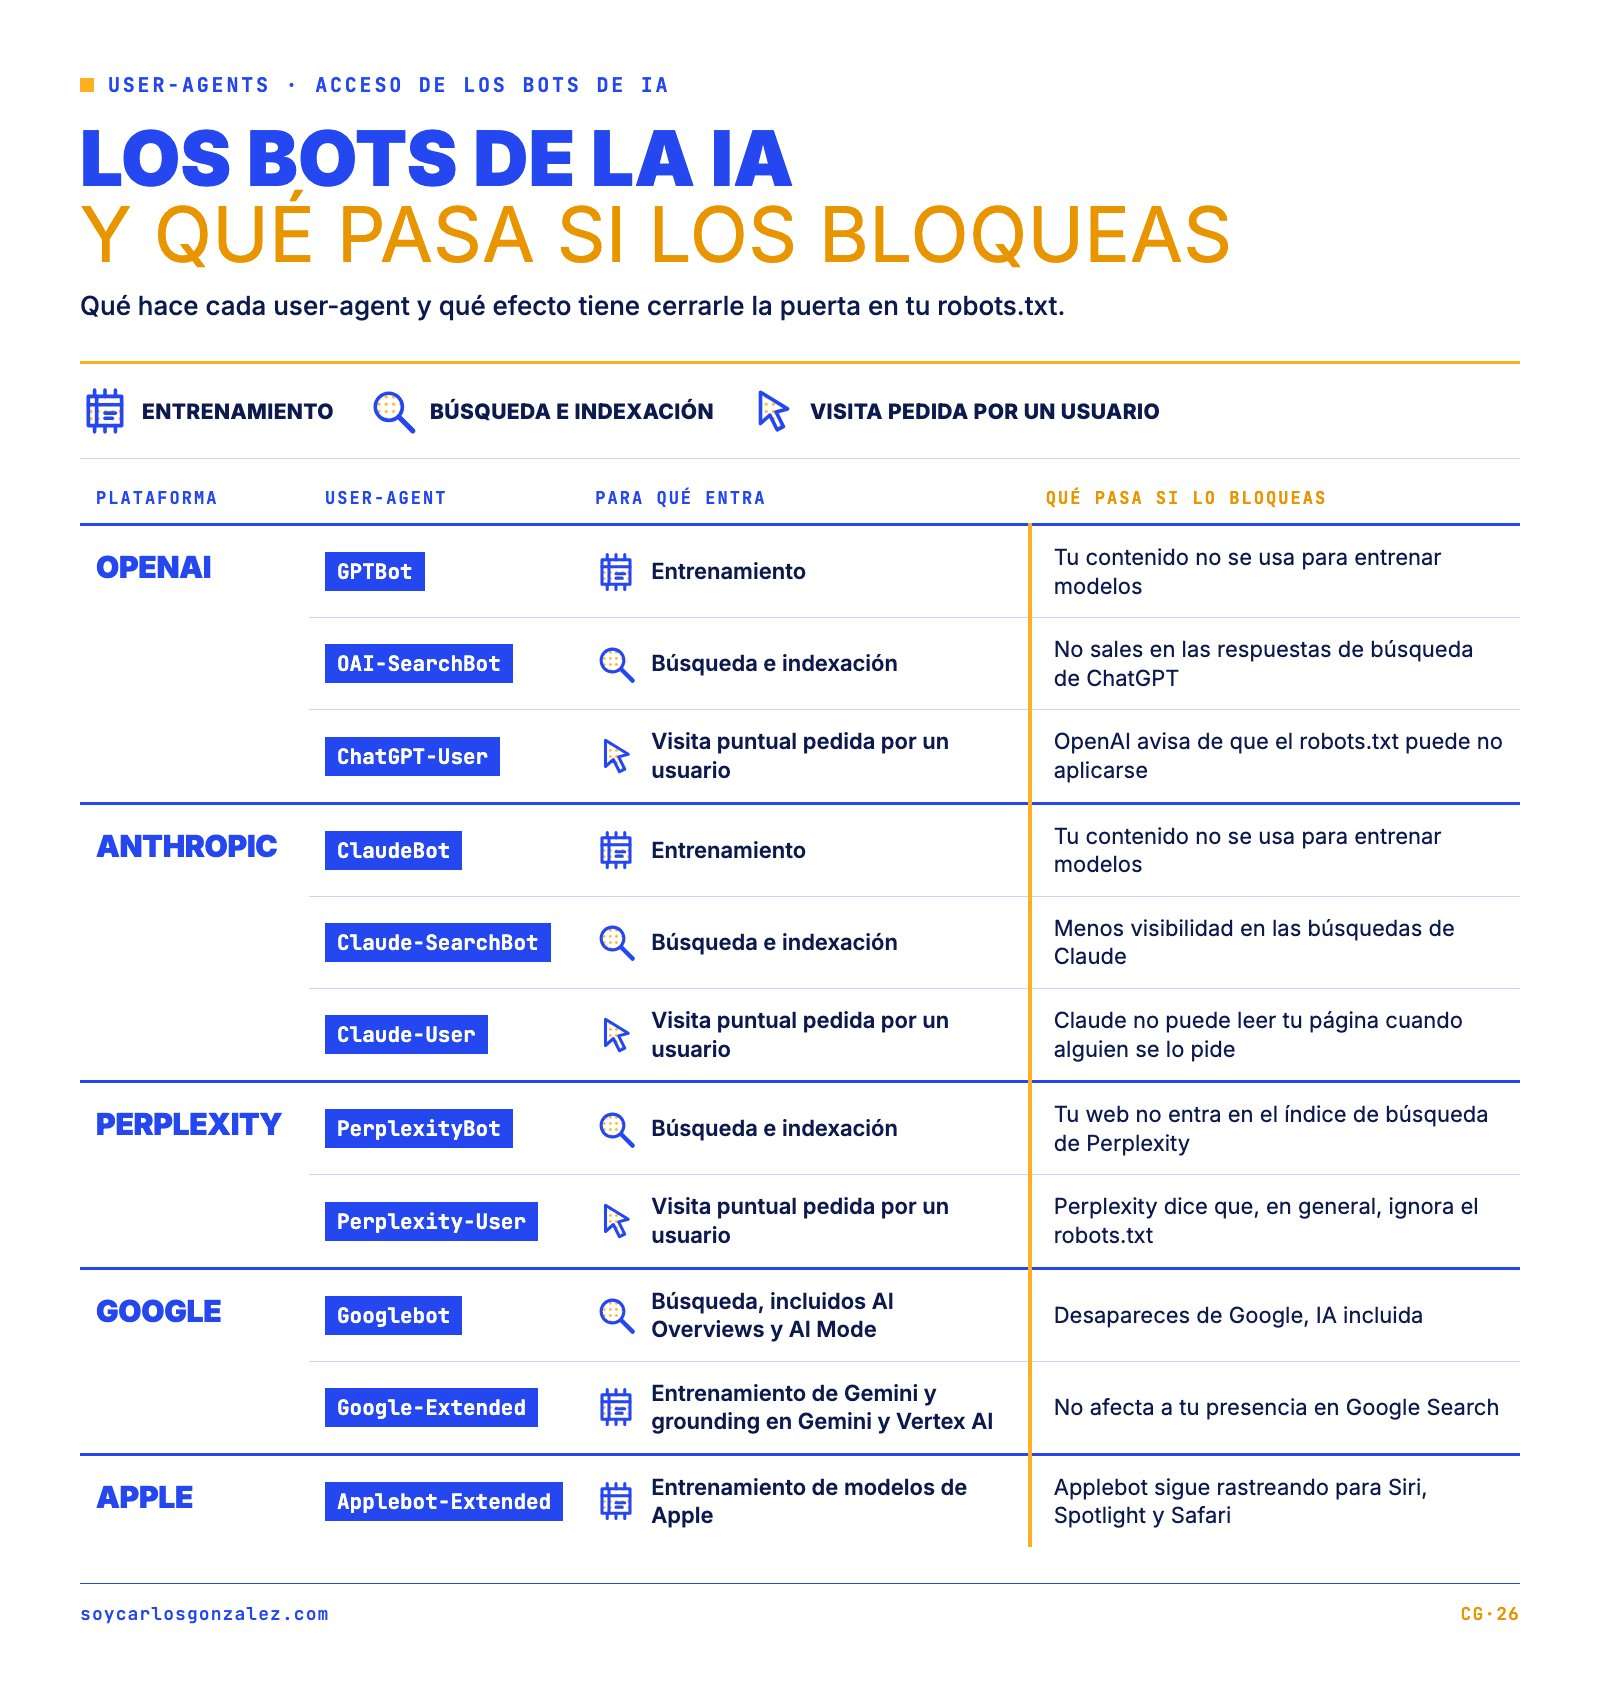
| Plataforma | User-agent | Para qué entra | Qué pasa si lo bloqueas |
|---|---|---|---|
| OpenAI | GPTBot | Entrenamiento | Tu contenido no se usa para entrenar modelos |
OAI-SearchBot | Búsqueda e indexación | No sales en las respuestas de búsqueda de ChatGPT | |
ChatGPT-User | Visita puntual pedida por un usuario | OpenAI avisa de que el robots.txt puede no aplicarse | |
| Anthropic | ClaudeBot | Entrenamiento | Tu contenido no se usa para entrenar modelos |
Claude-SearchBot | Búsqueda e indexación | Menos visibilidad en las búsquedas de Claude | |
Claude-User | Visita puntual pedida por un usuario | Claude no puede leer tu página cuando alguien se lo pide | |
| Perplexity | PerplexityBot | Búsqueda e indexación | Tu web no entra en el índice de búsqueda de Perplexity |
Perplexity-User | Visita puntual pedida por un usuario | Perplexity dice que, en general, ignora el robots.txt | |
Googlebot | Búsqueda, incluidos AI Overviews y AI Mode | Desapareces de Google, IA incluida | |
Google-Extended | Entrenamiento de Gemini y grounding en Gemini y Vertex AI | No afecta a tu presencia en Google Search | |
| Apple | Applebot-Extended | Entrenamiento de modelos de Apple | Applebot sigue rastreando para Siri, Spotlight y Safari |
Tienes la información completa (con los user-agent exactos y los rangos de IP) en la documentación oficial de OpenAI, Anthropic, Perplexity, Google y Apple.
GPTBot y OAI-SearchBot, aclaraciones importantes
Esta es una de las confusiones más habituales. Hay webs que bloquean GPTBot pensando que así se protegen de ChatGPT, y otras que lo bloquean todo y luego no entienden por qué no aparecen. La documentación de OpenAI lo deja claro: cada bot se configura por separado. GPTBot controla el entrenamiento; OAI-SearchBot controla la búsqueda. Y sobre este último dice: «Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers». En pocas palabras: si bloqueas OAI-SearchBot, tu web no aparece en las respuestas de búsqueda de ChatGPT (como mucho, puede salir como enlace de navegación).
OpenAI también indica que un cambio en el robots.txt puede tardar unas 24 horas en reflejarse en la búsqueda.
Con Google pasa algo parecido, en sentido contrario. Google-Extended no controla los AI Overviews ni el AI Mode. Según su documentación sobre funciones de IA, eso se controla con Googlebot en el robots.txt y con nosnippet, data-nosnippet, max-snippet o noindex. Bloquear Google-Extended no te saca de los AI Overviews, y bloquear Googlebot te saca de Google entero.
Decide a quién dejas pasar
No hay una configuración correcta para todo el mundo. Un medio que vive de su contenido puede querer cerrar el entrenamiento; una marca que quiere que la IA la recomiende suele querer lo contrario. Lo que sí tiene sentido en casi cualquier proyecto es separar búsqueda de entrenamiento y decidirlo de forma consciente. Un ejemplo para quien quiere salir en las respuestas pero no ceder su contenido para entrenar:
# Búsqueda: pueden citarte en sus respuestas
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

# Entrenamiento: no ceder el contenido
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /
Si prefieres estar también en la capa de memoria de los próximos modelos, basta con dejar abiertos los de entrenamiento. Lo importante es que esa decisión la tomes tú de forma consciente.
Revisa también un clásico de las migraciones, el User-agent: * con Disallow: / del entorno de pruebas que acaba subido a producción. Si acabas de cambiar de web, es lo primero que tienes que mirar (tienes más puntos de control en mi checklist de migración SEO).
3. No escondas el contenido importante detrás de JavaScript
Este es un bloqueo muy importante porque es difícil de averiguar y de predecir. Al final, el bot entra y la página responde con un 200. El problema es que, como no es capaz de ejecutar JavaScript, no ve el contenido y la página le llega vacía. Sin embargo, tú sí ves en los logs del servidor que hay bots de IA entrando en tu web, y el problema es ese: que no están encontrando información relevante.
Renderizar JavaScript cuesta muchos recursos, y hoy los rastreadores de IA, en su mayoría, no lo hacen. El dato más citado es el análisis de Vercel y MERJ (diciembre de 2024) sobre el tráfico de su red: ninguno de los grandes rastreadores de IA que analizaron ejecutaba JavaScript. Ni GPTBot, ni OAI-SearchBot, ni ChatGPT-User, ni ClaudeBot, ni PerplexityBot. Descargan ficheros JS (un 11,5 % de las peticiones de ChatGPT y un 23,8 % de las de Claude eran JavaScript), pero no los ejecutan. La excepción es Gemini, que tira de la infraestructura de Googlebot y sí renderiza.
Bing, que alimenta a Copilot, lo incluye en sus directrices para webmasters entre las cosas a evitar: esconder contenido importante detrás del renderizado en cliente.
Funcionalidades de JS comunes y que pueden ser un problema
No hace falta tener una web hecha al 100 % con un framework de JavaScript para tener el problema. Lo habitual es que falle en piezas concretas:
- Precios y especificaciones que se cargan con una llamada después de pintar la página. Si solo viven en JavaScript, para la IA tu producto no tiene precio.
- Acordeones y pestañas cuyo contenido no está en el HTML hasta que alguien hace clic.
- Scroll infinito y filtros que cargan los resultados bajo demanda.
- Contenido oculto con estilos o aplazado: bloques con
opacity:0odisplay:noneque el JavaScript revela después, o contenido personalizado que depende del usuario.
Cómo comprobarlo
Abre el código fuente de la página (view-source: en Chrome; el inspector enseña el DOM ya renderizado y para esto no te sirve) y busca tus precios, tus especificaciones o el texto de tus acordeones. También puedes desactivar JavaScript en el navegador o pedir la página con curl. Lo que no aparezca ahí, para la mayoría de los bots de IA no existe.
Si quieres revisarlo en toda la web a la vez, Screaming Frog te saca el porcentaje de texto que carga JavaScript en cada URL. Te enseño cómo, paso a paso y con capturas, en el tutorial para descubrir el % de JavaScript de tu contenido con Screaming Frog.
La solución pasa por servir el contenido clave en el HTML inicial, ya sea con renderizado en servidor o prescindiendo de JavaScript para esas piezas. Si quieres profundizar en las diferencias, lo explico en el artículo sobre SSR vs CSR.
4. No te fíes solo de los simuladores: mira los logs del servidor
Para saber si los bots de IA te visitan hay dos tipos de herramientas.
Los simuladores, como el de Dejan o el de technicalseo.com, hacen un análisis sin datos reales. Normalmente se limitan a leer tu robots.txt y decirte qué bots están bloqueados. Sirven para una primera revisión, pero no ven un bloqueo de firewall ni te dicen si el bot ha venido de verdad.
Los logs del servidor sí te cuentan lo que ha pasado: quién entró, cuándo, a qué páginas y qué respuesta recibió. Una línea de log de GPTBot tiene esta pinta (la IP y la URL son de ejemplo; el user-agent es el oficial de OpenAI):
203.0.113.10 - - [13/Sep/2026:10:12:01 +0000] "GET /blog/articulo/ HTTP/1.1" 200 18432 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"Qué buscar en los logs
- Si aparecen los bots que te interesan. Filtra por user-agent (OAI-SearchBot, Claude-SearchBot, PerplexityBot, ChatGPT-User…) y mira la tendencia.
- Qué códigos de respuesta reciben. Muchos 403 son un bloqueo de servidor; muchos 5xx, un problema de capacidad.
- A qué URLs van. En el análisis de Vercel, alrededor de un 34 % de las peticiones de ChatGPT y de Claude acababan en un 404, frente al 8 % de Googlebot. Revisa si piden URLs antiguas y si tus redirecciones están en orden.
- Si el bot es quien dice ser. El user-agent se puede falsificar. Cruza la IP con los rangos que publica cada plataforma, o usa la verificación por DNS inverso que Google documenta para Googlebot y que Apple y Common Crawl también ofrecen.
Si tu web está detrás de Cloudflare, el panel de AI Crawl Control te enseña las peticiones por rastreador, cuántas se han permitido y cuántas han fallado, sin tener que pelearte con los ficheros de log.
5. No dejes el sitemap desactualizado
La frescura pesa en las respuestas de la IA. Ahrefs analizó cerca de 17 millones de citas y encontró que los asistentes de IA citan contenido un 25,7 % más reciente que el que aparece en los resultados orgánicos, con ChatGPT como el que cita las páginas más nuevas. Es una correlación, y la edad media de lo citado sigue siendo de casi tres años, pero apunta en la misma dirección que lo que dicen los buscadores.
Un sitemap al día es la forma más limpia de avisar de cada cambio:
- Bing dice que el
lastmodsigue siendo una señal clave para priorizar qué URLs vuelve a rastrear, y que ignorachangefreqypriority. También recomienda IndexNow para avisar al momento, y en sus directrices lo relaciona con evitar URLs desactualizadas en las respuestas de Copilot. - Google usa el
lastmodsi es fiable de forma consistente, e ignora igualmentepriorityychangefreq.
Donde sí conviene tener cuidado es en poner en el lastmod la fecha en la que se generó el sitemap, o cambiar fechas sin cambiar el contenido. Bing lo desaconseja de forma explícita, y Google deja de fiarse de ese dato. Sobre IndexNow, un apunte: lo usan Bing, Yandex, Naver, Seznam y Yep, pero OpenAI no aparece entre los participantes, así que no hay nada oficial que diga que ayuda a salir en ChatGPT.
Sobre el famoso llms.txt
Antes de dedicarle horas a un llms.txt, revisa todo lo anterior. Google lo dice en su guía de optimización para IA: no necesitas crear ficheros nuevos para máquinas, ficheros de texto para IA ni Markdown para aparecer en Google Search, funciones de IA incluidas, porque su buscador no los usa. Añade que no pasa nada si lo creas para otros servicios, pero OpenAI, Anthropic y Perplexity no han confirmado que lo lean al rastrear.
Los agentes también tienen que poder operar en tu web
Todo lo anterior va de que la IA pueda leer tu web. Pero cada vez hay más agentes que entran para hacer algo: comparar, rellenar un formulario, pedir presupuesto. OpenAI, por ejemplo, ya firma las peticiones de su agente con Web Bot Auth para que los sitios puedan identificarlo, y Cloudflare trata a los agentes como una categoría separada de la búsqueda y del entrenamiento.
A esto se le empieza a llamar agent readiness. Puedes comprobar si los agentes acceden a tu web y pueden operar en ella con el Agent-Ready Scanner de Clicandseo, y si quieres ir un paso más allá, en el artículo sobre WebMCP te cuento cómo declarar qué acciones pueden ejecutar en tu web.
Preguntas frecuentes sobre los bots de IA y tu web
¿Si bloqueo GPTBot dejo de aparecer en ChatGPT?
No, si bloqueas GPTBot no dejas de aparecer en ChatGPT. GPTBot es el bot de entrenamiento de OpenAI, y las respuestas de búsqueda de ChatGPT dependen de OAI-SearchBot, que se configura por separado. Si bloqueas OAI-SearchBot, tu web deja de mostrarse en esas respuestas.
¿Bloquear Google-Extended me quita de los AI Overviews?
No, bloquear Google-Extended no te quita de los AI Overviews. Google-Extended controla el uso de tu contenido para entrenar Gemini y para el grounding en Gemini y Vertex AI. Los AI Overviews y el AI Mode dependen de Googlebot y se limitan con nosnippet, data-nosnippet, max-snippet o noindex.
¿Los bots de IA respetan el robots.txt?
Sí, los bots de IA de entrenamiento y de búsqueda de OpenAI, Anthropic, Perplexity y Google dicen respetar el robots.txt. Con los que visitan una página a petición de un usuario cambia: OpenAI avisa de que el robots.txt puede no aplicarse a ChatGPT-User y Perplexity dice que Perplexity-User en general lo ignora. Anthropic afirma que sus bots, incluido Claude-User, sí lo respetan.
¿Los bots de IA leen el contenido que carga con JavaScript?
No, la mayoría de los bots de IA no leen el contenido que carga con JavaScript. Según el análisis de Vercel, GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot y PerplexityBot no ejecutan JavaScript. Gemini sí, porque usa la infraestructura de Googlebot. Lo que no esté en el HTML inicial tiene muchas menos posibilidades de ser leído.
¿Cómo sé si ChatGPT visita mi web?
Sabes si ChatGPT visita tu web mirando los logs del servidor y filtrando por los user-agent de OpenAI (OAI-SearchBot, ChatGPT-User y GPTBot). Para confirmar que la visita es legítima, cruza la IP con los rangos que OpenAI publica en sus ficheros JSON. Si usas Cloudflare, el panel de AI Crawl Control te lo muestra por rastreador.
¿Cloudflare bloquea a ChatGPT por defecto?
Sí, Cloudflare bloquea por defecto parte de los bots de ChatGPT en los dominios nuevos a partir del 15 de septiembre de 2026: el entrenamiento y los agentes, en las páginas con anuncios, mientras que la búsqueda queda permitida. En los dominios que ya tenías depende de cómo lo configuraste, y si tienes activado el bloqueo de entrenamiento, revisa también el impacto en rastreadores mixtos como Googlebot o Bingbot. Cloudflare rectificó ese comportamiento y ahora deja frenar el entrenamiento de IA sin sacar a Googlebot.
¿Necesito un llms.txt para aparecer en ChatGPT?
No, no necesitas un llms.txt para aparecer en ChatGPT. OpenAI no ha confirmado que lo use al rastrear, y Google dice que su buscador no lo utiliza. Es mucho más rentable asegurarte antes de que los bots pueden acceder a tu web y leer tu contenido en el HTML.
Cuando los bots ya pueden leer tu web, el siguiente paso es trabajar el resto de factores. Los tienes en la guía de estrategias para aparecer en ChatGPT.
Si has revisado todo esto y sigues sin tener claro qué está pasando con los bots de IA en tu web, escríbeme y lo vemos juntos.