Un pasaje de 20 a 30 palabras y una petición de coincidencia exacta
Green publicó el método en su Substack el 13 de septiembre de 2026 y lo republicó él mismo, firmado como colaborador, en Search Engine Journal el 18. El punto de partida es una carencia concreta: para la búsqueda clásica siempre hemos tenido el operador site: y la búsqueda de un fragmento entrecomillado para comprobar si una página está indexada sin abrir Search Console. En búsqueda con IA no existe ningún equivalente a la inspección de URL, y el procedimiento nace para tapar ese hueco.
El paso a paso es corto. Se coge de la página un pasaje distintivo de 20 a 30 palabras, entendiendo por distintivo que lleve nombres propios, cifras o afirmaciones concretas, nunca copy de marketing genérico. Se pega en el chatbot pidiendo coincidencia exacta. Si el resultado no queda claro, Green recomienda repetir la prueba cuatro o cinco veces y, para mayor certeza, cambiar también de pasaje. Los motores donde lo prueba son ChatGPT, Claude y Gemini.
La plantilla de prompt que escribe en el post es «Search a for "paste your snippet here" and return any results which contain that exact text only», con la errata incluida. Conviene saber que la captura que acompaña al artículo usa otra redacción: ahí el prompt es la palabra Search, el pasaje entrecomillado y, debajo, «and return only urls with content that exactly matches». El pasaje de la demo tiene unas 27 palabras y ChatGPT responde con una sola URL, la del propio Green.
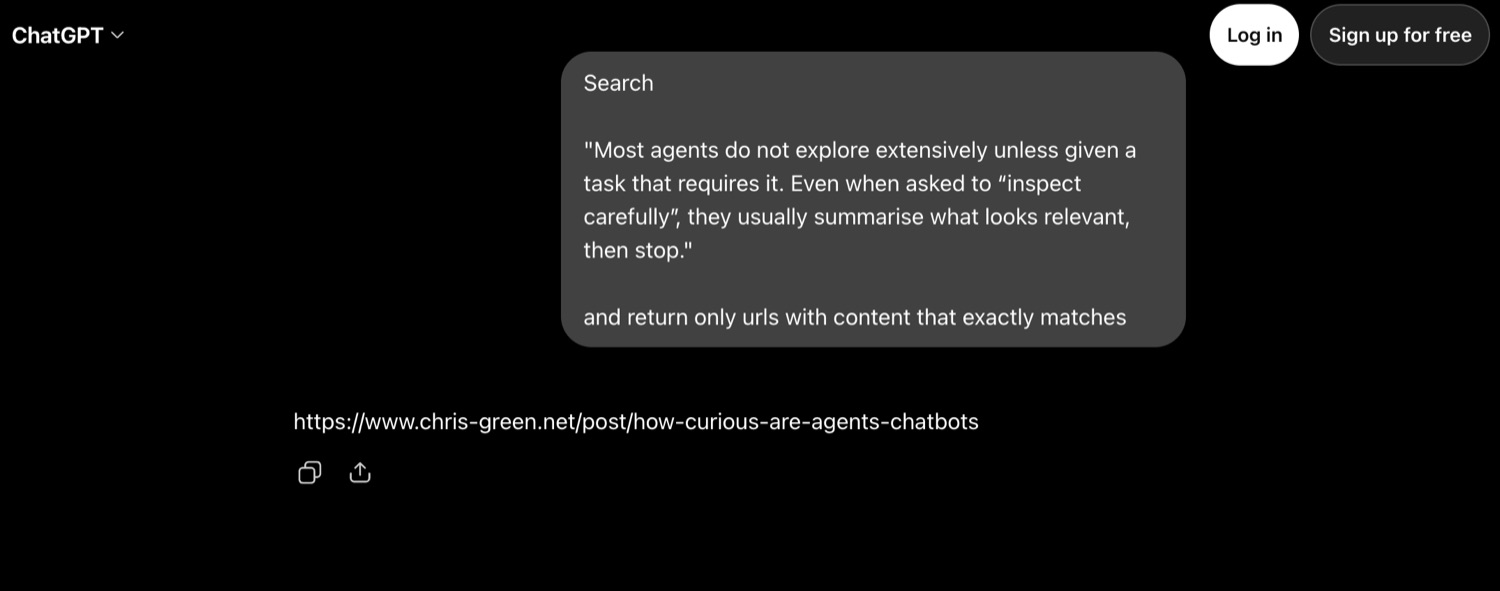
La lectura del resultado positivo la formula en tres pasos. Que la fuente de búsqueda que el motor usó contenía ese contenido, que «that content was correctly attributed to that URL», y que por tanto, desde el punto de vista técnico, esa página es apta para búsqueda. Si la URL no vuelve, lo que ofrece no es un diagnóstico sino una lista de sospechosos de SEO técnico de toda la vida: si la página es descubrible (enlazada o en sitemap), si es accesible (que no la esté frenando el WAF o el robots.txt), si se puede rastrear (que el texto se renderice y se extraiga), si es indexable (noindex, canonical apuntando a otro sitio) y si el contenido merece estar indexado.
Lo único que mide es la primera barrera
El test responde a una sola pregunta: si el contenido de esa URL está presente y correctamente atribuido en la fuente de búsqueda que el chatbot consultó en esa ejecución concreta. Es binario y no dice nada más. Green dedica un epígrafe entero a adelantarse a la objeción, y lo titula con ella: «My page is returned this way, but it isn't "ranking" in AI or driving traffic!».
Su respuesta es que eso es un problema distinto y que no ha intentado resolverlo aquí: «This guide is more about ensuring the first hurdle (retrieval) isn't catching you out». Y añade qué toca mirar cuando el test sale bien y aun así no hay citación ni tráfico, que es la autoridad que tienes en ese terreno y lo útil que resulta tu contenido frente a la competencia.
Las limitaciones que el propio autor pone por escrito
Esta es la parte que conviene leer antes de montar nada encima. Green avisa de que ChatGPT tira de fuentes distintas según la ejecución y de que es posible que solo consulte una de las disponibles, que es justo el motivo de repetir la prueba cuatro o cinco veces y de cambiar de pasaje.
Va más lejos y desactiva cualquier tentación de tratar el resultado como verdad: «This "workaround" is not a straight-out replacement and AI Chatbot responses are not "truth" - so you need to interpret the output». Reconoce además dos falsos negativos previsibles. Uno, que el pasaje elegido sea demasiado genérico y no baste para destacar en los resultados que el chatbot está usando. Y dos, el retardo de siempre: que la página no se haya descubierto todavía o esté descubierta y aún sin indexar. Sobre eso el consejo es tener paciencia. Deja dicho también que con acceso a Search Console, a Bing Webmaster Tools o a los logs del servidor el diagnóstico es superior.
Hay una limitación más que no aparece en el post y que conviene tener presente al interpretarlo, porque cambia lo que puedes concluir. La búsqueda de estos asistentes se apoya en índices de terceros, así que un positivo demuestra que ese índice tiene tu contenido, no que el rastreador propio del fabricante haya pasado por tu web. Son dos cosas que se confunden con facilidad y que se arreglan de forma distinta.
Exactly Matchy, la extensión que elige los pasajes por ti
La herramienta se llama «Exactly Matchy» y el repositorio se creó el 13 de septiembre, once minutos antes de que se publicara el post. Lee la página renderizada, extrae encabezados, párrafos y listas visibles, descarta el boilerplate (navegación, banners de cookies, pies de página), localiza pasajes de 20 a 30 palabras y convierte cada uno en un enlace de un clic a ChatGPT, Claude y Gemini. Para ordenar los candidatos usa la Prompt API en local de Chrome, no para reescribirlos, y si no está disponible cae en un sistema de puntuación determinista. Con Gemini necesita un content script propio porque no admite rellenar el prompt por parámetro.
Antes de instalarla hay varias cosas que pesan. Es solo para Chrome, es gratuita y no está en la Chrome Web Store: hay que descargarla y cargarla sin empaquetar en modo desarrollador. He comprobado el repositorio y a día de hoy está a cero estrellas y cero forks, el último push es del mismo 13 de septiembre y no tiene fichero de licencia, así que hablando con propiedad es código a la vista, no software libre con una licencia detrás.
El propio Green es el primero en decirlo, y lo dice sin rodeos. Llama a lo suyo una «vibe-extension» y avisa: «Add in extensions like this at your own risk… it's the internet equivalent of taking candy from a stranger. Review the code, make sure you're happy before diving head-first». Una extensión que lee la página renderizada pide permisos serios, así que el aviso del autor hay que tomárselo literal. El método a mano funciona igual sin instalar nada.
Por qué separar recuperación de citación cambia el diagnóstico
La distinción que sostiene todo esto tiene respaldo cuantitativo. El informe de AirOps sobre la influencia de la recuperación, el fan-out y las SERP de Google en las citas de ChatGPT, publicado en marzo de 2026, trabajó sobre 548.534 páginas recuperadas a partir de 15.000 prompts originales y 43.233 consultas. Su resultado es que solo el 15% de las páginas recuperadas acaba citada, y el informe lo resume diciendo que ser recuperado es únicamente el primer paso hacia la visibilidad en citas.
Puesto en términos de trabajo, son dos averías con dos responsables distintos. Que no te recuperen es un problema de acceso e infraestructura: descubrimiento, bloqueos en el WAF o en el robots.txt, renderizado, noindex, canonicals mal puestas. Tiene solución determinista y se arregla en SEO técnico. Que te recuperen y no te citen es un problema de contenido, entidad y autoridad relativa, es competitivo y probabilístico, y va por el lado del information gain. Mezclarlas en una sola métrica es lo que lleva a reescribir contenido durante meses cuando lo que había era un firewall bloqueando al fetcher.
En ese primer nivel hay un detalle que se cuela a menudo en las auditorías: el rastreador de entrenamiento y el de búsqueda son bots distintos. En OpenAI, GPTBot es el de entrenamiento y OAI-SearchBot el que alimenta la búsqueda; en Google, Google-Extended controla Gemini y Vertex y no afecta ni al rastreo de Googlebot ni al ranking en Búsqueda. Bloquear uno creyendo que bloqueas el otro es un clásico. Y conviene no confiar en llms.txt como comprobación de nada, porque Google ha dicho expresamente que no lo usa. Sobre qué sí mueve la aguja aquí, lo tengo desarrollado en Cómo aparecer en ChatGPT.
Mi lectura
Lo bueno del test de Green es que no promete de más. Él lo llama apaño y apaño es, pero contesta a una pregunta que en la mayoría de informes de visibilidad en IA se responde a ojo, que es si el motor puede encontrarte siquiera. Y ojo, porque no es lo mismo que no te encuentre a que te encuentre y no te elija. Si es lo primero, las causas habituales las tienes contadas una a una en Cosas que NO hacer si quieres aparecer en ChatGPT.
Con esta extensión deberías tener cuidado y no tomar nada como real al 100%. Lo dice él mismo, el código es vibecodeado, sin licencia y fuera de la store. Hacerlo a mano es gratis y rápido y te puede servir.
Donde se queda corto es en la escala. Un pasaje, un motor, una ejecución, y encima repitiendo cuatro o cinco veces porque el resultado baila. Eso no lo mantiene nadie más allá de una comprobación suelta. Aquí barro para casa. En Clicandseo lo cogemos por el otro lado, con el query fan-out en bulk, que te saca las consultas que abre el motor y las URLs que consulta de verdad para decenas de prompts a la vez. Contesta a lo mismo que Green, en bulk, con mucha más información, más sólido y escalable y además, trae la capa de citación.